Содержание
Курс «Обучаем CNN и CRNN с нуля» для тех, кто пишет на Python и хочет сам собрать чтение рукописных цифр в клетке бланка. Хватит открыть терминал, создать окружение и запустить файл .py. Формулы свёрток и сборка строки из колонок появятся в том уроке, где без них не сделать следующий шаг. Считать можно на процессоре: видеокарта ускорит поздние прогоны, но без неё серия не останавливается.
К концу серии код умеет две вещи и умеет поставить их друг за другом. Первое — не потерять заполненную клетку: на скане часть полей пустая, часть содержит значение вроде 7,3 или 12/14, и пустое нельзя перепутать с написанным. Второе — прочитать эту строку, не размечая вручную, где стоит каждая цифра. Сначала модель смотрит, есть ли в клетке что читать. Потом вторая читает символы. Такую связку называют каскадом.
Такие сети ставят на узкий вопрос и уже вырезанную картинку. Клетка бланка с измерением вроде 7,3, диаметр 12/14, толщина 1,5-2, галочка в анкете: алфавит короткий, сетка клеток известна заранее, смотреть нужно в один квадратик.
Польза этого размера конкретная. Обучение идёт быстро: на вход приходит кроп одной клетки, слоёв мало, и учебные прогоны серии рассчитаны на процессор. Ответ на клетку считается там же, на маломощной машине, где лежат сканы, и пачка бланков проходит клетка за клеткой. Сторож отсекает пустые поля сразу, и читатель строки включается только там, где есть штрих. Если изменились бланк или почерк, а в клетках по-прежнему цифры, старую сеть дообучают на новых кропах.
До каскада ещё несколько шагов. Сначала — карта курса и способ повторить вчерашний запуск с тем же результатом. Потом картинка станет таблицей чисел, появится список символов, которые мы умеем читать, и учебные примеры. Дальше — крошечная сеть, которая отличает пустую клетку от заполненной, граница, после которой клетка считается заполненной, чтение строки и соединение двух моделей. Сегодня берём только начало: куда идём и на каком столе будем сравнивать эксперименты.
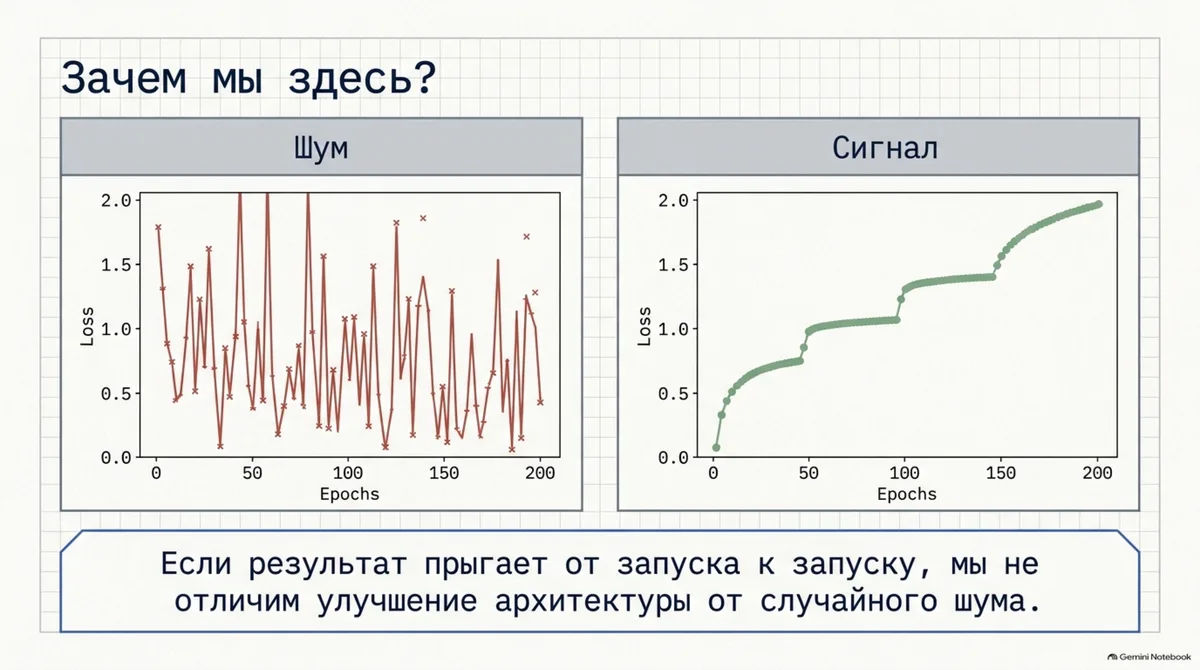
Вчера loss был лучше. Сегодня — с тем же кодом — хуже. Часто виноват не алгоритм, а случайность, которую забыли зафиксировать: веса стартовали иначе, данные перемешались иначе, и сравнение аугментаций превратилось в лотерею. Этот урок модель не учит. Он отвечает на два вопроса: что вообще за сети CNN и CRNN в этой серии, и как поставить стол так, чтобы завтрашний запуск можно было честно сравнить со вчерашним.
Зерно (seed) — зачем оно нужно уже сейчас
Компьютер не бросает кости «из воздуха». У него есть генератор псевдослучайных чисел: длинная, но полностью определённая последовательность. Зерно (seed) — стартовая точка в этой последовательности. Одно и то же зерно → те же «случайные» числа → те же начальные веса сети, тот же порядок примеров при перемешивании. Другое зерно → другая траектория. Без зафиксированного зерна два запуска одного скрипта сравнивать нельзя: вы сравниваете не код и не архитектуру, а разные вытягивания из генератора.
Дальше по тексту «seed» и «зерно» — одно и то же. В коде параметр почти всегда называется seed; в речи курса чаще говорим «зерно».
К концу урока у вас будут: ясная картина, зачем две разные сети; виртуальное окружение; скрипт версий и устройства; и проверка, что одно зерно даёт побитово одинаковые веса.
Что такое CNN и CRNN
Задача курса прозаическая: на скане бланка есть клетки. Часть пустая, часть заполнена рукописным значением вроде 7,3 или 12/14. Нужно не потерять заполненные и прочитать строку, не размечая вручную, где на кропе стоит каждая цифра.
Одной «универсальной» сети на всё это обычно не хватает. Мы собираем каскад из двух ролей.
CNN (свёрточная нейросеть, Convolutional Neural Network) смотрит на картинку как на сетку пикселей. Фильтр небольшого окна скользит по плоскости и ищет локальные признаки: штрих, угол, пятно «чернил», пустое поле. Одни и те же веса фильтра работают во всех местах кадра — поэтому сеть не учит отдельно «семёрку слева» и «семёрку справа». Несколько слоёв складывают простые признаки в более сложные. В этой серии первая настоящая CNN — крошечный детектор пустых клеток: на вход кроп, на выход «пусто / не пусто» (уроки 7–9). Это не чтение текста, а сторож: «сюда вообще стоит звать читателя?».
CRNN (свёрточно-рекуррентная нейросеть, Convolutional Recurrent Neural Network) нужна, когда ответ — последовательность переменной длины, а не один класс. Свёрточная часть снова вытаскивает признаки с картинки, но результат режут на колонки вдоль строки (временные шаги). Дальше рекуррентный блок (или его современный аналог) смотрит на эти колонки по порядку: слева направо, как глаз по цифрам. На каждом шаге получается распределение по символам алфавита плюс служебный blank. Как из этого собрать строку без разметки «эта колонка — семёрка» — тема CTC (связная временная классификация, Connectionist Temporal Classification) (урок 10); сама CRNN появится чуть позже. Итого: CNN отвечает «есть ли что читать», CRNN — «что именно написано».
Почему не отдать всё одной сети с первого дня? Пустая клетка и заполненная — разные режимы ошибки. Принять значение за пустое значит потерять данные. Прочитать лишнюю пустую — почти бесплатно: дальше её всё равно отсеет чтение или формат. Поэтому сначала учим сторожа с жёстким ограничением на полноту по значениям, а уже потом — читателя строк. Каскад делает цену ошибок явной.
Грубая карта курса (имена — ориентир, не расписание на сегодня):
| Этап | Что появляется | Роль |
|---|---|---|
| Уроки 1–3 | лаборатория, тензор, алфавит | стол и контракт меток |
| Уроки 4–6 | синтетика, сплит, датасет | данные без утечки |
| Уроки 7–9 | Tiny CNN, порог, рецепт | детектор (CNN) |
| Уроки 10+ | CTC, затем CRNN | читатель строки |
| Ближе к концу | связка двух моделей | каскад «сторож → читатель» |
Сегодня из этой таблицы берём только первую строку — лабораторию: рабочее окружение и воспроизводимость. Сетей, данных и порогов ещё не будет. Зато появится ответ на вопрос, можно ли вообще доверять завтрашнему запуску.
Дальше по курсу мы будем сравнивать варианты: разные аугментации, разные пороги, с балансом классов и без, Tiny CNN против базовых правил. Если зерно каждый раз другое (или его «забыли»), «лучшая» конфигурация может оказаться просто удачным стартом генератора. Тогда вы примете шум за пользу свёрточной сети — или, наоборот, отбросите рабочий приём, потому что один прогон «не взлетел». Фиксация окружения и зерна не учит читать цифры; она делает последующие сравнения честными.
Файлы урока
Их ещё нет у вас на диске — сегодня вы их наберёте. На схеме четыре опоры. Верхняя балка — обещание урока: один и тот же запуск завтра даёт тот же результат. Каждая колонна отвечает на свой вопрос; если убрать одну, балка не держится.
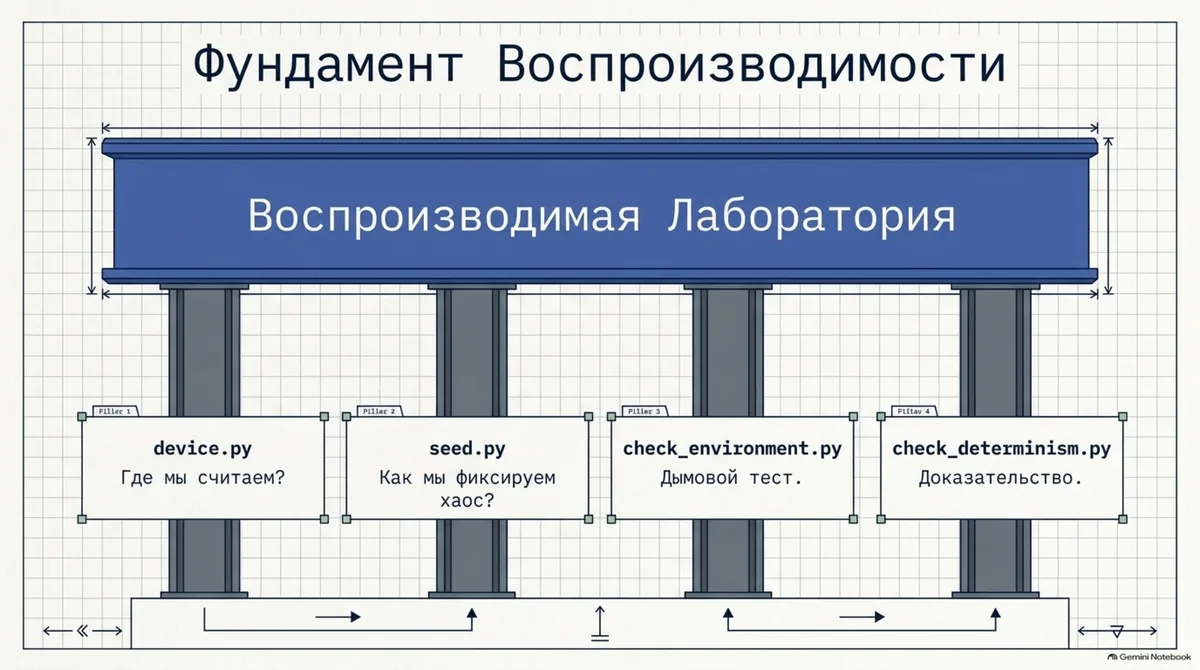
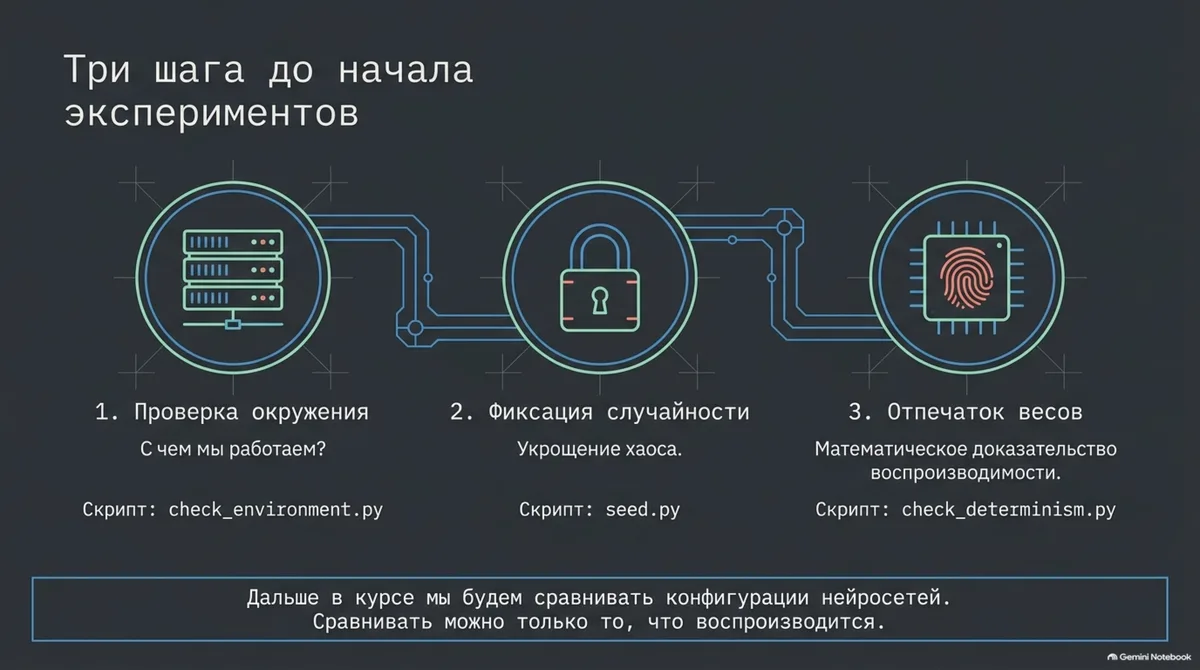
device.py— где мы считаем. Видеокарта NVIDIA, ускоритель Mac или процессор. Без этого «у меня медленно» и «у меня другие числа» не с чем связать.seed.py— как фиксируем хаос. Выставляет одно зерно сразу в Python, NumPy и PyTorch, чтобы веса и перемешивание не гуляли сами по себе.check_environment.py— дымовой тест. Печатает версии и устройство и делает один расчёт. Если он молчит или падает, дальше учиться нечему.check_determinism.py— доказательство. Два запуска с одним зерном дают один отпечаток весов. Это не «нам кажется, что всё стабильно», а проверка.
Пятый файл на схеме не колонна, а пол: requirements.txt со списком зависимостей (torch, numpy, Pillow, matplotlib, pyyaml, pytest). Без него опоры просто не из чего собрать.
Эталон, если файл не заводится: тег lesson-01. Клонировать его не нужно.
Предскажи
Раздел «Предскажи» — не тест и не оценка. Перед командой вы фиксируете ожидание: какое устройство увидите, совпадут ли отпечатки весов, что будет, если зерно задать один раз и не обновлять. После запуска сравниваете прогноз с терминалом. Совпало — убеждение стало фактом. Разошлось — это и есть урок: вы видите, где интуиция про железо или случайность ошибалась, а не просто пролистываете вывод.
Перед запуском запишите ответы (на бумаге или в заметках):
- Какое устройство напечатает
check_environment.pyна вашем компьютере:cpu,cudaилиmps? - Мы дважды обучим одну и ту же крошечную модель с одним и тем же зерном. Совпадут ли «отпечатки» весов?
- А если один раз вызвать
set_seedи дальше не переустанавливать зерно между двумя обучениями?
Установка
Код курса вы пишете сами и храните в своём репозитории. Чужой репозиторий с готовыми файлами клонировать не нужно. Эталон lesson-01 открывайте в браузере только если уже набрали файл и что-то не сходится. Опечатки и красные импорты — часть урока.
Создайте папку и репозиторий, затем отдельное окружение:
mkdir cnn-crnn-from-scratch
cd cnn-crnn-from-scratch
git init

python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
Наберите requirements.txt:
torch>=2.2
numpy>=1.26
Pillow>=10.0
matplotlib>=3.8
pyyaml>=6.0
pytest>=8.0И .gitignore, чтобы в коммит не попали окружение и сгенерированные данные:
.venv/
__pycache__/
.pytest_cache/
data/Дальше поставьте зависимости:
pip install -r requirements.txtСборку PyTorch при необходимости берите со страницы PyTorch. Курс рассчитан так, чтобы хватало процессора.
Проверьте, что python смотрит в проект (в начале строки терминала обычно видно (.venv)):
which python
python -c "import torch; print(torch.__version__)"
Пример на macOS:
/Users/you/cnn-crnn-from-scratch/.venv/bin/python
2.14.1
На Windows вместо which python — where python. В пути должна быть папка .venv проекта. Если путь системный, окружение не активировано: пакеты уйдут не туда.
Код: печатаем руками
Ниже — текст файлов для набора в ваш репозиторий. Пишите самостоятельно. Если файл не работает, сверьтесь с тегом lesson-01 в браузере.
1. Выбор устройства
В PyTorch тензоры и вычисления живут на устройстве (device): процессор или ускоритель. Одна и та же формула на разных устройствах даёт тот же смысл, но разную скорость и иногда разный «шум» (на GPU часть операций бывает недетерминированной). Поэтому в лаборатории мы явно спрашиваем: где сейчас считаем — и печатаем ответ в дымовом тесте. Иначе фразы «у меня медленно» и «у меня другие числа» не к чему привязать.
Три варианта, которые умеет наш курс:
| Имя в коде | Что это | Когда бывает |
|---|---|---|
cuda |
GPU NVIDIA через CUDA (Compute Unified Device Architecture) | Есть карта NVIDIA, драйвер и сборка PyTorch с CUDA |
mps |
ускоритель Apple через MPS (Metal Performance Shaders) | Mac на Apple Silicon и PyTorch с поддержкой Metal |
cpu |
обычный процессор | Всегда доступен; запасной и основной путь курса |
Порядок в функции — не «лучше → хуже», а «сначала спросим про типичный ускоритель, иначе возьмём то, что точно есть». На схеме: сначала NVIDIA, потом Apple, иначе CPU.
Файл: src/device.py
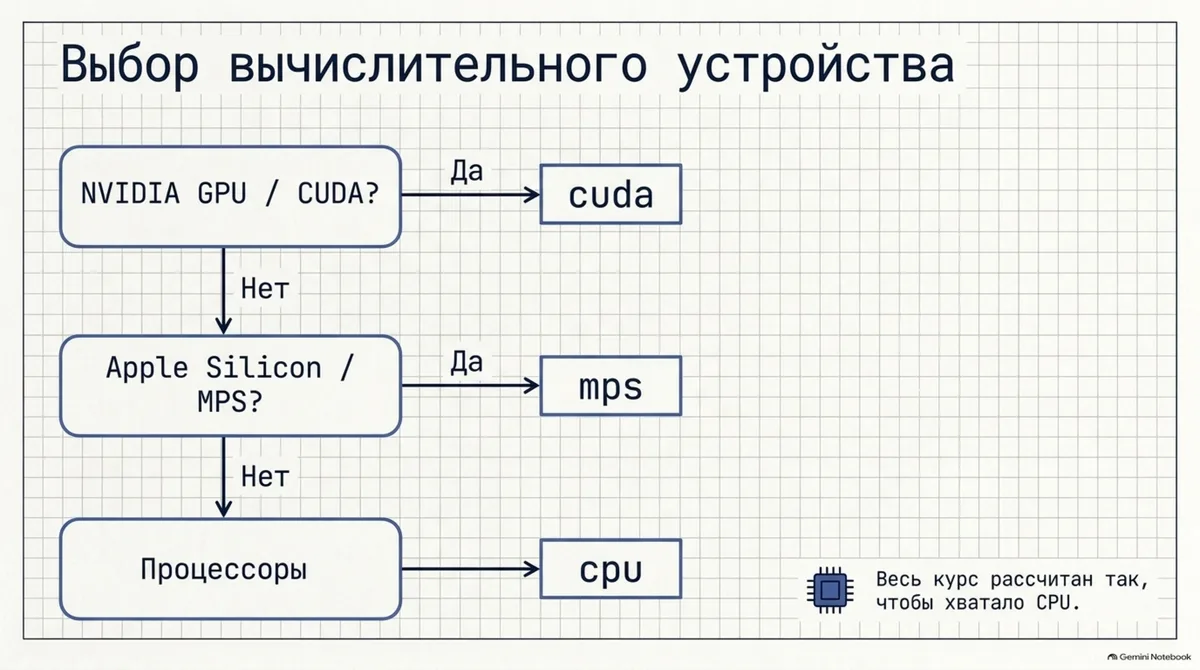
"""Выбор устройства для вычислений: cuda → mps → cpu."""
import torch
def pick_device() -> torch.device:
if torch.cuda.is_available():
return torch.device("cuda") # NVIDIA + работающий драйвер
mps = getattr(torch.backends, "mps", None) # Apple Silicon, если модуль есть
if mps is not None and mps.is_available():
return torch.device("mps") # ускорение Metal на Mac
return torch.device("cpu") # запасной путь: весь курс рассчитан на CPUРазбор по строкам:
torch.cuda.is_available()— не «есть ли чип NVIDIA в корпусе», а «PyTorch сейчас может на нём считать». Карта без драйвера или CPU-сборка пакета дадутFalse.getattr(torch.backends, "mps", None)— в старых версиях PyTorch модуляmpsможет не быть. Безgetattrкод упал бы сAttributeErrorна машине без Metal; с ним мы просто переходим дальше.mps.is_available()— Mac с Apple Silicon и рабочий бэкенд Metal.cpu— путь по умолчанию. Весь курс рассчитан так, чтобы хватало процессора: лаборатория, Tiny CNN и CTC на NumPy не требуют покупки видеокарты. Ускоритель пригодится позже на тяжёлых прогонах, но отсутствиеcuda/mps— не блокер.
Когда тензоры создают на одном устройстве, а операцию зовут на другом, PyTorch обычно ругается. Поэтому pick_device() вызывают один раз в начале скрипта и дальше передают результат (или кладут модель на это устройство). В уроке 1 мы только выбираем и печатаем; перенос сетей появится вместе с обучением.
2. Фиксируем зерно во всех библиотеках
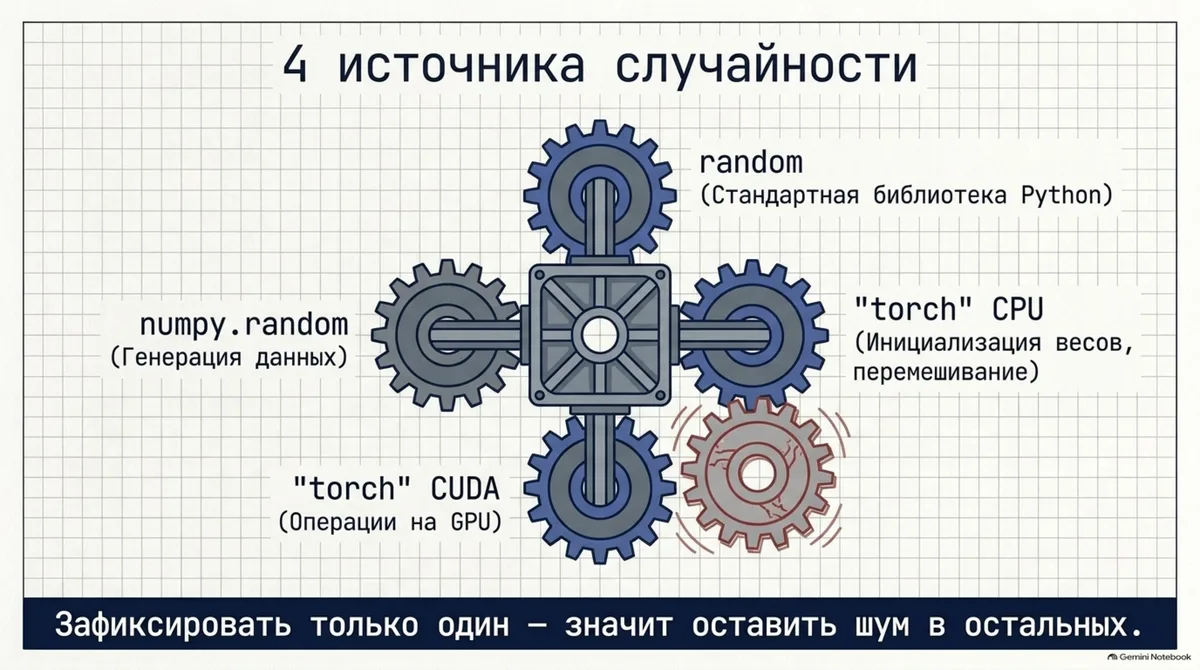
Идею зерна мы уже разобрали: это стартовая точка генератора псевдослучайных чисел. На практике в одном скрипте обучения таких генераторов несколько. Каждый живёт в своей библиотеке и помнит своё состояние. Если «посадить» только PyTorch, а NumPy оставить как есть, данные могут перемешаться иначе при том же torch.manual_seed(42). На схеме четыре шестерни: зафиксировали одну — в остальных остаётся шум.
Если случайность не зафиксировать, два запуска одного и того же файла — это два разных эксперимента. Код, данные и настройки те же, а результат другой:
- начальные веса другие → сеть идёт другой траекторией → после тех же эпох loss и точность отличаются;
- примеры попадают в батчи в другом порядке → шаги обучения другие;
- позже случайные искажения картинки и случайное выключение части признаков каждый раз меняют кадр и признаки по-новому.
На экране это выглядит как «вчера было 0.99, сегодня 0.96» без единой правки в коде. Сравнение «с аугментацией и без», «порог 0.5 и подобранный», «баланс классов и none» превращается в лотерею: победителем может оказаться удачный старт генератора, а не удачное решение. Проверка в конце урока как раз это показывает: забыли вызвать set_seed перед вторым прогоном — отпечаток весов уже другой.
Зачем вообще нужна случайность в обучении:
- Начальные веса сети. У каждого фильтра и слоя есть свои числа: на них умножаются пиксели и признаки. Перед первым шагом обучения сеть ещё ничего не видела, и правильные числа взять неоткуда. Нули тоже не ставят: все окна оказались бы одинаковыми, и штрих с пустым полем на старте не различались бы. Поэтому числа берут небольшими и случайными. От этого набора зависит, с какой траектории сеть стартует: те же примеры и то же число шагов, другое зерно — другие первые числа и другой путь обучения.
- Перемешивание примеров. Обучение идёт пачками (батчами): несколько кропов за раз. Порядок пачек часто случайный, чтобы модель не заучивала порядок файла.
- Аугментации (позже, урок 6) — случайные безопасные искажения картинки: чуть сдвинуть, чуть зашумить. Их тоже крутит генератор.
- Случайное выключение признаков (позже, урок 9) — на обучении сеть каждый раз отключает часть признаков. Это тоже случайность.
Одного вызова torch.manual_seed(42) мало: он трогает генератор PyTorch, но не модуль random из стандартной библиотеки Python и не numpy.random (NumPy — библиотека для массивов чисел; на ней часто делают данные и часть искажений). На видеокарте у PyTorch ещё отдельный генератор на каждое устройство CUDA — его чинит torch.cuda.manual_seed_all.
Файл: src/seed.py
"""Воспроизводимость: фиксируем все источники случайности."""
import os
import random
import numpy as np
import torch
def set_seed(seed: int = 42, deterministic: bool = False) -> None:
"""Фиксирует seed в Python, NumPy и PyTorch (CPU и CUDA).
deterministic=True просит PyTorch использовать только детерминированные
алгоритмы. На GPU это может замедлить обучение или бросить ошибку для
операций без детерминированной версии.
"""
random.seed(seed) # стандартная библиотека (аугментации позже)
np.random.seed(seed) # генерация данных и часть аугментаций
torch.manual_seed(seed) # веса, dropout, перемешивание на CPU
torch.cuda.manual_seed_all(seed) # без CUDA вызов безвреден
if deterministic:
# переменная должна быть задана до первой операции на CUDA
os.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:8")
torch.use_deterministic_algorithms(True) # только детерминированные алгоритмы
def make_generator(seed: int) -> torch.Generator:
"""Отдельный генератор для DataLoader(shuffle=True, generator=...)."""
g = torch.Generator()
g.manual_seed(seed) # свой генератор под перемешивание батчей
return g
def seed_worker(worker_id: int) -> None:
"""worker_init_fn для DataLoader: у каждого воркера свой, но воспроизводимый seed."""
worker_seed = torch.initial_seed() % 2**32 # уникальный, но воспроизводимый seed воркера
np.random.seed(worker_seed)
random.seed(worker_seed)Четыре источника, которые трогает set_seed (как на схеме):
| Источник | За что отвечает в курсе |
|---|---|
random |
стандартная библиотека Python; позже — часть аугментаций |
numpy.random |
генерация и подготовка чисел/данных |
torch на CPU |
начальные веса, dropout, перемешивание на процессоре |
torch на CUDA |
отдельный генератор на каждой видеокарте NVIDIA |
Если зафиксировать только один столбец таблицы, остальные продолжат вносить шум.
Две функции ниже set_seed пока не вызывайте — они понадобятся в уроке 6, когда появится загрузчик батчей (DataLoader): он режет датасет на пачки и может читать файлы в нескольких фоновых процессах (воркерах). У каждого воркера свой процесс и своё состояние генератора. make_generator отдаёт отдельный объект-генератор PyTorch под перемешивание пачек; seed_worker выставляет зерно внутри воркера так, чтобы оно было разным у разных процессов, но воспроизводимым от запуска к запуску. Сегодня достаточно набрать их рядом с set_seed, чтобы файл совпал с тегом.
Флаг deterministic=True — про другое, не про зерно. Даже при одном зерне PyTorch на GPU иногда выбирает быстрый, но недетерминированный алгоритм (тот же вход → чуть другие биты на выходе). «Детерминированный» здесь значит: просим библиотеку брать только варианты, где результат повторяется побитово. Это может быть медленнее или упасть, если для операции нет такого варианта. Переменная окружения CUBLAS_WORKSPACE_CONFIG нужна части CUDA-математики, чтобы детерминизм вообще включился; её задают до первой операции на видеокарте. В нашем курсе флаг по умолчанию выключен, а проверку воспроизводимости мы запускаем на CPU — так мы проверяем свой код фиксации зерна, а не драйвер конкретной карты.
3. Проверка окружения
Файл: src/check_environment.py
"""Проверка окружения: версии, устройство, один тензорный расчёт."""
import platform
from importlib.metadata import version
import numpy as np
import torch
from device import pick_device
def main() -> None:
device = pick_device() # cuda → mps → cpu
print(f"Python : {platform.python_version()}")
print(f"Platform : {platform.platform()}")
print(f"torch : {torch.__version__}")
print(f"numpy : {np.__version__}")
print(f"Pillow : {version('Pillow')}")
print(f"Device : {device}")
print(f"CPU threads : {torch.get_num_threads()}")
x = torch.randn(2, 3, device=device) # маленький тензор на выбранном устройстве
y = x @ x.T # матричное умножение: дымовой тест «устройство считает»
assert y.shape == (2, 2), "неожиданная форма результата"
print(f"Tensor OK : shape={tuple(x.shape)}, device={x.device}")
if __name__ == "__main__":
main()Скрипт делает одно: печатает, с чем вы работаете, и выполняет небольшое матричное умножение на выбранном устройстве. Если этот шаг упал, дальше идти нет смысла.
Запуск:
python src/check_environment.pyПример вывода в этом уроке (у вас будут свои Platform, Device и число потоков):
Python      : 3.14.0
Platform    : macOS-26.5.2-arm64-arm-64bit-Mach-O
torch       : 2.14.1
numpy       : 2.5.3
Pillow      : 12.3.0
Device      : mps
CPU threads : 4
Tensor OK   : shape=(2, 3), device=mps:0
Главные строки: Device (сверьте с прогнозом из «Предскажи») и Tensor OK — умножение на выбранном устройстве прошло. На машине без NVIDIA и без Apple Silicon будет Device: cpu и device=cpu — для курса этого достаточно.
4. Проверка воспроизводимости
Файл: experiments/check_determinism.py
"""Проверка воспроизводимости: один seed → одни и те же веса.
Считаем на CPU, чтобы не смешивать нашу проверку с недетерминизмом GPU.
"""
import argparse
import hashlib
import sys
from pathlib import Path
import torch
import torch.nn.functional as F
from torch import nn
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from seed import set_seed # noqa: E402
def weights_hash(model: nn.Module) -> str:
"""Короткий «отпечаток» всех весов модели."""
h = hashlib.sha256()
for p in model.parameters():
h.update(p.detach().cpu().numpy().tobytes()) # байты весов → в хэш
return h.hexdigest()[:12] # короткий отпечаток для печати
def train_tiny(steps: int, seed: int | None) -> tuple[str, float]:
"""Мини-обучение. seed=None: set_seed сознательно НЕ вызываем («забыл seed»)."""
if seed is not None:
set_seed(seed) # фиксируем все источники случайности
model = nn.Sequential(nn.Linear(16, 32), nn.ReLU(), nn.Linear(32, 2)) # крошечная сеть
opt = torch.optim.SGD(model.parameters(), lr=0.1)
x = torch.randn(256, 16) # синтетические признаки
y = (x[:, 0] > 0).long() # метка из знака первого признака
loss = torch.tensor(0.0)
for _ in range(steps):
opt.zero_grad()
loss = F.cross_entropy(model(x), y) # ошибка классификации
loss.backward()
opt.step()
return weights_hash(model), float(loss.detach())
def main() -> int:
ap = argparse.ArgumentParser()
ap.add_argument("--steps", type=int, default=50)
ap.add_argument("--seed", type=int, default=42)
ap.add_argument("--threads", type=int, default=None,
help="число потоков CPU (1 помогает, если хэши не совпали)")
args = ap.parse_args()
if args.threads:
torch.set_num_threads(args.threads) # на части CPU влияет на хэш
h1, l1 = train_tiny(args.steps, args.seed) # первый запуск с seed
h2, l2 = train_tiny(args.steps, args.seed) # тот же seed → отпечатки должны совпасть
h3, _ = train_tiny(args.steps, args.seed + 1) # другой seed → отпечаток другой
set_seed(args.seed) # один раз в начале...
h4, _ = train_tiny(args.steps, None) # ...и дальше «забываем» переустанавливать
h5, _ = train_tiny(args.steps, None) # генератор уже сдвинут → другой результат
same_ok = h1 == h2 and l1 == l2 # одинаковый seed → одинаковые веса и loss
diff_ok = h1 != h3 # разный seed → проверка не «мёртвая»
print(f"same seed ({args.seed}, {args.seed}) : {h1} {'==' if h1 == h2 else '!='} {h2} "
f"{'OK' if same_ok else 'FAIL'}")
print(f"different seed ({args.seed}, {args.seed + 1}) : {h1} {'!=' if diff_ok else '=='} {h3} "
f"{'OK' if diff_ok else 'FAIL'}")
print(f"forgot to reseed : {h4} {'!=' if h4 != h5 else '=='} {h5} (демо, не проверка)")
if same_ok and diff_ok:
print("determinism: OK (hash match)")
return 0
print("determinism: FAIL (см. раздел «Если не так» в уроке)")
return 1
if __name__ == "__main__":
sys.exit(main())Идея простая. Мы обучаем крошечную сеть на случайных данных и считаем «отпечаток» (хэш) всех её весов. Три эксперимента:
- Один seed, два запуска. Отпечатки обязаны совпасть. Если нет, воспроизводимость сломана, и дальше любые сравнения бессмысленны.
- Разные seed. Отпечатки обязаны различаться. Иначе проверка ничего не проверяет (например, seed вообще не влияет на результат).
- «Забыли переустановить seed». Мы вызываем
set_seedодин раз и запускаем обучение дважды подряд, не переустанавливая его. Второй запуск стартует с уже продвинувшегося состояния генератора и даёт другой результат. Это самая частая причина «вчера было лучше»: код тот же, а случайность другая.
Считаем на CPU намеренно: так мы проверяем свой код, а не недетерминизм конкретной видеокарты.
Запуск:
python experiments/check_determinism.pyПример вывода в этом уроке:
same seed (42, 42)      : 1415d3102ea2 == 1415d3102ea2   OK
different seed (42, 43) : 1415d3102ea2 != 8a6ef2f5d087   OK
forgot to reseed        : 1415d3102ea2 != 8ab8dc6618c1   (демо, не проверка)
determinism: OK (hash match)
Читайте построчно. Первая: одно зерно дважды — отпечатки совпали (OK). Вторая: другое зерно — отпечаток другой (OK). Третья: зерно задали один раз и «забыли» переустановить — отпечатки разошлись; это демонстрация, не критерий провала. Итог — determinism: OK (hash match) и код выхода 0. Сами двенадцатисимвольные хэши у вас могут отличаться (версии библиотек, число потоков процессора); важны знаки == / != и финальный OK.
Команды
Когда файлы набраны, прогоните урок целиком — две команды подряд. Так вы проверяете и окружение, и зерно: сначала «стол живой», потом «эксперименты честные».
python src/check_environment.py
python experiments/check_determinism.py
В терминале сначала увидите блок версий и строку Tensor OK, затем три строки про зерно и финал determinism: OK (hash match) — как в примерах выше. Если обе команды так отработали, лаборатория этого урока собрана.
Smoke
Smoke — короткий дымовой прогон: команды включают и сразу смотрят, печатают ли они OK. Это не обучение детектора. check_determinism.py делает несколько шагов только чтобы получить отпечаток весов и сравнить два запуска. По умолчанию шагов 50: на слабой машине это уже заметное ожидание, хотя для проверки зерна длинный прогон ничего не добавляет.
Если полный прогон кажется долгим, сократите обучение до пяти шагов. Окружение печатает то же самое. У проверки зерна хэши будут другими, потому что шагов меньше, а структура вывода та же. Смотрите на OK: конкретные цифры хэшей от числа шагов меняются.
python src/check_environment.py
python experiments/check_determinism.py --steps 5
same seed (42, 42) : 6d2b0b1f27c7 == 6d2b0b1f27c7 OK
different seed (42, 43) : 6d2b0b1f27c7 != 90500ac35763 OK
forgot to reseed : 6d2b0b1f27c7 != c9bb06091d82 (демо, не проверка)
determinism: OK (hash match)Ожидаемое
Откройте записки из «Предскажи» и сверьте с терминалом — это и есть смысл раздела, а не «угадай правильный ответ».
- Строка
Device— то устройство, которое вы ждали, или понятная причина другого (например,cpu, если стоит CPU-сборка PyTorch). - Одно зерно дважды → отпечатки совпали (
same seed … OK). - «Забыли переустановить» → отпечатки разошлись (третья строка).
Если устройство или строки про зерно не сходятся с ожиданием — загляните в «Если не так» ниже: чаще всего это окружение или потоки процессора, а не «сломалась идея урока».
Упражнение (эксперимент)
Три коротких опыта — чтобы руками почувствовать, где живёт случайность.
- Другое зерно:
python experiments/check_determinism.py --seed 7. Меняются ли отпечатки? Остаётся лиdeterminism: OK? - Закомментируйте строку
set_seed(seed)вtrain_tinyи запустите снова. Какие строки вывода изменились и почему? - Запустите две команды ниже: сначала с одним потоком, потом с четырьмя. Совпадают ли отпечатки между этими двумя запусками? Запишите, что увидели: число потоков процессора иногда вмешивается в хэш даже при одном зерне.
python experiments/check_determinism.py --threads 1
python experiments/check_determinism.py --threads 4Если не так
ModuleNotFoundError: No module named 'torch'. Скорее всего, не активировано виртуальное окружение или не ставили зависимости. В начале строки терминала должно быть(.venv); затем сноваpip install -r requirements.txt.Device: cpu, хотя видеокарта есть. Часто стоит CPU-сборка PyTorch или нет драйвера. Проверьтеpython -c "import torch; print(torch.cuda.is_available())". Для курса это не беда: все уроки рассчитаны на процессор.- Строка
same seedпечатаетFAIL. На части процессоров результат зависит от числа потоков. Запустите с--threads 1. Если и так не совпало — issue в репозитории курса с выводомcheck_environment.py: разберём. - Windows:
source .venv/bin/activateне работает. Используйте.venv\Scripts\activate(PowerShell или cmd) либо WSL.
Чеклист готовности
Перед следующим уроком убедитесь, что лаборатория отвечает у вас в репозитории, а файлы урока закоммичены.
- Свой репозиторий создан,
.venvактивирован, файлы урока закоммичены -
python src/check_environment.pyпечатаетTensor OK -
python experiments/check_determinism.pyпечатаетdeterminism: OK (hash match) - Три прогноза из «Предскажи» сверены с терминалом
Тренажёр набора. Фрагменты
device.pyиseed.pyвыше помечены для тренажёра. Зачем набирать руками в эпоху ИИ — на посадочной и в гайде по набору кода.
FAQ
Чем CNN отличается от обычной полносвязной сети на пикселях?
Полносвязная сеть связывает каждый пиксель с каждым весом заново. Свёрточная использует одно и то же небольшое окно по всей картинке: меньше параметров, сохраняется идея «локального признака». Для кропов с рукописью это естественнее, чем вытягивать все пиксели в один длинный вектор.
Зачем отделять детектор (CNN) от читателя (CRNN)?
У них разная цена ошибки и разный тип ответа: один класс против строки. Сторож отсекает пустые клетки под жёстким ограничением «не терять значения»; читатель разбирает символы. Если свалить всё в одну модель с первого дня, сложнее понять, что именно сломалось — порог, алфавит или сама сеть.
Зачем отдельный .venv, если PyTorch уже стоит в системе?
Пакеты курса не должны смешиваться с другими проектами. Иначе следующая утилита подтянет чужой torch, а этот репозиторий — чужие версии NumPy. Отдельное окружение делает pip install -r requirements.txt предсказуемым.
Почему проверка воспроизводимости идёт на CPU, если у меня есть GPU?
На GPU часть операций может быть недетерминированной даже при фиксированном seed. Мы намеренно считаем на процессоре, чтобы проверить наш код фиксации случайности, а не драйвер конкретной карты. Для самого курса CPU достаточно.
Достаточно ли одной строки torch.manual_seed(42)?
Нет. Случайность живёт ещё в модуле random, в numpy.random и в генераторе CUDA. Забыли один источник — в сравнении экспериментов остаётся шум. Поэтому set_seed трогает все четыре места.
Почему «забыли переустановить seed» даёт разные отпечатки?
set_seed выставляется один раз, а генератор после первого обучения уже продвинут. Второй запуск берёт следующие случайные числа — веса другие, хотя код тот же. Это типичная причина фразы «вчера было лучше».
Хэши у меня другие, чем в статье. Это ошибка?
Не обязательно. Версии библиотек, платформа и число потоков CPU влияют на конкретные байты весов. Важно, чтобы при одном seed два запуска совпали (OK), а при разных seed — разошлись. Число из статьи — снимок с одной машины.
Нужна ли видеокарта NVIDIA для этой серии?
Нет. Выбор устройства умеет cuda и mps, но все уроки рассчитаны на процессор. Карта ускорит более тяжёлые шаги позже, но лаборатория и первые модели должны проходить на CPU.
Что дальше
Картинок, датасетов и моделей пока нет. Дальше — урок 2, «Картинка → тензор»: один формат входа [1, 48, 160] для всех моделей курса. Ссылка появится, когда этот урок выйдет из черновика.
Эталон для сверки: lesson-01. Клонировать его не нужно.
Комментарии