Зміст
Курс «Навчаємо CNN і CRNN з нуля» для тих, хто пише на Python і хоче сам зібрати читання рукописних цифр у клітинці бланка. Досить відкрити термінал, створити оточення і запустити файл .py. Формули згорток і збирання рядка з колонок з’являться в тому уроці, де без них не зробити наступний крок. Рахувати можна на процесорі: відеокарта пришвидшить пізні прогони, але без неї серія не зупиняється.
Наприкінці серії код уміє дві речі і вміє поставити їх одна за одною. Перше — не втратити заповнену клітинку: на скані частина полів порожня, частина містить значення на кшталт 7,3 або 12/14, і порожнє не можна сплутати з написаним. Друге — прочитати цей рядок, не розмічаючи вручну, де стоїть кожна цифра. Спочатку модель дивиться, чи є в клітинці що читати. Потім друга читає символи. Таку зв’язку називають каскадом.
Такі мережі ставлять на вузьке питання і вже вирізану картинку. Клітинка бланка з виміром на кшталт 7,3, діаметр 12/14, товщина 1,5-2, галочка в анкеті: абетка коротка, сітка клітинок відома наперед, дивитися треба в один квадратик.
Користь цього розміру конкретна. Навчання йде швидко: на вхід приходить вирізка однієї клітинки, шарів мало, і навчальні прогони серії розраховані на процесор. Відповідь на клітинку рахується там само, на малопотужній машині, де лежать скани, і пачка бланків проходить клітинка за клітинкою. Сторож відсікає порожні поля одразу, і читач рядка вмикається лише там, де є штрих. Якщо змінилися бланк або почерк, а в клітинках і далі цифри, стару мережу донавчають на нових вирізках.
До каскаду ще кілька кроків. Спочатку — карта курсу і спосіб повторити вчорашній запуск з тим самим результатом. Потім картинка стане таблицею чисел, з’явиться список символів, які ми вміємо читати, і навчальні приклади. Далі — крихітна мережа, яка відрізняє порожню клітинку від заповненої, межа, після якої клітинка вважається заповненою, читання рядка і з’єднання двох моделей. Сьогодні беремо лише початок: куди йдемо і на якому столі порівнюватимемо експерименти.
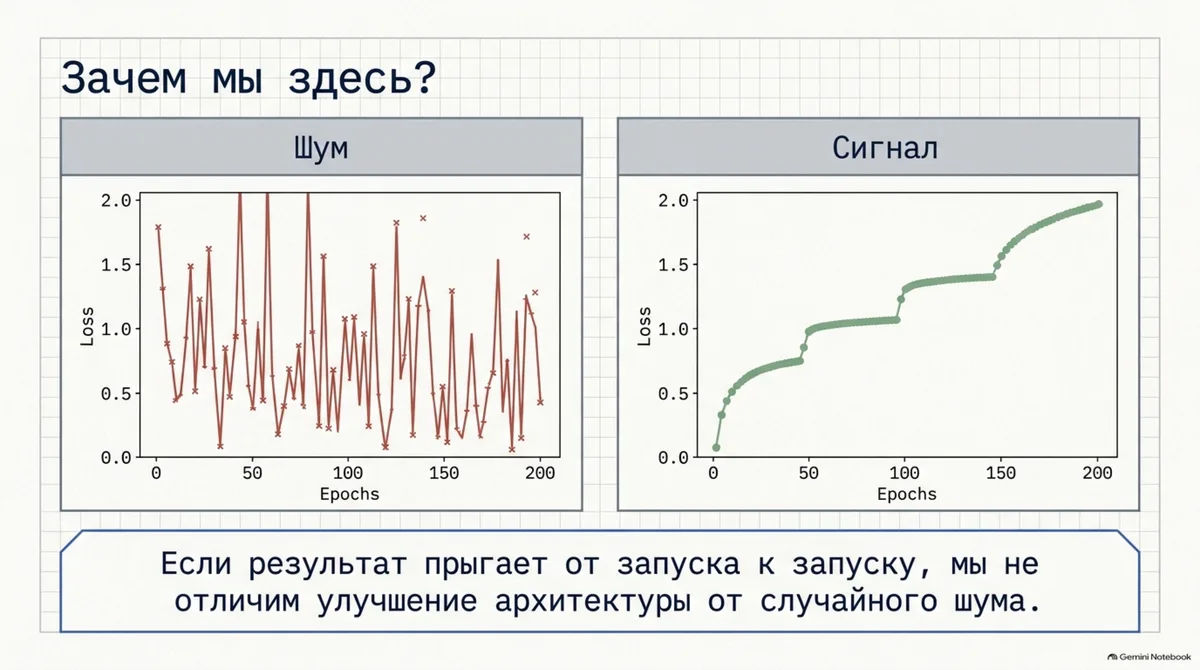
Учора втрата була менша. Сьогодні — з тим самим кодом — більша. Часто винен не алгоритм, а випадковість, яку забули зафіксувати: ваги стартували інакше, дані перемішалися інакше, і порівняння спотворень перетворилося на лотерею. Цей урок модель не вчить. Він відповідає на два питання: що взагалі за мережі CNN і CRNN у цій серії, і як поставити стіл так, щоб завтрашній запуск можна було чесно порівняти з учорашнім.
Зерно — навіщо воно потрібне вже зараз
Комп’ютер не кидає кості «з повітря». У нього є генератор псевдовипадкових чисел: довга, але повністю визначена послідовність. Зерно — стартова точка в цій послідовності. Те саме зерно → ті самі «випадкові» числа → ті самі початкові ваги мережі, той самий порядок прикладів при перемішуванні. Інше зерно → інша траєкторія. Без зафіксованого зерна два запуски одного скрипта порівнювати не можна: ви порівнюєте не код і не архітектуру, а різні витягування з генератора.
Далі в тексті «seed» у коді і «зерно» в мові курсу — одне й те саме. У коді параметр майже завжди називається seed; у мовленні курсу частіше кажемо «зерно».
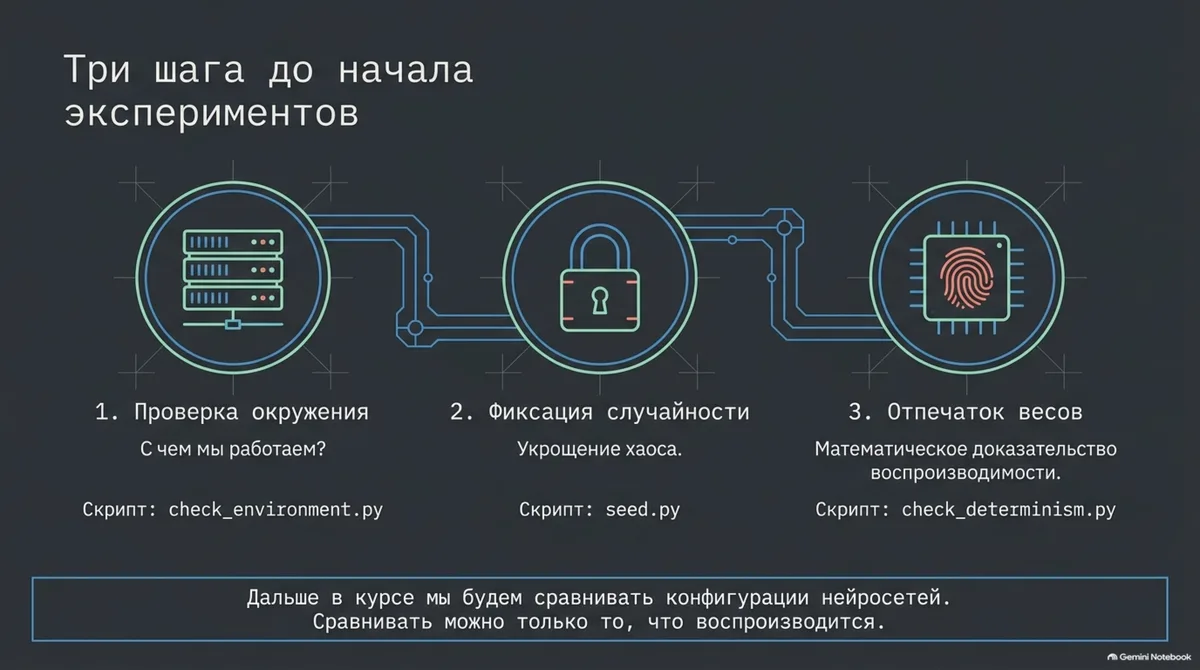
Наприкінці уроку у вас будуть: ясна картина, навіщо дві різні мережі; віртуальне оточення; скрипт версій і пристрою; і перевірка, що одне зерно дає побітово однакові ваги.
Що таке CNN і CRNN
Завдання курсу просте: на скані бланка є клітинки. Частина порожня, частина заповнена рукописним значенням на кшталт 7,3 або 12/14. Треба не втратити заповнені і прочитати рядок, не розмічаючи вручну, де на вирізці стоїть кожна цифра.
Однієї «універсальної» мережі на все це зазвичай не вистачає. Ми збираємо каскад із двох ролей.
CNN (згорткова нейромережа, Convolutional Neural Network) дивиться на картинку як на сітку пікселів. Фільтр невеликого вікна ковзає по площині і шукає місцеві ознаки: штрих, кут, пляму «чорнила», порожнє поле. Ті самі ваги фільтра працюють у всіх місцях кадру — тому мережа не вчить окремо «сімку ліворуч» і «сімку праворуч». Кілька шарів складають прості ознаки в складніші. У цій серії перша справжня CNN — крихітний детектор порожніх клітинок: на вхід вирізка, на вихід «порожньо / не порожньо» (уроки 7–9). Це не читання тексту, а сторож: «сюди взагалі варто кликати читача?».
CRNN (згортково-рекурентна нейромережа, Convolutional Recurrent Neural Network) потрібна, коли відповідь — послідовність змінної довжини, а не один клас. Згорткова частина знову витягує ознаки з картинки, але результат ріжуть на колонки вздовж рядка (часові кроки). Далі рекурентний блок (або його сучасний аналог) дивиться на ці колонки по порядку: зліва направо, як око по цифрах. На кожному кроці виходить розподіл за символами абетки плюс службовий blank. Як із цього зібрати рядок без розмітки «ця колонка — сімка» — тема CTC (зв’язна часова класифікація, Connectionist Temporal Classification) (урок 10); сама CRNN з’явиться трохи пізніше. Підсумок: CNN відповідає «чи є що читати», CRNN — «що саме написано».
Чому не віддати все одній мережі з першого дня? Порожня клітинка і заповнена — різні режими помилки. Прийняти значення за порожнє означає втратити дані. Прочитати зайву порожню — майже безкоштовно: далі її все одно відсіє читання або формат. Тому спочатку вчимо сторожа з жорстким обмеженням на повноту за значеннями, а вже потім — читача рядків. Каскад робить ціну помилок явною.
Груба карта курсу (імена — орієнтир, не розклад на сьогодні):
| Етап | Що з’являється | Роль |
|---|---|---|
| Уроки 1–3 | лабораторія, тензор, абетка | стіл і контракт міток |
| Уроки 4–6 | синтетика, розбиття, набір даних | дані без витоку |
| Уроки 7–9 | Tiny CNN, поріг, рецепт | детектор (CNN) |
| Уроки 10+ | CTC, потім CRNN | читач рядка |
| Ближче до кінця | зв’язка двох моделей | каскад «сторож → читач» |
Сьогодні з цієї таблиці беремо лише перший рядок — лабораторію: робоче оточення і відтворюваність. Мереж, даних і порогів ще не буде. Натомість з’явиться відповідь на питання, чи можна взагалі довіряти завтрашньому запуску.
Далі по курсу ми порівнюватимемо варіанти: різні спотворення картинки, різні пороги, з балансом класів і без, Tiny CNN проти базових правил. Якщо зерно щоразу інше (або його «забули»), «найкраща» конфігурація може виявитися просто вдалим стартом генератора. Тоді ви приймете шум за користь згорткової мережі — або, навпаки, відкинете робочий прийом, бо один прогін «не злетів». Фіксація оточення і зерна не вчить читати цифри; вона робить подальші порівняння чесними.
Файли уроку
Їх ще немає у вас на диску — сьогодні ви їх наберете. На схемі чотири опори. Верхня балка — обіцянка уроку: той самий запуск завтра дає той самий результат. Кожна колона відповідає на своє питання; якщо прибрати одну, балка не тримається.
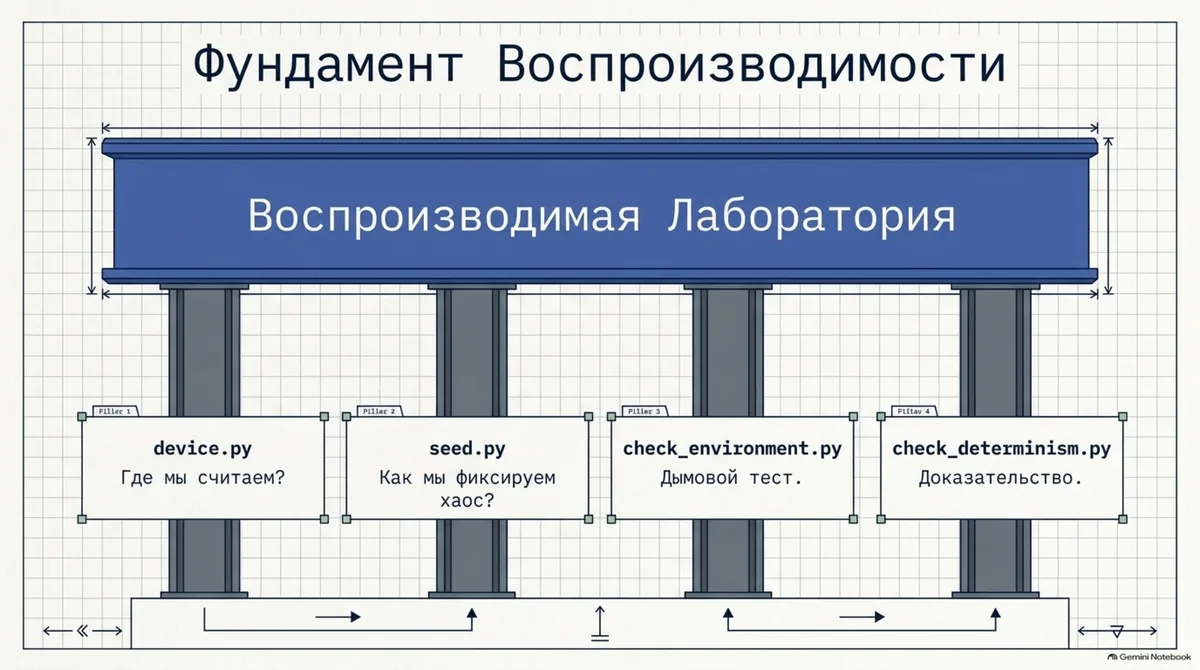
device.py— де ми рахуємо. Відеокарта NVIDIA, прискорювач Mac або процесор. Без цього «у мене повільно» і «у мене інші числа» ні з чим зв’язати.seed.py— як фіксуємо хаос. Виставляє одне зерно одразу в Python, NumPy і PyTorch, щоб ваги і перемішування не гуляли самі по собі.check_environment.py— димовий прогін. Друкує версії і пристрій і робить один розрахунок. Якщо він мовчить або падає, далі вчитися немає чого.check_determinism.py— доказ. Два запуски з одним зерном дають один відбиток ваг. Це не «нам здається, що все стабільно», а перевірка.
П’ятий файл на схемі не колона, а підлога: requirements.txt зі списком залежностей (torch, numpy, Pillow, matplotlib, pyyaml, pytest). Без нього опори просто ні з чого зібрати.
Еталон, якщо файл не заводиться: тег lesson-01. Клонувати його не потрібно.
Передбачте
Розділ «Передбачте» — не тест і не оцінка. Перед командою ви фіксуєте очікування: який пристрій побачите, чи збіжаться відбитки ваг, що буде, якщо зерно задати один раз і не оновлювати. Після запуску порівнюєте прогноз із терміналом. Збіглося — переконання стало фактом. Розійшлося — це і є урок: ви бачите, де інтуїція про залізо або випадковість помилялася, а не просто прогортаєте вивід.
Перед запуском запишіть відповіді (на папері або в нотатках):
- Який пристрій надрукує
check_environment.pyна вашому комп’ютері:cpu,cudaчиmps? - Ми двічі навчимо одну й ту саму крихітну модель з одним і тим самим зерном. Чи збіжаться «відбитки» ваг?
- А якщо один раз викликати
set_seedі далі не перевстановлювати зерно між двома навчаннями?
Встановлення
Код курсу ви пишете самі і зберігаєте у своєму репозиторії. Чужий репозиторій із готовими файлами клонувати не потрібно. Еталон lesson-01 відкривайте в браузері лише якщо вже набрали файл і щось не сходиться. Друкарські помилки і червоні імпорти — частина уроку.
Створіть теку і репозиторій, потім окреме оточення:
mkdir cnn-crnn-from-scratch
cd cnn-crnn-from-scratch
git init

python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
Наберіть requirements.txt:
torch>=2.2
numpy>=1.26
Pillow>=10.0
matplotlib>=3.8
pyyaml>=6.0
pytest>=8.0І .gitignore, щоб у коміт не потрапили оточення і згенеровані дані:
.venv/
__pycache__/
.pytest_cache/
data/Далі поставте залежності:
pip install -r requirements.txtЗбірку PyTorch за потреби беріть зі сторінки PyTorch. Курс розрахований так, щоб вистачало процесора.
Перевірте, що python дивиться в проєкт (на початку рядка термінала зазвичай видно (.venv)):
which python
python -c "import torch; print(torch.__version__)"
Приклад на macOS:
/Users/you/cnn-crnn-from-scratch/.venv/bin/python
2.14.1
На Windows замість which python — where python. У шляху має бути тека .venv проєкту. Якщо шлях системний, оточення не активоване: пакети підуть не туди.
Код: набираємо руками
Нижче — текст файлів для набору у ваш репозиторій. Пишіть самостійно. Якщо файл не працює, звіртеся з тегом lesson-01 у браузері.
Коментарі у файлах лишаються російською, як на еталонному тегу, щоб звірка рядок у рядок не розходилася через мову. Під кожним файлом написано, що робить рядок.
1. Вибір пристрою
У PyTorch тензори і обчислення живуть на пристрої (device): процесор або прискорювач. Та сама формула на різних пристроях дає той самий зміст, але різну швидкість і іноді різний «шум» (на GPU частина операцій буває недетермінованою). Тому в лабораторії ми явно питаємо: де зараз рахуємо — і друкуємо відповідь у димовому прогоні. Інакше фрази «у мене повільно» і «у мене інші числа» ні до чого прив’язати.
Три варіанти, які вміє наш курс:
| Ім’я в коді | Що це | Коли буває |
|---|---|---|
cuda |
GPU NVIDIA через CUDA (Compute Unified Device Architecture) | Є карта NVIDIA, драйвер і збірка PyTorch із CUDA |
mps |
прискорювач Apple через MPS (Metal Performance Shaders) | Mac на Apple Silicon і PyTorch із підтримкою Metal |
cpu |
звичайний процесор | Завжди доступний; запасний і основний шлях курсу |
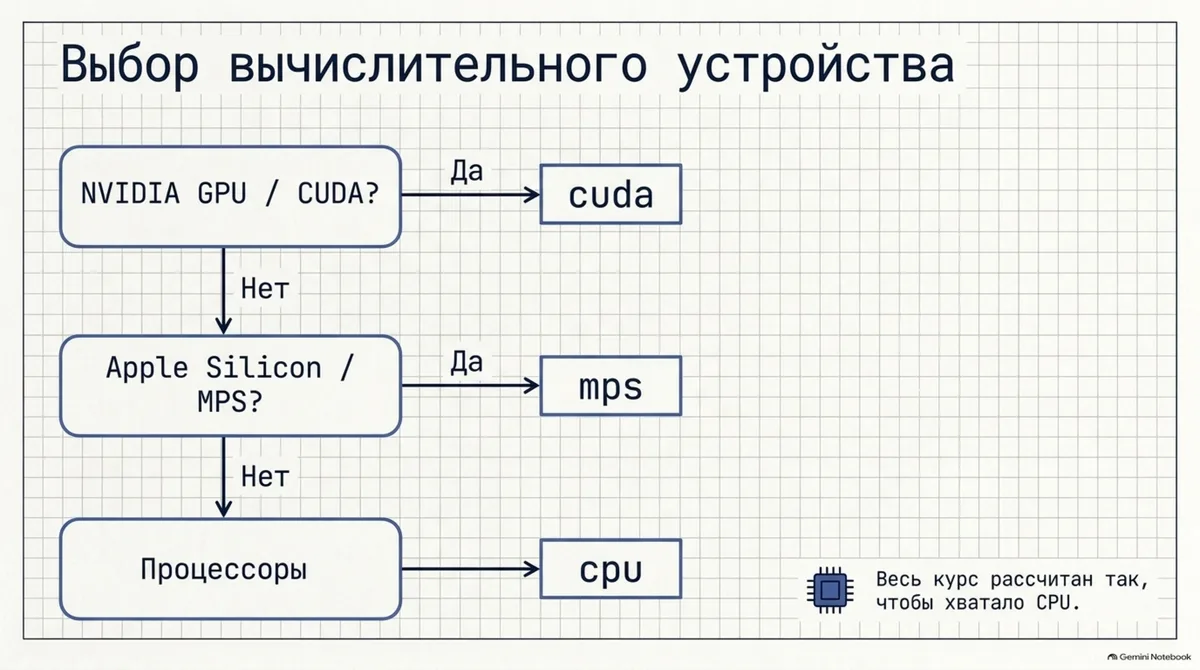
Порядок у функції — не «краще → гірше», а «спочатку спитаємо про типовий прискорювач, інакше візьмемо те, що точно є». На схемі: спочатку NVIDIA, потім Apple, інакше CPU.
Файл: src/device.py
"""Выбор устройства для вычислений: cuda → mps → cpu."""
import torch
def pick_device() -> torch.device:
if torch.cuda.is_available():
return torch.device("cuda") # NVIDIA + работающий драйвер
mps = getattr(torch.backends, "mps", None) # Apple Silicon, если модуль есть
if mps is not None and mps.is_available():
return torch.device("mps") # ускорение Metal на Mac
return torch.device("cpu") # запасной путь: весь курс рассчитан на CPUРозбір по рядках:
torch.cuda.is_available()— не «чи є чип NVIDIA в корпусі», а «чи PyTorch зараз може на ньому рахувати». Карта без драйвера або CPU-збірка пакета дадутьFalse.getattr(torch.backends, "mps", None)— у старих версіях PyTorch модуляmpsможе не бути. Безgetattrкод упав би зAttributeErrorна машині без Metal; з ним ми просто йдемо далі.mps.is_available()— Mac з Apple Silicon і робочий бекенд Metal.cpu— шлях за замовчуванням. Увесь курс розрахований так, щоб вистачало процесора: лабораторія, Tiny CNN і CTC на NumPy не вимагають купівлі відеокарти. Прискорювач знадобиться пізніше на важких прогонах, але відсутністьcuda/mps— не блокер.
Коли тензори створюють на одному пристрої, а операцію кличуть на іншому, PyTorch зазвичай свариться. Тому pick_device() викликають один раз на початку скрипта і далі передають результат (або кладуть модель на цей пристрій). В уроці 1 ми лише обираємо і друкуємо; перенесення мереж з’явиться разом із навчанням.
2. Фіксуємо зерно в усіх бібліотеках
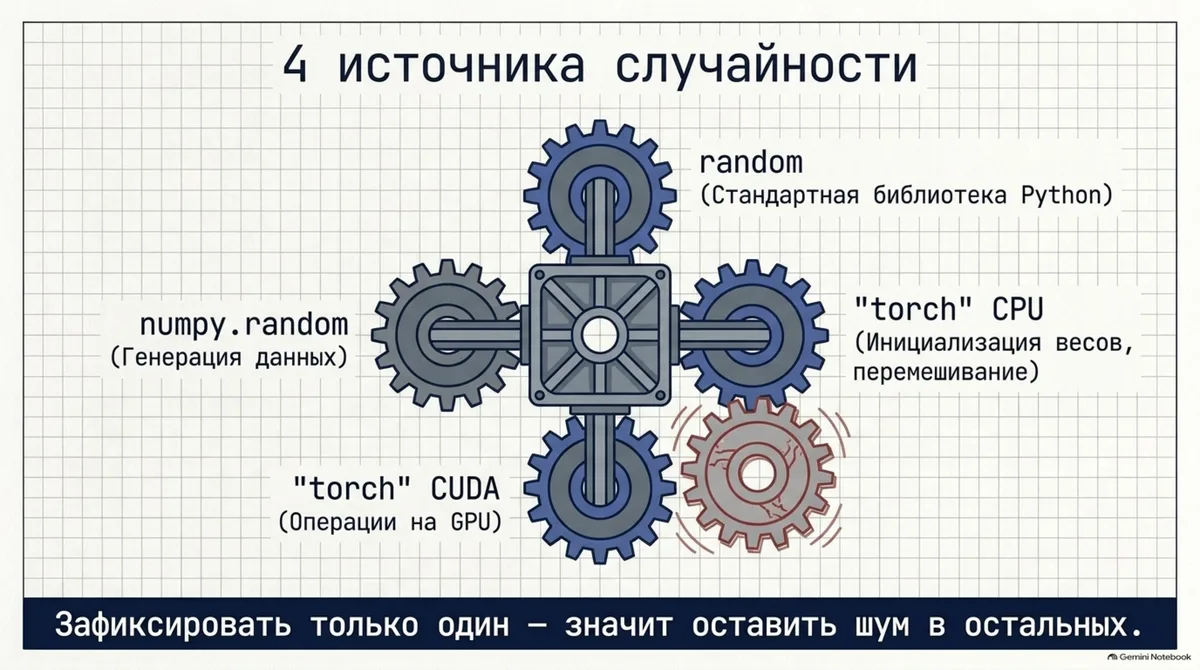
Ідею зерна ми вже розібрали: це стартова точка генератора псевдовипадкових чисел. На практиці в одному скрипті навчання таких генераторів кілька. Кожен живе у своїй бібліотеці і пам’ятає свій стан. Якщо «посадити» лише PyTorch, а NumPy лишити як є, дані можуть перемішатися інакше за того самого torch.manual_seed(42). На схемі чотири шестерні: зафіксували одну — в інших лишається шум.
Якщо випадковість не зафіксувати, два запуски одного й того самого файлу — це два різні експерименти. Код, дані і налаштування ті самі, а результат інший:
- початкові ваги інші → мережа йде іншою траєкторією → після тих самих епох втрата і точність відрізняються;
- приклади потрапляють у пачки в іншому порядку → кроки навчання інші;
- пізніше випадкові спотворення картинки і випадкове вимкнення частини ознак щоразу змінюють кадр і ознаки по-новому.
На екрані це виглядає як «учора було 0.99, сьогодні 0.96» без жодної правки в коді. Порівняння «зі спотворенням і без», «поріг 0.5 і підібраний», «баланс класів і none» перетворюється на лотерею: переможцем може виявитися вдалий старт генератора, а не вдале рішення. Перевірка наприкінці уроку якраз це показує: забули викликати set_seed перед другим прогоном — відбиток ваг уже інший.
Навіщо взагалі потрібна випадковість у навчанні:
- Початкові ваги мережі. У кожного фільтра і шару є свої числа: на них множаться пікселі й ознаки. Перед першим кроком навчання мережа ще нічого не бачила, і правильні числа взяти нізвідки. Нулі теж не ставлять: усі вікна виявилися б однаковими, і штрих із порожнім полем на старті не розрізнялися б. Тому числа беруть невеликими і випадковими. Від цього набору залежить, з якої траєкторії мережа стартує: ті самі приклади і те саме число кроків, інше зерно — інші перші числа й інший шлях навчання.
- Перемішування прикладів. Навчання йде пачками: кілька вирізок за раз. Порядок пачок часто випадковий, щоб модель не заучувала порядок файлу.
- Випадкові спотворення картинки (пізніше, урок 6) — безпечні зміни кадру: трохи зсунути, трохи зашуміти. Їх теж крутить генератор.
- Випадкове вимкнення ознак (пізніше, урок 9) — на навчанні мережа щоразу вимикає частину ознак. Це теж випадковість.
Одного виклику torch.manual_seed(42) замало: він чіпає генератор PyTorch, але не модуль random зі стандартної бібліотеки Python і не numpy.random (NumPy — бібліотека для масивів чисел; на ній часто роблять дані і частину спотворень). На відеокарті в PyTorch є ще окремий генератор на кожен пристрій CUDA — його лагодить torch.cuda.manual_seed_all.
Файл: src/seed.py
"""Воспроизводимость: фиксируем все источники случайности."""
import os
import random
import numpy as np
import torch
def set_seed(seed: int = 42, deterministic: bool = False) -> None:
"""Фиксирует seed в Python, NumPy и PyTorch (CPU и CUDA).
deterministic=True просит PyTorch использовать только детерминированные
алгоритмы. На GPU это может замедлить обучение или бросить ошибку для
операций без детерминированной версии.
"""
random.seed(seed) # стандартная библиотека (аугментации позже)
np.random.seed(seed) # генерация данных и часть аугментаций
torch.manual_seed(seed) # веса, dropout, перемешивание на CPU
torch.cuda.manual_seed_all(seed) # без CUDA вызов безвреден
if deterministic:
# переменная должна быть задана до первой операции на CUDA
os.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:8")
torch.use_deterministic_algorithms(True) # только детерминированные алгоритмы
def make_generator(seed: int) -> torch.Generator:
"""Отдельный генератор для DataLoader(shuffle=True, generator=...)."""
g = torch.Generator()
g.manual_seed(seed) # свой генератор под перемешивание батчей
return g
def seed_worker(worker_id: int) -> None:
"""worker_init_fn для DataLoader: у каждого воркера свой, но воспроизводимый seed."""
worker_seed = torch.initial_seed() % 2**32 # уникальный, но воспроизводимый seed воркера
np.random.seed(worker_seed)
random.seed(worker_seed)Чотири джерела, які чіпає set_seed (як на схемі):
| Джерело | За що відповідає в курсі |
|---|---|
random |
стандартна бібліотека Python; пізніше — частина спотворень |
numpy.random |
генерація і підготовка чисел та даних |
torch на CPU |
початкові ваги, випадкове вимкнення ознак, перемішування на процесорі |
torch на CUDA |
окремий генератор на кожній відеокарті NVIDIA |
Якщо зафіксувати лише один стовпець таблиці, решта й далі вноситиме шум.
Дві функції нижче set_seed поки не викликайте — вони знадобляться в уроці 6, коли з’явиться завантажувач пачок (DataLoader): він ріже набір даних на пачки і може читати файли в кількох фонових процесах. У кожного процесу свій стан генератора. make_generator віддає окремий об’єкт-генератор PyTorch під перемішування пачок; seed_worker виставляє зерно всередині процесу так, щоб воно було різним у різних процесів, але відтворюваним від запуску до запуску. Сьогодні досить набрати їх поруч із set_seed, щоб файл збігся з тегом.
Прапорець deterministic=True — про інше, не про зерно. Навіть за одного зерна PyTorch на GPU іноді обирає швидкий, але недетермінований алгоритм (той самий вхід → трохи інші біти на виході). «Детермінований» тут означає: просимо бібліотеку брати лише варіанти, де результат повторюється побітово. Це може бути повільніше або впасти, якщо для операції немає такого варіанта. Змінна оточення CUBLAS_WORKSPACE_CONFIG потрібна частині математики CUDA, щоб детермінізм узагалі ввімкнувся; її задають до першої операції на відеокарті. У нашому курсі прапорець за замовчуванням вимкнений, а перевірку відтворюваності ми запускаємо на CPU — так ми перевіряємо свій код фіксації зерна, а не драйвер конкретної карти.
3. Перевірка оточення
Файл: src/check_environment.py
"""Проверка окружения: версии, устройство, один тензорный расчёт."""
import platform
from importlib.metadata import version
import numpy as np
import torch
from device import pick_device
def main() -> None:
device = pick_device() # cuda → mps → cpu
print(f"Python : {platform.python_version()}")
print(f"Platform : {platform.platform()}")
print(f"torch : {torch.__version__}")
print(f"numpy : {np.__version__}")
print(f"Pillow : {version('Pillow')}")
print(f"Device : {device}")
print(f"CPU threads : {torch.get_num_threads()}")
x = torch.randn(2, 3, device=device) # маленький тензор на выбранном устройстве
y = x @ x.T # матричное умножение: дымовой тест «устройство считает»
assert y.shape == (2, 2), "неожиданная форма результата"
print(f"Tensor OK : shape={tuple(x.shape)}, device={x.device}")
if __name__ == "__main__":
main()Скрипт робить одне: друкує, з чим ви працюєте, і виконує невелике множення матриць на обраному пристрої. Якщо цей крок упав, далі йти немає сенсу.
Запуск:
python src/check_environment.pyПриклад виводу в цьому уроці (у вас будуть свої Platform, Device і число потоків):
Python      : 3.14.0
Platform    : macOS-26.5.2-arm64-arm-64bit-Mach-O
torch       : 2.14.1
numpy       : 2.5.3
Pillow      : 12.3.0
Device      : mps
CPU threads : 4
Tensor OK   : shape=(2, 3), device=mps:0
Головні рядки: Device (звірте з прогнозом із «Передбачте») і Tensor OK — множення на обраному пристрої пройшло. На машині без NVIDIA і без Apple Silicon буде Device: cpu і device=cpu — для курсу цього досить.
4. Перевірка відтворюваності
Файл: experiments/check_determinism.py
"""Проверка воспроизводимости: один seed → одни и те же веса.
Считаем на CPU, чтобы не смешивать нашу проверку с недетерминизмом GPU.
"""
import argparse
import hashlib
import sys
from pathlib import Path
import torch
import torch.nn.functional as F
from torch import nn
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from seed import set_seed # noqa: E402
def weights_hash(model: nn.Module) -> str:
"""Короткий «отпечаток» всех весов модели."""
h = hashlib.sha256()
for p in model.parameters():
h.update(p.detach().cpu().numpy().tobytes()) # байты весов → в хэш
return h.hexdigest()[:12] # короткий отпечаток для печати
def train_tiny(steps: int, seed: int | None) -> tuple[str, float]:
"""Мини-обучение. seed=None: set_seed сознательно НЕ вызываем («забыл seed»)."""
if seed is not None:
set_seed(seed) # фиксируем все источники случайности
model = nn.Sequential(nn.Linear(16, 32), nn.ReLU(), nn.Linear(32, 2)) # крошечная сеть
opt = torch.optim.SGD(model.parameters(), lr=0.1)
x = torch.randn(256, 16) # синтетические признаки
y = (x[:, 0] > 0).long() # метка из знака первого признака
loss = torch.tensor(0.0)
for _ in range(steps):
opt.zero_grad()
loss = F.cross_entropy(model(x), y) # ошибка классификации
loss.backward()
opt.step()
return weights_hash(model), float(loss.detach())
def main() -> int:
ap = argparse.ArgumentParser()
ap.add_argument("--steps", type=int, default=50)
ap.add_argument("--seed", type=int, default=42)
ap.add_argument("--threads", type=int, default=None,
help="число потоков CPU (1 помогает, если хэши не совпали)")
args = ap.parse_args()
if args.threads:
torch.set_num_threads(args.threads) # на части CPU влияет на хэш
h1, l1 = train_tiny(args.steps, args.seed) # первый запуск с seed
h2, l2 = train_tiny(args.steps, args.seed) # тот же seed → отпечатки должны совпасть
h3, _ = train_tiny(args.steps, args.seed + 1) # другой seed → отпечаток другой
set_seed(args.seed) # один раз в начале...
h4, _ = train_tiny(args.steps, None) # ...и дальше «забываем» переустанавливать
h5, _ = train_tiny(args.steps, None) # генератор уже сдвинут → другой результат
same_ok = h1 == h2 and l1 == l2 # одинаковый seed → одинаковые веса и loss
diff_ok = h1 != h3 # разный seed → проверка не «мёртвая»
print(f"same seed ({args.seed}, {args.seed}) : {h1} {'==' if h1 == h2 else '!='} {h2} "
f"{'OK' if same_ok else 'FAIL'}")
print(f"different seed ({args.seed}, {args.seed + 1}) : {h1} {'!=' if diff_ok else '=='} {h3} "
f"{'OK' if diff_ok else 'FAIL'}")
print(f"forgot to reseed : {h4} {'!=' if h4 != h5 else '=='} {h5} (демо, не проверка)")
if same_ok and diff_ok:
print("determinism: OK (hash match)")
return 0
print("determinism: FAIL (см. раздел «Если не так» в уроке)")
return 1
if __name__ == "__main__":
sys.exit(main())Ідея проста. Ми навчаємо крихітну мережу на випадкових даних і рахуємо «відбиток» (хеш) усіх її ваг. Три експерименти:
- Одне зерно, два запуски. Відбитки мають збігтися. Якщо ні, відтворюваність зламана, і далі будь-які порівняння безглузді.
- Різні зерна. Відбитки мають розрізнятися. Інакше перевірка нічого не перевіряє (наприклад, зерно взагалі не впливає на результат).
- «Забули перевстановити зерно». Ми викликаємо
set_seedодин раз і запускаємо навчання двічі поспіль, не перевстановлюючи його. Другий запуск стартує з уже просунутого стану генератора і дає інший результат. Це найчастіша причина «учора було краще»: код той самий, а випадковість інша.
Рахуємо на CPU навмисно: так ми перевіряємо свій код, а не недетермінізм конкретної відеокарти.
Запуск:
python experiments/check_determinism.pyПриклад виводу в цьому уроці:
same seed (42, 42)      : 1415d3102ea2 == 1415d3102ea2   OK
different seed (42, 43) : 1415d3102ea2 != 8a6ef2f5d087   OK
forgot to reseed        : 1415d3102ea2 != 8ab8dc6618c1   (демо, не проверка)
determinism: OK (hash match)
Читайте порядково. Перший: одне зерно двічі — відбитки збіглися (OK). Другий: інше зерно — відбиток інший (OK). Третій: зерно задали один раз і «забули» перевстановити — відбитки розійшлися; це демонстрація, не критерій провалу. Підсумок — determinism: OK (hash match) і код виходу 0. Самі дванадцятисимвольні хеші у вас можуть відрізнятися (версії бібліотек, число потоків процесора); важливі знаки == / != і фінальний OK. У третьому рядку програма друкує російське (демо, не проверка) — «демонстрація, не перевірка».
Команди
Коли файли набрані, прогоніть урок цілком — дві команди поспіль. Так ви перевіряєте і оточення, і зерно: спочатку «стіл живий», потім «експерименти чесні».
python src/check_environment.py
python experiments/check_determinism.py
У терміналі спочатку побачите блок версій і рядок Tensor OK, потім три рядки про зерно і фінал determinism: OK (hash match) — як у прикладах вище. Якщо обидві команди так відпрацювали, лабораторія цього уроку зібрана.
Smoke
Smoke — короткий димовий прогін: команди вмикають і одразу дивляться, чи друкують вони OK. Це не навчання детектора. check_determinism.py робить кілька кроків лише щоб отримати відбиток ваг і порівняти два запуски. За замовчуванням кроків 50: на слабкій машині це вже помітне очікування, хоча для перевірки зерна довгий прогін нічого не додає.
Якщо повний прогін здається довгим, скоротіть навчання до п’яти кроків. Оточення друкує те саме. У перевірки зерна хеші будуть іншими, бо кроків менше, а структура виводу та сама. Дивіться на OK: конкретні цифри хешів від числа кроків змінюються.
python src/check_environment.py
python experiments/check_determinism.py --steps 5
same seed (42, 42) : 6d2b0b1f27c7 == 6d2b0b1f27c7 OK
different seed (42, 43) : 6d2b0b1f27c7 != 90500ac35763 OK
forgot to reseed : 6d2b0b1f27c7 != c9bb06091d82 (демо, не проверка)
determinism: OK (hash match)Очікуване
Відкрийте нотатки з «Передбачте» і зверте з терміналом — це і є сенс розділу, а не «вгадай правильну відповідь».
- Рядок
Device— той пристрій, якого ви чекали, або зрозуміла причина іншого (наприклад,cpu, якщо стоїть CPU-збірка PyTorch). - Одне зерно двічі → відбитки збіглися (
same seed … OK). - «Забули перевстановити» → відбитки розійшлися (третій рядок).
Якщо пристрій або рядки про зерно не сходяться з очікуванням — зазирніть у «Якщо не так» нижче: найчастіше це оточення або потоки процесора, а не «зламалася ідея уроку».
Вправа
Три короткі досліди — щоб руками відчути, де живе випадковість.
- Інше зерно:
python experiments/check_determinism.py --seed 7. Чи змінюються відбитки? Чи лишаєтьсяdeterminism: OK? - Закоментуйте рядок
set_seed(seed)уtrain_tinyі запустіть знову. Які рядки виводу змінилися і чому? - Запустіть дві команди нижче: спочатку з одним потоком, потім із чотирма. Чи збігаються відбитки між цими двома запусками? Запишіть, що побачили: число потоків процесора іноді втручається в хеш навіть за одного зерна.
python experiments/check_determinism.py --threads 1
python experiments/check_determinism.py --threads 4Якщо не так
ModuleNotFoundError: No module named 'torch'. Найімовірніше, не активоване віртуальне оточення або не ставили залежності. На початку рядка термінала має бути(.venv); потім зновуpip install -r requirements.txt.Device: cpu, хоча відеокарта є. Часто стоїть CPU-збірка PyTorch або немає драйвера. Перевіртеpython -c "import torch; print(torch.cuda.is_available())". Для курсу це не біда: усі уроки розраховані на процесор.- Рядок
same seedдрукуєFAIL. На частині процесорів результат залежить від числа потоків. Запустіть з--threads 1:python experiments/check_determinism.py --threads 1. Якщо і так не збіглося — issue в репозиторії курсу з виводомcheck_environment.py: розберемо. - Windows:
source .venv/bin/activateне працює. Використовуйте.venv\Scripts\activate(PowerShell або cmd) або WSL.
Контрольний список
Перед наступним уроком переконайтеся, що лабораторія відповідає у вас у репозиторії, а файли уроку закомічені.
- Свій репозиторій створений,
.venvактивований, файли уроку закомічені -
python src/check_environment.pyдрукуєTensor OK -
python experiments/check_determinism.pyдрукуєdeterminism: OK (hash match) - Три прогнози з «Передбачте» звірені з терміналом
Тренажер набору. Фрагменти
device.pyіseed.pyвище позначені для тренажера. Навіщо набирати руками в епоху ШІ — на посадковій і в гайді з набору коду.
FAQ
Чим CNN відрізняється від звичайної повнозв’язної мережі на пікселях?
Повнозв’язна мережа зв’язує кожен піксель із кожною вагою заново. Згорткова використовує те саме невелике вікно по всій картинці: менше параметрів, зберігається ідея «місцевої ознаки». Для вирізок із рукописом це природніше, ніж витягувати всі пікселі в один довгий вектор.
Навіщо відокремлювати детектор (CNN) від читача (CRNN)?
У них різна ціна помилки і різний тип відповіді: один клас проти рядка. Сторож відсікає порожні клітинки під жорстким обмеженням «не втрачати значення»; читач розбирає символи. Якщо звалити все в одну модель з першого дня, складніше зрозуміти, що саме зламалося — поріг, абетка чи сама мережа.
Навіщо окремий .venv, якщо PyTorch уже стоїть у системі?
Пакети курсу не повинні змішуватися з іншими проєктами. Інакше наступна утиліта підтягне чужий torch, а цей репозиторій — чужі версії NumPy. Окреме оточення робить pip install -r requirements.txt передбачуваним.
Чому перевірка відтворюваності йде на CPU, якщо в мене є GPU?
На GPU частина операцій може бути недетермінованою навіть за фіксованого зерна. Ми навмисно рахуємо на процесорі, щоб перевірити наш код фіксації випадковості, а не драйвер конкретної карти. Для самого курсу CPU досить.
Чи досить одного рядка torch.manual_seed(42)?
Ні. Випадковість живе ще в модулі random, у numpy.random і в генераторі CUDA. Забули одне джерело — у порівнянні експериментів лишається шум. Тому set_seed чіпає всі чотири місця.
Чому «забули перевстановити зерно» дає різні відбитки?
set_seed виставляється один раз, а генератор після першого навчання вже просунутий. Другий запуск бере наступні випадкові числа — ваги інші, хоча код той самий. Це типова причина фрази «учора було краще».
Хеші в мене інші, ніж у статті. Це помилка?
Не обов’язково. Версії бібліотек, платформа і число потоків CPU впливають на конкретні байти ваг. Важливо, щоб за одного зерна два запуски збіглися (OK), а за різних зерен — розійшлися. Число зі статті — знімок з однієї машини.
Чи потрібна відеокарта NVIDIA для цієї серії?
Ні. Вибір пристрою вміє cuda і mps, але всі уроки розраховані на процесор. Карта пришвидшить важчі кроки пізніше, але лабораторія і перші моделі мають проходити на CPU.
Що далі
Картинок, наборів даних і моделей поки немає. Далі — урок 2, «Картинка → тензор»: один формат входу [1, 48, 160] для всіх моделей курсу. Посилання з’явиться, коли цей урок вийде з чернетки.
Еталон для звірки: lesson-01. Клонувати його не потрібно.
Коментарі