Зміст
Коротко
На Habr вийшов огляд про те, як текст із форумів, новини й навіть старі паперові книжки перетворилися на товар із цінником.
Це схоже на нафту: поки вона «просто тече», ніхто не рахує барелі, а коли завод стоїть без сировини — платять за доступ.
Автор проходить шлях від платного API у Reddit і медіаугод OpenAI до банкрутного аукціону Spirit Airlines і проєкту Anthropic зі скупки й знищення фізичних книг.
Що сталося
Бум великих мовних моделей прийнято відраховувати з 2022 року й виходу ChatGPT на базі GPT-3.5.
Для навчання потрібні чужі тексти, код, фото й листування — без людського сліду моделі ні з чого збирати. Автор нагадує просту картинку: нова пекарня «не існує» для рекомендаційної системи, доки хтось не відкриє її сторінку, не залишить відгук і оцінку. Інформація з’являється лише разом із дією.
Коли даних мало, багатий гравець не чекає, поки користувачі самі завантажать PDF: він купує доступ. Форуми тут особливо цінні — довгий архів питань і відповідей, уже відфільтрований живим спілкуванням.
Першим гучним сигналом став Reddit. У квітні 2023 року компанія закрила безкоштовний API, за два місяці доступ став платним.
Клієнт Apollo для iOS закрився — розробник оцінив вартість API приблизно в 20 мільйонів доларів на рік. На початку 2024 року Reddit домовився з Google приблизно на 60 мільйонів доларів на рік за ліцензію контенту для навчання ШІ; до IPO сума подібних угод уже перевищувала 200 мільйонів доларів.
Навесні 2024 року OpenAI оголошувала партнерства майже щотижня: Stack Overflow (сайт незадовго до цього скоротив близько 28% співробітників на тлі падіння трафіку), знову Reddit, потім News Corp більш ніж на 250 мільйонів доларів за п’ять років.
Далі — Dotdash Meredith не менш ніж на 16 мільйонів, Axel Springer близько 13 мільйонів доларів на рік на строк до трьох років, Financial Times від 5 до 10 мільйонів на рік. Wiley закрила дві угоди на 21 і 23 мільйони з неназваними покупцями; Informa отримала стартові 10 мільйонів від Microsoft. У Shutterstock ліцензування для ШІ у 2023 році дало близько 104 мільйонів доларів.
Прогноз Epoch AI ще у 2024-му попереджав: загальнодоступний людський контент як паливо для навчання почне різко стискатися з 2026 року й майже вичерпається до 2032-го.
На цьому тлі 2 травня 2026 року збанкрутілий Spirit Airlines став джерелом іншого типу сировини. Google виграла аукціон корпоративних даних за 10 мільйонів доларів — йдеться про близько 100 мільйонів листів і близько 500 мільйонів повідомлень із Microsoft Teams плюс внутрішні документи; персональні дані клієнтів компанія, за її словами, не отримує.
Окремо — Anthropic. У липні 2026 року суд у Сан-Франциско затвердив мирову угоду на 1,5 мільярда доларів за позовом видавців і авторів про книжки з торентів; правовласникам близько 3000 доларів за кожен твір в угоді.
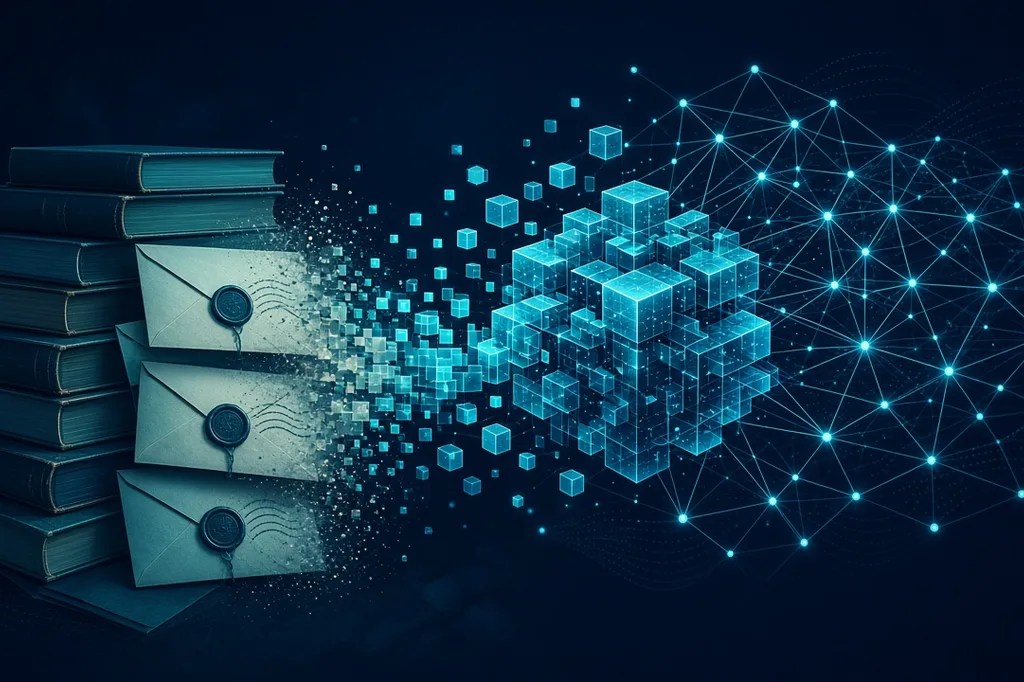
Паралельно зі справи сплив проєкт «Панама»: з 2024 року компанія скуповує паперові книжки, сканує їх для навчання Claude й знищує оригінали — мільйони уживаних томів. Легальний ланцюг володіння став дорожчим за «сірий» завантажуваний архів.
Чому це важливо
Ринок перестав сперечатися лише про «чи можна парсити відкритий веб».
Платний API, ліцензії ЗМІ й банкрутні архіви показують іншу норму: походження даних — такий самий актив, як залізо чи вугілля на заводі. Коли відкритий потік висихає, купують те, чого немає у загальному доступі: пошту компанії, внутрішні бази, відскановані книжки з зрозумілим ланцюгом володіння.
Прогноз Epoch AI і угода навколо Spirit Airlines читаються разом: публічний текст скінченний, а корпоративні архіви — наступний шар. Закони й суди наздоганяють ринок не гаслами, а цифрами в мирових угодах.
Для розробника це змінює розмову про власний продукт. Якщо ви копите логи, тікети чи корпус документів «на потім для своєї моделі», це вже не безкоштовний побічний продукт — це актив із юридичною й комерційною вагою.
І навпаки: чужий корпус без ліцензії дедалі частіше закінчується не «сірою зоною», а рахунком на мільярди, як у справі Anthropic. Якість і походження даних починають коштувати дорожче за сирий обсяг.
На практиці
Текст — огляд чужих угод, а не прайс на ваш набір даних. Має сенс читати його як карту ризиків, якщо ви навчаєте чи донавчаєте модель, закуповуєте корпус або просто зберігаєте користувацький контент.
- Фіксуйте походження даних: ліцензія, договір, джерело вивантаження — до того, як корпус потрапить у навчання.
- Не будуйте план лише на «усьому, що лежить у відкритому
API»:Redditуже показав, як швидко доступ стає платним. - Відокремлюйте публічний веб, ліцензований медіаконтент і внутрішні корпоративні архіви — у кожного свій правовий режим.
- Якщо копите користувацькі тексти «під майбутню модель», заздалегідь опишіть згоду й мету використання — інакше актив перетворюється на позов.
- Стежте за судовими рамками на кшталт справи
Anthropic: «завантажили з торента, але в навчання не брали» уже не виглядає безпечною відмовкою в публічному полі.
Підсумок
За кілька років коментар на форумі, стаття в газеті й стос уживаних книжок перестали бути «просто контентом» — за них платять десятки й сотні мільйонів, а за порушення авторських прав — уже мільярди.
Коло замкнулося: цифровий слід і звичайне спілкування в мережі стали сировиною, без якої завод мовних моделей не працює. Залишаючи сьогодні черговий «нічого не значущий» коментар, ви по суті створюєте актив, за який гіганти готові виписувати чеки.
Коментарі