

Зміст
Коротка функція з п'яти рядків іноді вкладається в один дешевий запит. Перенесення модуля в чужому репозиторії з тестами, лінтером і трьома колами виправлень — це вже зовсім інший рахунок: у контекст потрапляють правила проєкту, знайдені файли, логи та історія діалогу, а модель викликається знову і знову. Нижче — практична модель того, як рахувати вартість AI-розробки: не лише «скільки коштує мільйон токенів», а скільки коштує довести задачу до робочого результату потрібної якості.
Ключові висновки
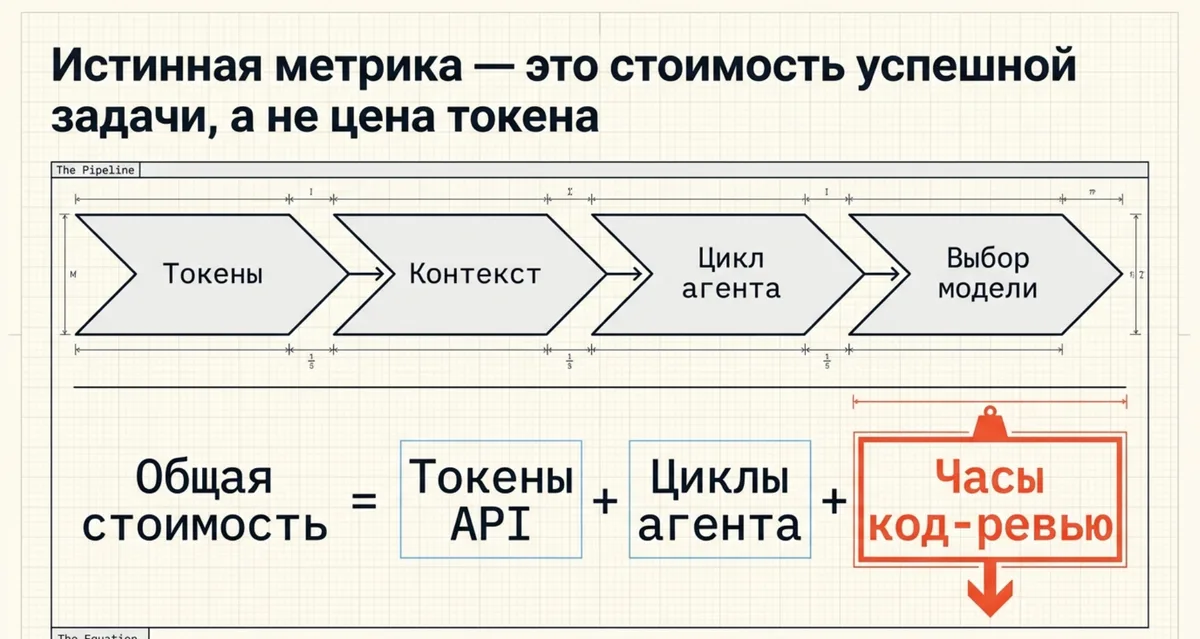
Токен — одиниця обліку моделі, а не одиниця цінності. Ви платите за те, що модель прочитала й згенерувала; цінність з'являється, коли зміну прийнято, перевірено і вона не зламала збірку.
Контекст часто дорожчий за короткий промпт. Системні інструкції, правила, історія, файли та відповіді інструментів сумуються у вхід; користувацька фраза з двох речень може запустити тисячі токенів.
Дешева модель не завжди дешевша. Багато циклів виправлення та ручного доопрацювання легко перевершують один дорогий, але точний прохід.
Кеш і вікно контексту — різні речі. Велике вікно дає можливість; кеш знижує ціну повторного префікса; фактично передані токени визначають рахунок.
Підписка редактора й API за токенами не взаємозамінні. Квоти, кредити та пряма тарифікація живуть за різними правилами; не переводьте ліміт підписки в «еквівалентні» долари API без застережень.
Агентові потрібна економіка циклу. Рахуйте суму всіх викликів моделі та інших операцій до критеріїв готовності, а не одну відповідь у чаті.
Що таке токен і як модель рахує текст та код
Токен — шматок представлення тексту, яким оперує мовна модель. Він не дорівнює слову, символу чи рядку коду. Часті слова й фрагменти нерідко вкладаються в один токен; рідкісні назви, довгі ідентифікатори, JSON і трасування стека розбиваються на кілька. Відступи, дужки та пунктуація теж входять у рахунок. Різні родини моделей використовують різні токенізатори: один і той самий фрагмент TypeScript у двох API може дати різну кількість токенів.
Груба оцінка «чотири символи ≈ один токен» іноді працює на простому англійському тексті й майже завжди бреше на коді, логах і змішаних мовах. Перед надсиланням важливого запиту рахуйте токени токенізатором обраної родини або лічильником із документації API. Невеликі навчальні контрасти: короткий коментар українською; TypeScript-функція з довгими іменами; компактний JSON; трасування стека на два екрани — останній майже завжди «важчий», ніж здається оку.
Які токени оплачуються
Вхідні токени (input) — усе, що отримує модель: системні інструкції, ваш запит, історія діалогу, передані файли та фрагменти репозиторію, відповіді інструментів, вставлені назад у контекст. Вихідні (output) — видима відповідь: план, пояснення, код, JSON. У частини моделей окремо враховують токени міркування (reasoning): внутрішня робота може тарифікуватися інакше, ніж видимий текст, і «весь output = те, що ви прочитали» вже неправильно. Кешований вхід (cached input) — повторюваний префікс, який API обслуговує за зниженою ціною за умов провайдера; це не «увесь контекст безкоштовно».
Назви полів у usage, одиниці та правила змінюються між OpenAI, Anthropic, Google та іншими. Перед бюджетуванням звіряйте офіційну сторінку тарифів на дату розрахунку. Корпоративний контур обліку за проєктами та шлюзами розібрано в FinOps для шлюзу LLM і в бюджетах токенів та рознесенні витрат.
Формула вартості запиту
Загальна схема:
вартість ≈ input × ціна_input + output × ціна_output + cached_input × ціна_cached + інші операції
Якщо тариф указано за мільйон токенів, переводьте кількість у мільйони. Вхід і вихід майже завжди коштують по-різному. До підсумку задачі входить не один виклик, а серія: уточнення, повтор після червоних тестів, другий агентний прохід.
Навчальний приклад (ціни вигадані, не тариф 2026 року). Нехай input = 0,0005 $/1K, output = 0,0015 $/1K, cached input = 0,0001 $/1K. Один виклик: 40 000 input + 10 000 cached + 3 000 output → 40×0,0005 + 10×0,0001 + 3×0,0015 = 0,0255 $. П'ять таких циклів виправлення без зростання кешу — це вже близько 0,13 $ лише на модель, без часу людини.
Додайте шар людини. Якщо кожен цикл займає десять хвилин рев'ю, п'ять циклів — майже година. За внутрішньою ставкою команди навіть скромна година легко перекриває рахунок API. Тому «заощадити два речення в промпті» майже ніколи не головний важіль: важливіше скоротити число непотрібних кіл і обсяг шуму на вході. Підставляйте числа зі свого білінгу й обліку часу; сенс вправи — побачити множники.
Чому контекст — головна прихована витрата
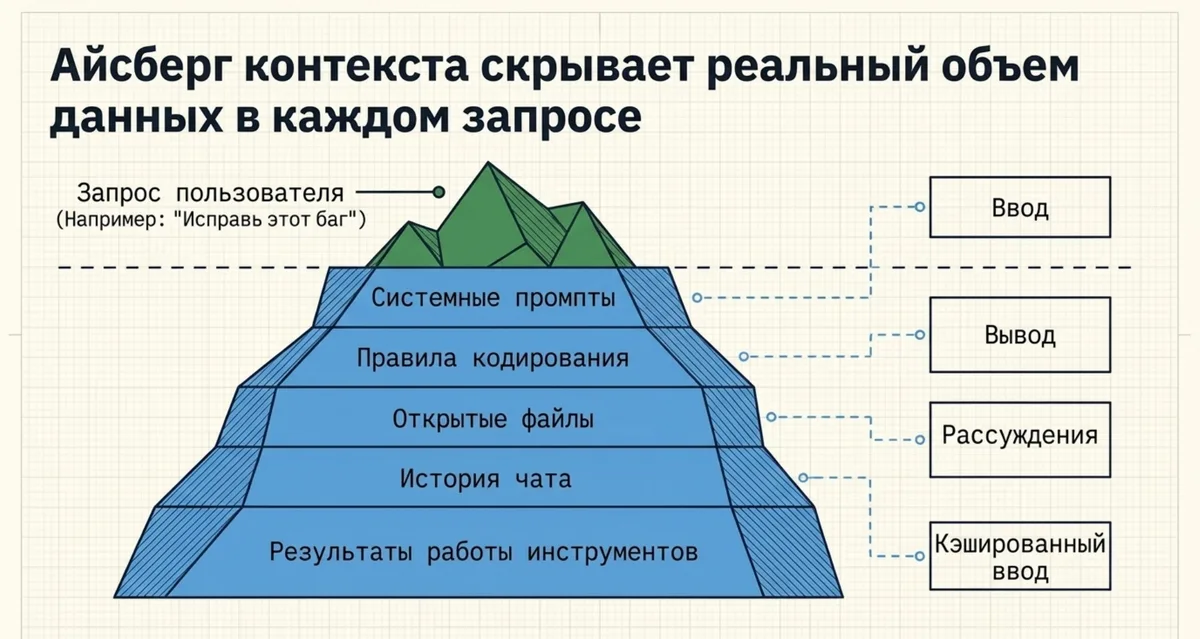
Модель вирішує за тим, що їй передали. В AI-розробці туди потрапляють системні інструкції редактора, правила репозиторію, історія, відкриті файли, результати пошуку по коду, помилки збірки та виводи інструментів. Із ускладненням задачі контекст росте; деякі контури на кожному кроці знову надсилають великий префікс.
Розрізняйте чотири поняття. Вікно контексту — верхня межа, яку модель може обробити за виклик. Фактично передані токени — що пішло в цей запит. Вартість контексту — скільки з цього тарифікували (включно з кешем). Якість контексту — наскільки дані допомогли розв'язати задачу. Велике вікно — можливість, а не обов'язок згодовувати моноліт. Зайвий файл і застарілий лог підвищують рахунок, а іноді й погіршують відповідь. Як IDE та агенти збирають контекст під капотом — у розборі AI IDE.
Куди йдуть токени в Cursor та подібних редакторах
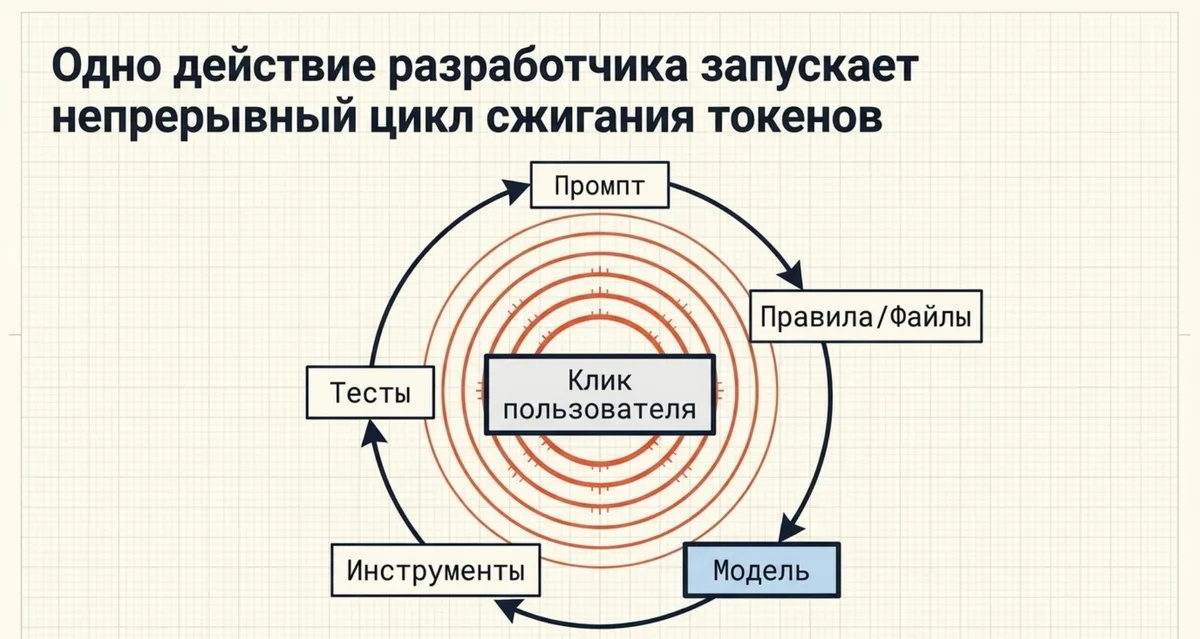
Типовий цикл (інструменти відрізняються деталями, не копіюйте це як специфікацію Cursor): ви формулюєте задачу → редактор додає систему й правила → вибирає файли або фрагменти → модель планує → агент читає ще файли або викликає інструменти → результати повертаються в контекст → генерується чи правиться код → ганяються тести або лінтер → помилки знову йдуть у модель → цикл повторюється.
Коротке повідомлення користувача може розгорнути великий сумарний контекст. Агент часто робить кілька модельних викликів на одну «кнопку». Відкритий величезний файл і довга історія здорожчують крок. Підписочна квота, внутрішні кредити й прямий API — різні світи оплати; не змішуйте їх в одній таблиці без приміток.
Практичний прийом спостереження: для однієї задачі запишіть, скільки разів викликали «думаючу» модель, які файли явно пішли в контекст, чи були прогони тестів зі зворотною подачею логу. Навіть без повної телеметрії редактора такий щоденник за тиждень показує, де команда спалює бюджет — на дослідженні репозиторію, на нескінченному фіксі стилю чи на генерації великих дифів без критеріїв. Докладніше про агентні контури — в агентній інженерії.
Чому одна й та сама «фіча» коштує по-різному
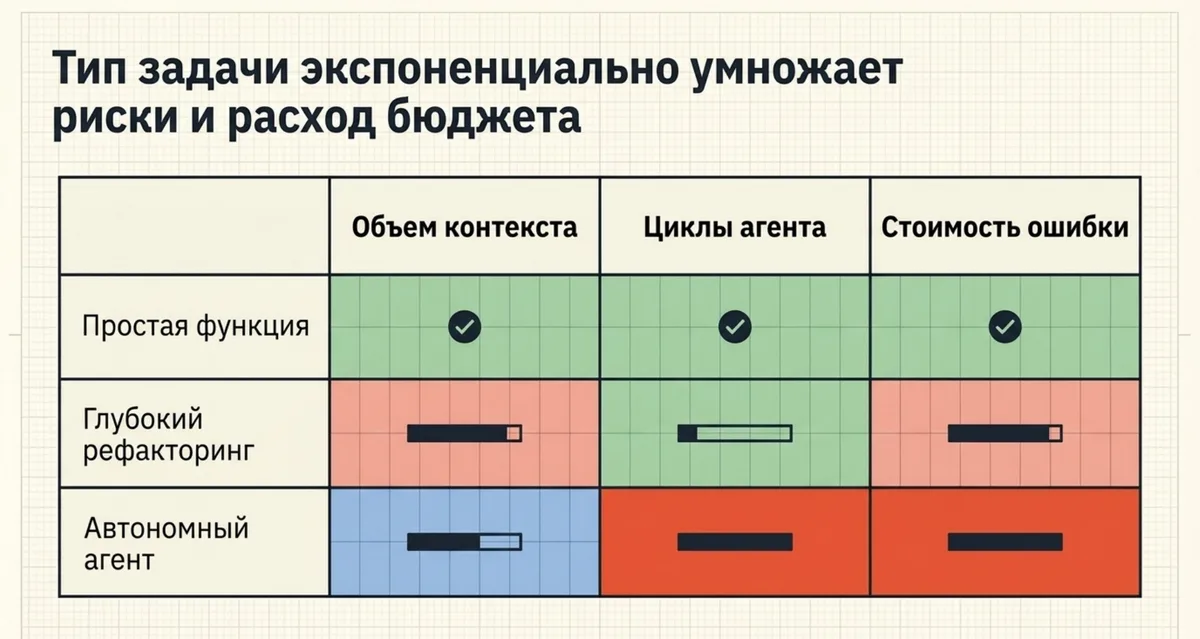
| Тип задачі | Основне джерело витрат | Що зазвичай знижує рахунок |
|---|---|---|
| Проста функція | Короткий вивід | Чітке ТЗ без зайвого контексту |
| UI-компонент | Вимоги та сусідні файли | Потрібні інтерфейси й приклади, а не весь екран |
| Баг за трасуванням стека | Логи та повтори | Мінімальний відтворюваний приклад |
| Рефакторинг модуля | Кілька файлів | Поетапна декомпозиція |
| Розбір чужого репозиторію | Пошук і читання | Індекс і релевантні шматки |
| Автономний агент | Цикли інструментів | Ліміт ітерацій і критерії зупинки |
Чим ширший контекст, чим більше викликів і чим слабші критерії приймання, тим вищий хвіст вартості. Ручне доопрацювання після «майже готово» — теж частина економіки, навіть якщо білінг API його не бачить.
Кешування промпту: коли повтор контексту дешевшає
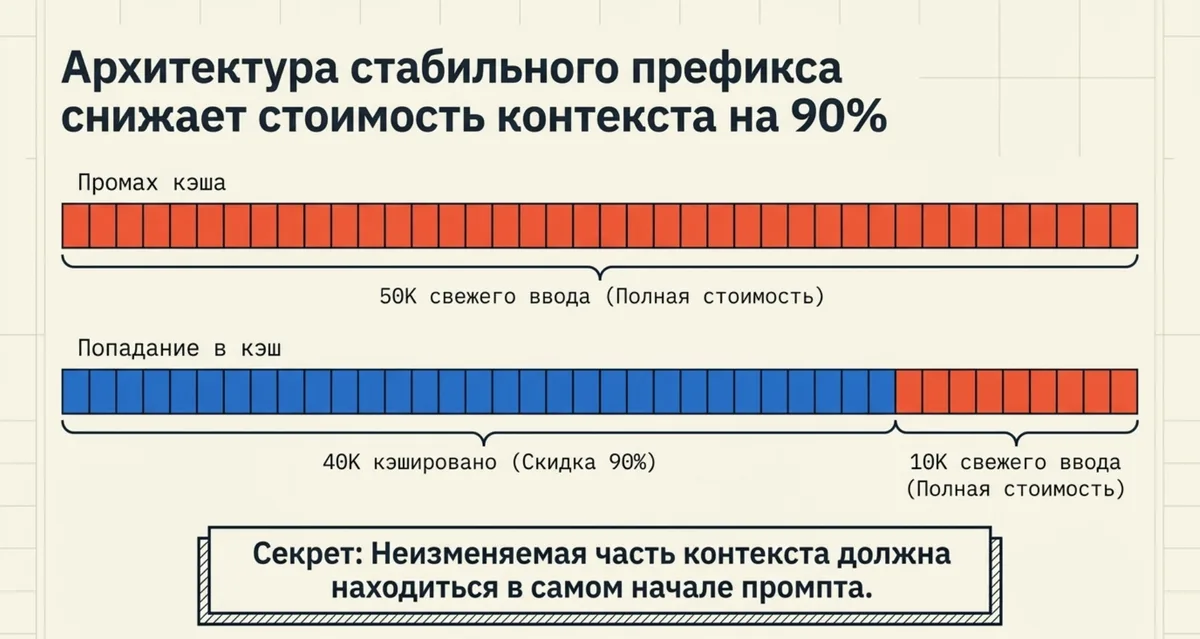
Там, де API підтримує кеш префікса, стабільний шматок, що повторюється (система, правила, довга специфікація), може тарифікуватися як cached input. Стабільний префікс корисніший, ніж початок, що постійно змінюється: динаміка в перших токенах часто ламає влучання в кеш. Кешування не замінює скорочення сміття: ви все одно платите (менше) і все одно витрачаєте вікно. Мінімальний розмір, строк життя (TTL) і структура залежать від провайдера — перевіряйте документацію, перш ніж будувати на кеші бюджет.
Навчальне порівняння (знову вигадані ціни). Той самий логічний контекст у 50 000 токенів: без кешу як звичайний input; з кешем 40 000 cached + 10 000 «свіжого» input. Коли ціна cached у кілька разів нижча за звичайний input, різниця на серії однакових викликів стає помітною. Цифри беріть зі свого білінгу.
Вікно, історія та керування «пам'яттю»
Вікно контексту — ліміт одного виклику. Довготривала пам'ять продукту (нотатки, правила, векторний індекс) живе окремо й потрапляє у вхід, лише коли інструмент її підмішує. На практиці тримайте в історії актуальне й підсумовуйте закриті етапи. Правила й архітектурні нотатки зручніше поза чатом. Передавайте контракти замість цілого модуля, шукайте фрагменти замість читання репозиторію цілком, ріжте задачу на етапи й викидайте застарілі логи.
Компроміс чесний: надто агресивне обрізання породжує пропуски вимог і нові цикли — сумарний рахунок росте. Мета — мінімум сумарної вартості до прийнятого результату, а не найкоротший промпт у логу.
Чому найдешевша модель не завжди заощаджує
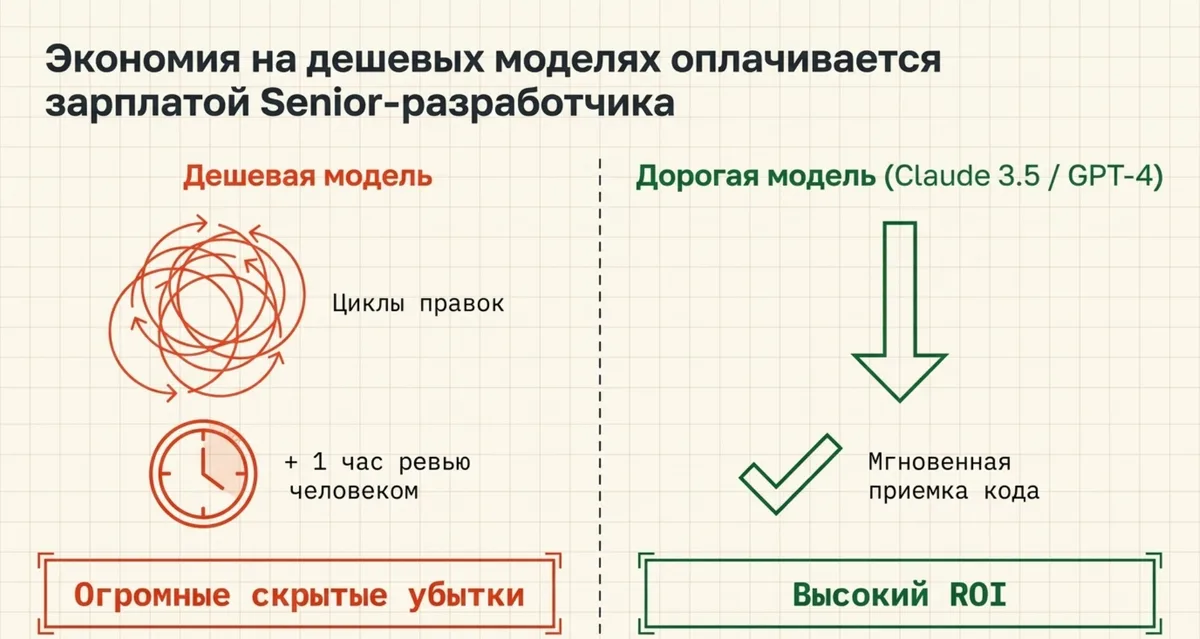
Дві стратегії. Дешева модель із п'ятьма колами правок і годиною вашого рев'ю. Дорожча модель, що частіше закриває критерії з першого-другого проходу. Порівнюйте: вартість виклику; вартість задачі; частку успіхів; кількість повторів; час людини; частку коду, прийнятого без переписування. Головна метрика — вартість успішного результату. Переможець залежить від класу задач, якості інструкцій і приймання; не оголошуйте одну модель «найкращою для всього». Зсув ролі інженера поруч із моделями — в програмісті в епоху ШІ.
Підписка чи API: як порівнювати чесно
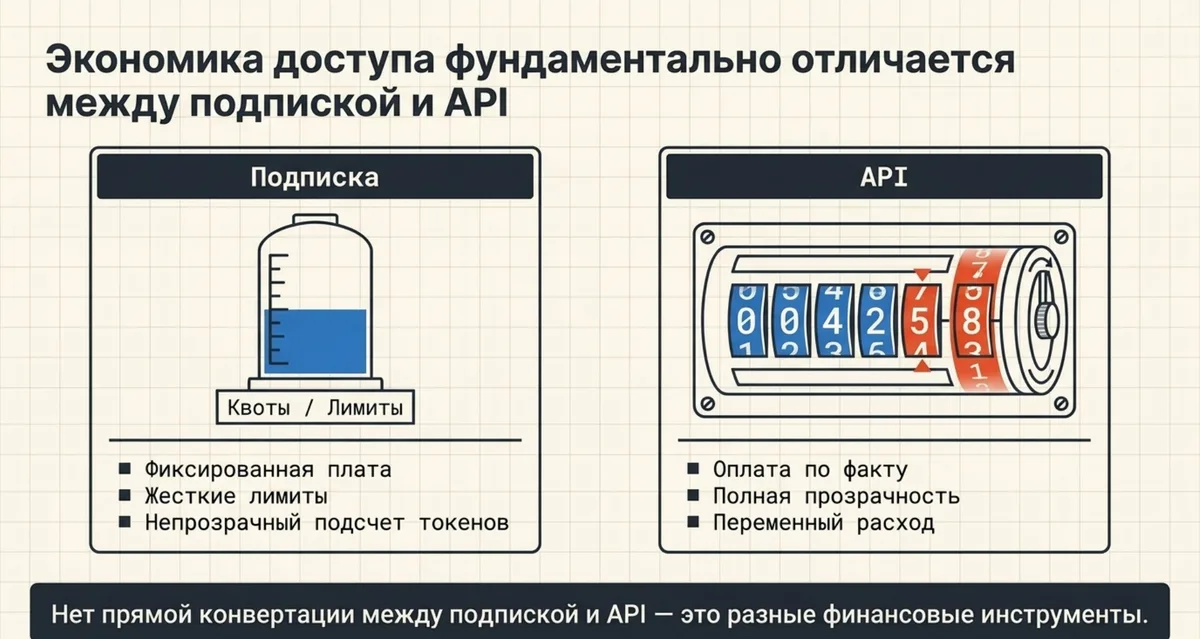
Підписка з квотою, кредити всередині продукту, оплата API за фактом, окремі ліміти на моделі та режими, корпоративні плани — різні контракти. Порівнюйте місячний факт, кількість людей, інтенсивність, доступ до потрібних моделей, правила оновлення лімітів, інструменти навколо, можливість рознести витрати за проєктами, ціну перевищення. Не можна автоматично сказати: «ліміт підписки = N мільйонів API-токенів на суму X». Постачальники рахують квоти по-своєму. Локальні моделі знімають хмарний рахунок, але переносять ціну на залізо й експлуатацію — див. локальні MoE та залізо.
Практичний експеримент: одна задача — кілька моделей
Не заповнюйте таблицю вигаданими переможцями. Використовуйте її як протокол.
Задача-приклад: додати фільтрацію та сортування в React-компонент наявного ERP-модуля, не зламавши типи, API-контракти й тести.
- Одна й та сама стартова ревізія проєкту.
- Однакові критерії готовності.
- Зафіксовані модель, версія, налаштування, інструмент.
- Збираються доступні usage і вартість.
- Рахуються виклики та цикли виправлення.
- Однакові тести, лінтер, збірка.
- Незалежна оцінка якості.
- Повтор за нестабільності.
- Окремо: гроші на модель, час за годинником, ручне доопрацювання.
| Модель і режим | Input | Cached | Output | Виклики | Вартість | Тести | Ручне доопрацювання |
|---|---|---|---|---|---|---|---|
| A | — | — | — | — | — | — | — |
| B | — | — | — | — | — | — | — |
| C | — | — | — | — | — | — | — |
Без такого протоколу «у нас Claude дешевший за GPT» — анекдот, а не вимірювання.
Економіка агента: ціна циклу
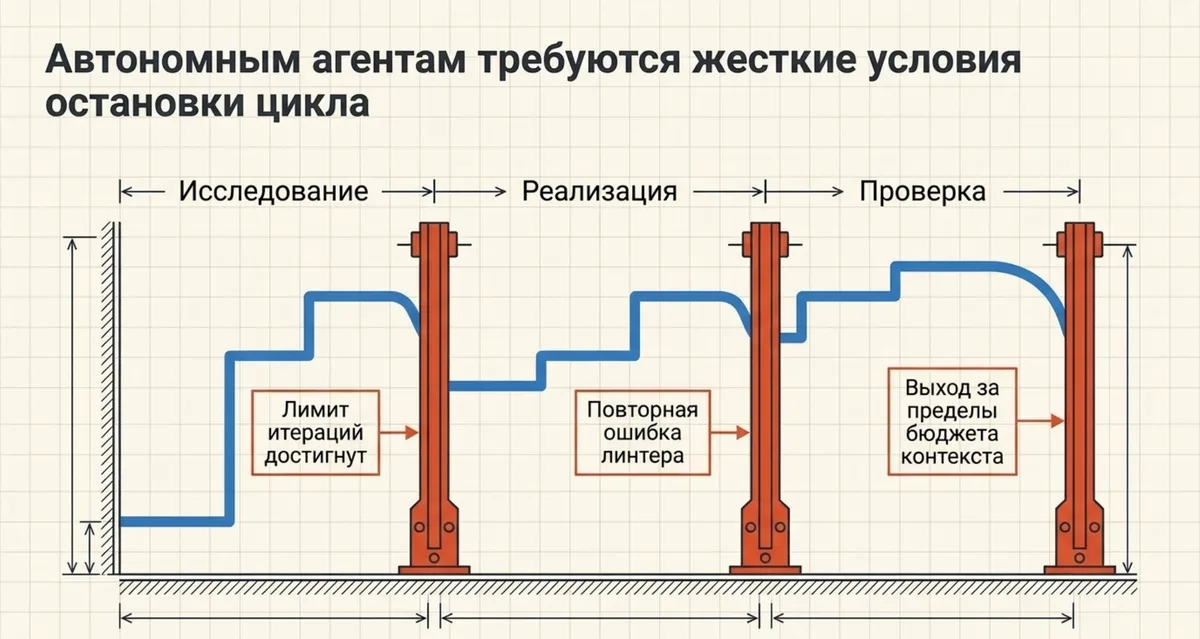
Агент багаторазово викликає модель та інструменти: пошук, читання, правки, тести, розбір логів, знову правки. Модель оцінки:
вартість задачі = сума вартості всіх модельних викликів + інші тарифікувані операції
Обмеження витрат: ліміт ітерацій; явні критерії завершення; бюджет на задачу; стеля розміру логів; лише релевантні тести; стоп за зациклення помилки; обов'язковий звіт про зміни. Запуск коду й зовнішні сервіси можуть коштувати окремо від токенів.
Приклад мислення бюджетом циклу. Дослідження: три виклики пошуку й читання, помірний input. Реалізація: два виклики з генерацією патча. Перевірка: один виклик з урізаним логом падаючого тесту. Разом шість модельних кроків замість «агент крутився сорок хвилин, доки не вперся в ліміт». Якщо на третьому колі та сама помилка лінтера, дешевше зупинити агента й виправити правило проєкту, ніж палити ще десять спроб. Інженерія таких контурів — знову агентна практика.
Як знизити витрати без втрати якості
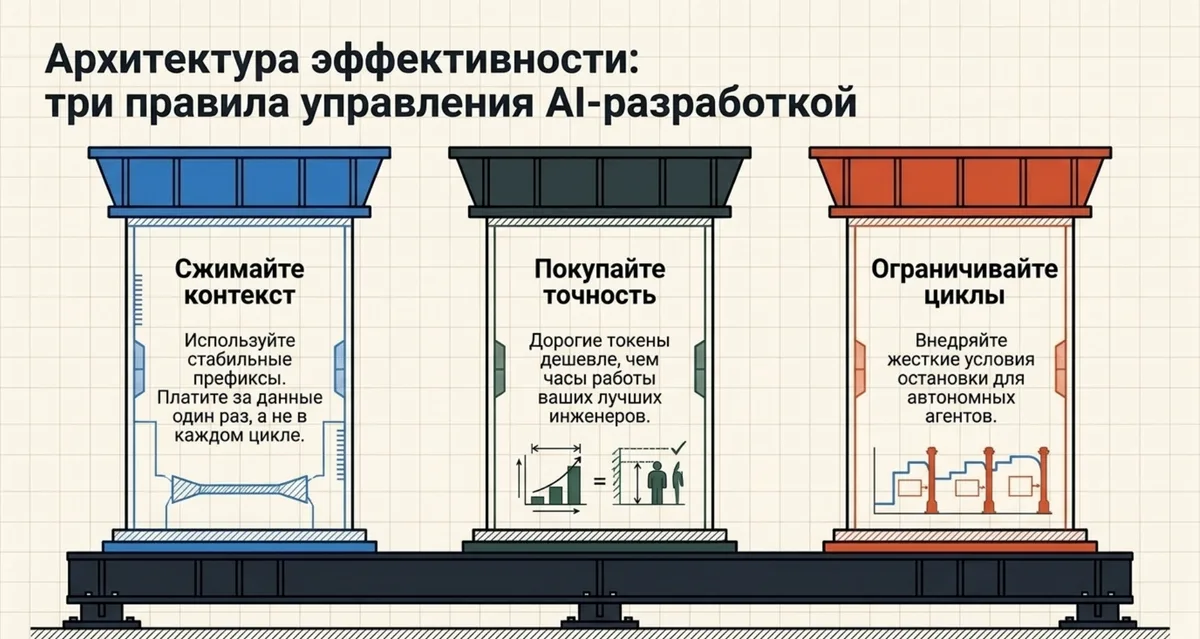
У запиті фіксуйте результат, критерії готовності, обмеження та відомі інтерфейси — без потрійного копіпасту вимог і з мінімальним відтворюваним прикладом. У проєкті тримайте актуальні правила, короткий опис архітектури та команд перевірки; шум із контексту прибирайте, великі зміни ріжте на етапи. В агента задайте стелю циклів і стоп за критеріями; не годуйте гігантськими логами «про всяк випадок»; шукайте замість читання всього; відокремлюйте дослідження від реалізації, коли це ріже повтори. Модель обирайте за класом роботи: легку на формальні дрібниці, сильну на архітектуру й заплутаний аналіз — і дивіться власні заміри з урахуванням кешу в тарифі.
Принцип: не заощаджувати токени ціною нових помилок. Обрізання, що плодить цикли, дорожче за щедрий, але точний контекст.
Бюджет команди
Параметри шаблону: кількість розробників; задач на день; середня кількість викликів на задачу; середній input/output; частка cached; тарифи; запас на повтори; інші інструменти. Груба оцінка:
місяць ≈ кількість задач × середня вартість задачі
Точніше — сума факту за usage і моделями плюс резерв на важкі агентні хвости. Дивіться не лише на середнє: медіана й p95 важливі, бо кілька дорогих задач забирають бюджет. Рознесення витрат за командами — знову в матеріалах про рознесення витрат на токени.
Типові помилки оцінки
Типові пастки: рахувати токени словами чи рядками; враховувати лише видиму відповідь і забувати повтори; плутати вікно контексту з фактично переданим обсягом; вірити, що «завжди йде весь репозиторій»; вважати кеш безкоштовним; порівнювати моделі лише за ціною input; ставити знак рівності між підпискою та API; судити за одним вдалим прогоном; ігнорувати тести та ручне доопрацювання; брати застарілі прайси; плутати рахунок за токени з повною вартістю розробки.
Від токенів до економіки AI-інженерії
Інструменти дедалі частіше самі керують контекстом. Виграш дає маршрутизація задач між моделями, кеш і повторне використання артефактів, спостережуваність витрат на рівні задачі та проєкту. Оцінка зміщується від «ціни виклику» до вартості прийнятої зміни та заощадженого часу. Без обіцянок «через рік усе буде задарма»: рахуйте те, що можете виміряти сьогодні.
Часті запитання
Скільки приблизно коштує один запит в IDE?
Коротка відповідь: від часток цента до доларів за одну задачу — залежить від контексту та кількості циклів, а не від довжини вашої фрази.
Дивіться usage та кількість викликів агента; порівнюйте задачі одного класу.
Чи потрібно завжди вмикати prompt caching?
Коротка відповідь: ні.
Має сенс за стабільного великого префікса та серії схожих викликів. На одноразовому короткому запиті виграш малий.
Чому рахунок росте, хоча я пишу мало?
Коротка відповідь: у вхід ідуть правила, файли, історія та відповіді інструментів.
Відкрийте метрики usage: там зазвичай видно роздутий input.
Чи можна порівнювати тариф Cursor і прямий API за «ціною токена»?
Коротка відповідь: лише з великими застереженнями.
Це різні продукти: квоти, моделі, ліміти й пакування функцій не зводяться до одного рядка прайсу.
Яку метрику поставити на дашборд команди?
Коротка відповідь: вартість успішної задачі та p95 вартості задачі за класами робіт.
Додатково — частка прийнятого коду та час до зелених перевірок.
Що почитати далі
Висновок
Токени вимірюють використання моделі. Цінність вимірюється прийнятою, перевіреною зміною. Контекст і цикли часто дорожчі за коротке запитання. Тарифи беріть з офіційних сторінок на дату розрахунку; навчальні цифри в статті — лише для структури формули. Моделі порівнюйте на однакових задачах. Головна метрика — вартість коректно виконаної роботи з урахуванням перевірки й доопрацювання. Економна AI-розробка — це інженерія контексту, інструментів, вибору моделі та приймання, а не спорт зі скорочення промптів.
Цього тижня достатньо одного кроку: взяти одну реальну задачу з беклогу, виписати кількість викликів і доступний usage та порахувати вартість до зелених тестів — без усереднення «на око».
Коментарі