
Чому модель губить середину довгого документа
На 500 сторінках документації повний контекст дав близько 34% точності. Мала модель відбирає факти до дорогої.
Новини для розробників без шуму — My Dev News у Telegram.

Тег
Усі статті блогу з цим тегом.
На 500 сторінках документації повний контекст дав близько 34% точності. Мала модель відбирає факти до дорогої.
Як обрати метрики якості нейромережі: класифікація, комп’ютерний зір, OCR, LLM і RAG, калібрування та виробничі показники — що вимірювати, щоб модель реально працювала в продукті.
North Small Translate: 218 млрд параметрів, 25 млрд активних, 50 мов. WMT26 83,60 і ліцензія CC BY-NC — сигнал епохи вузьких промислових моделей.
Qwen 3.8 27B на публічних кінцевих точках Cerebras: ~1500 токенів/с, контекст 64k/128k, без прорідження у проді.
Як спроєктувати локальний контур якісного аналізу з Mistral Small 3.1, Ollama і FastAPI — без хибних обіцянок ШІ.
MoE на CMP 90HX терпимо, dense — ні: карта обмежена за типами обчислень. Модифікація драйвера через V67 дає майже ×2, але не знімає всі обмеження.
Як текст стає токенами й векторами, що робить Transformer, чим навчання відрізняється від RAG, і як із Markdown зібрати пошук знань для моделі.
Спочатку продуктове рішення й обмежувачі, потім модель: офлайн-оцінка як інтеграційні тести й розбір помилок.
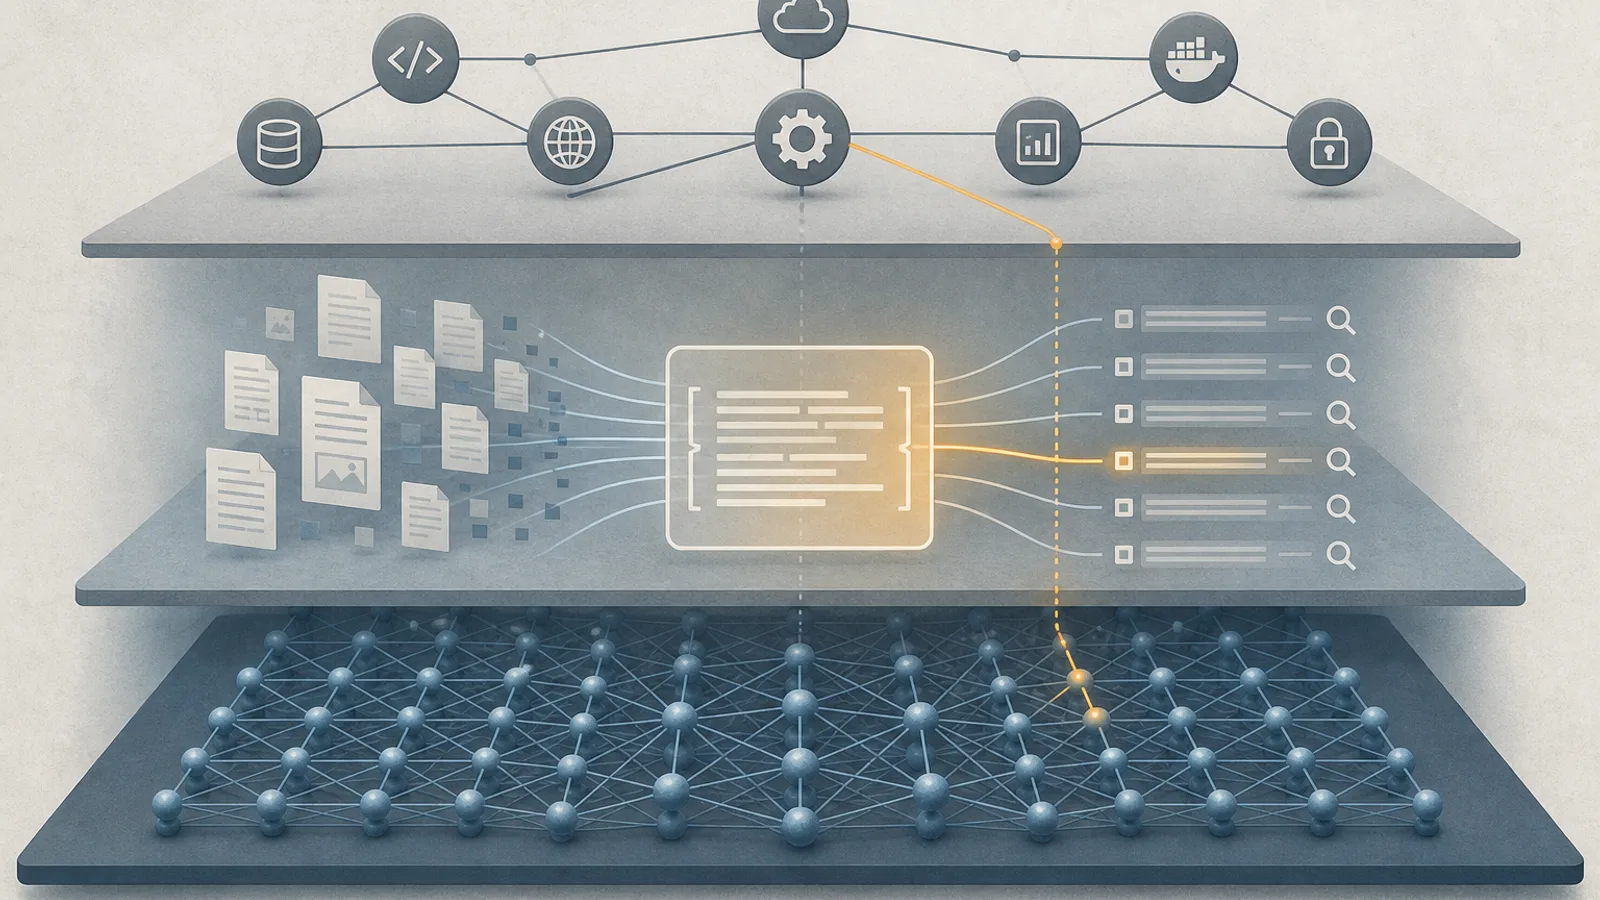
Рівні адаптації мовних моделей: що змінює ваги, що підключає знання й інструменти, і як обрати підхід без «донавчання на PDF».
Мінцифри, УКУ та lang-uk відкрили на Hugging Face відкритий рейтинг LLM українською: переклад, переказ, пошук, логіка, ЗНО.
Чому полегшені моделі плодять виклики інструментів, як бенчмарки брешуть і які метрики рахувати замість ціни за мільйон токенів.
Prime Intellect порівняв 18 моделей на `nanoGPT`: найкращий валідований рахунок у Kimi K3kimi-code, плюс 41 повна траєкторія агента.
Стенд на vLLM і Blackwell: hit rate кешу 96,9%, відношення вхід/вихід 452:1 і чому свій контур беруть не заради економії.
Види перевірок ШІ-моделей: відкриті набори задач, арени, модель-суддя, безпека, регресія продукту й онлайн-сигнали — що кожен тест перевіряє і чого не бачить.
Четверта частина серії про автодоповнення: Language Server Protocol дає типи, визначення й посилання — шар поверх текстового пошуку по репозиторію.
Anthropic публікує system prompts: не «магічні» ролі, а правила рішень, інструментів, невизначеності й UX довгих агентних задач.
Контрприклади й доведення від моделей, втеча з пісочниці, сертифікати Lean: не плутати ланцюжок міркувань із вірним висновком.
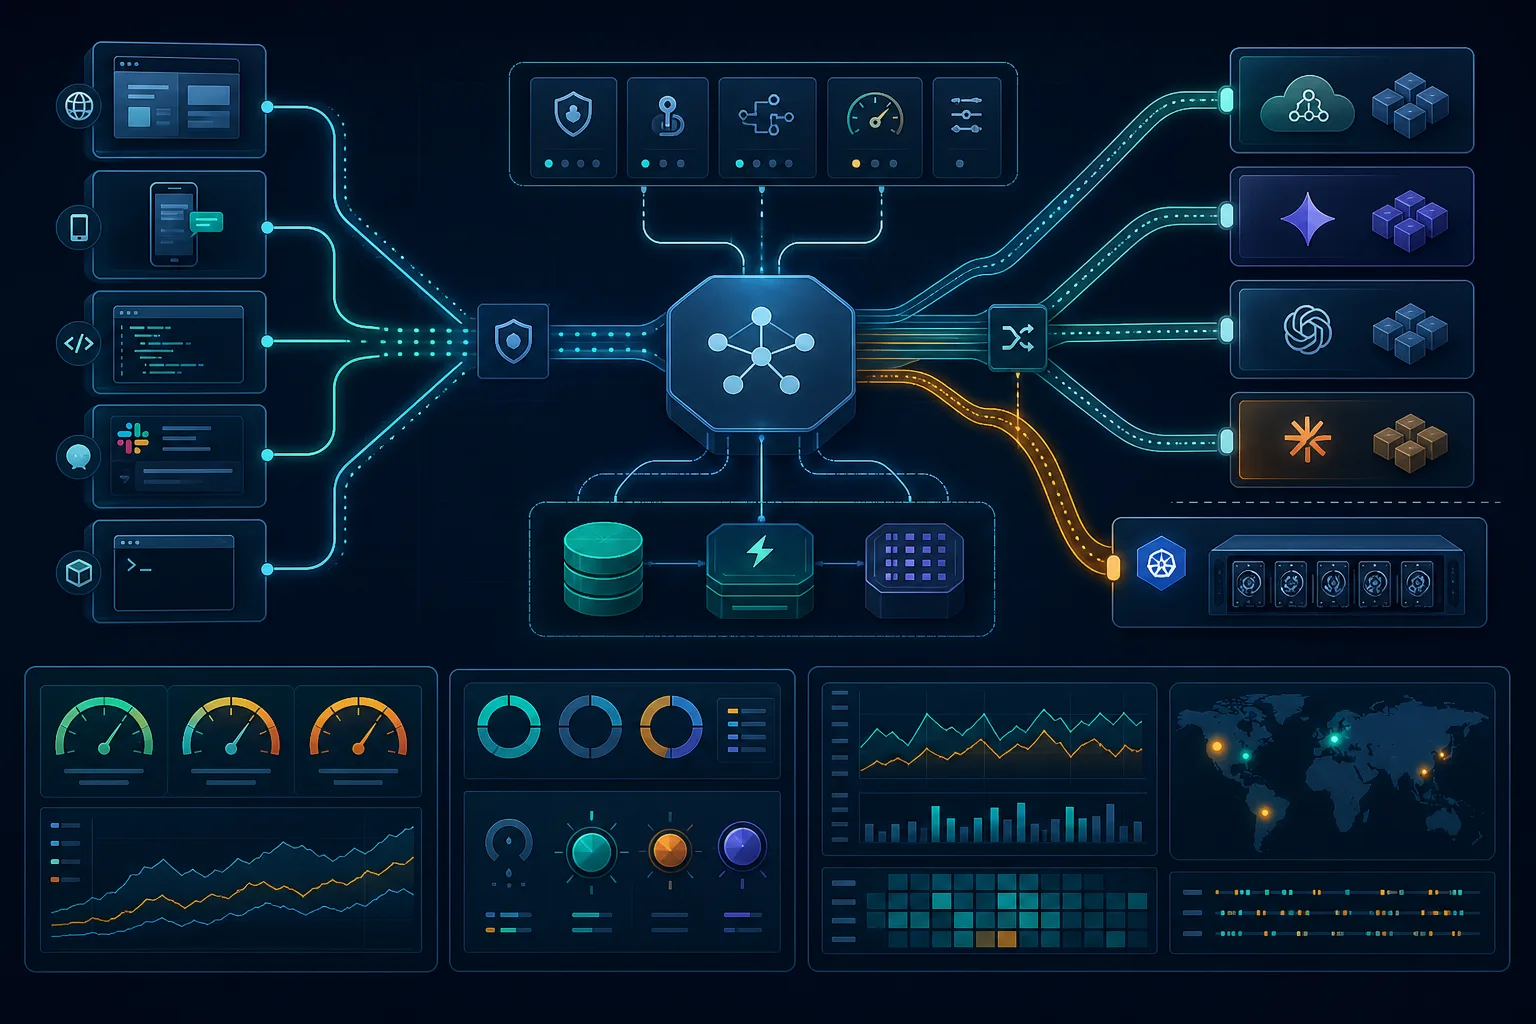
Практичний посібник зі шлюзу LLM і фінансової операційної дисципліни: маршрутизація моделей, бюджети токенів, кешування, відмовостійкість, юніт-економіка та план на 90 днів без жертви якістю відповіді.
Національна наукова ініціатива OpenAI надасть лабораторіям і університетам доступ до моделей, але вирішальними лишаються перевірка й контроль.
Moonshot AI відкрила ваги Kimi K3: як працює MoE, чому 1,4 ТБ змінюють план розгортання та що перевірити в ліцензії.
Як обрати мовну модель для корпоративного ШІ за сценаріями, безпекою, вартістю та вимогами до інфраструктури.
Як запускати відкриті LLM у продакшені: керувати виводом, добирати моделі за завданнями та гарантувати формат відповідей.
Colibri запускає MoE-модель GLM-5.2 без GPU: постійна частина лишається в ОЗП, а експерти зчитуються з NVMe. Розбираємо компроміси.
Тестова MiMo-V2-Pro під назвою Hunter Alpha зібрала трильйон токенів: вирішальними стали якість, ціна й обмеження для даних.
Як обмеження пошуку та експертних систем привели до LLM і чому модель є інтерфейсом до знань, а не пам’яттю підприємства.
Підхід із Claude Desktop, DuckDB і пісочницею: обчислення виконують інструменти, а ШІ працює зі схемою даних і чіткими обмеженнями.
Експеримент із домашнім чат-ботом: як дообучити крихітну локальну LLM через Unsloth і двобуквенні коди категорій замість імен міток.