

Зміст
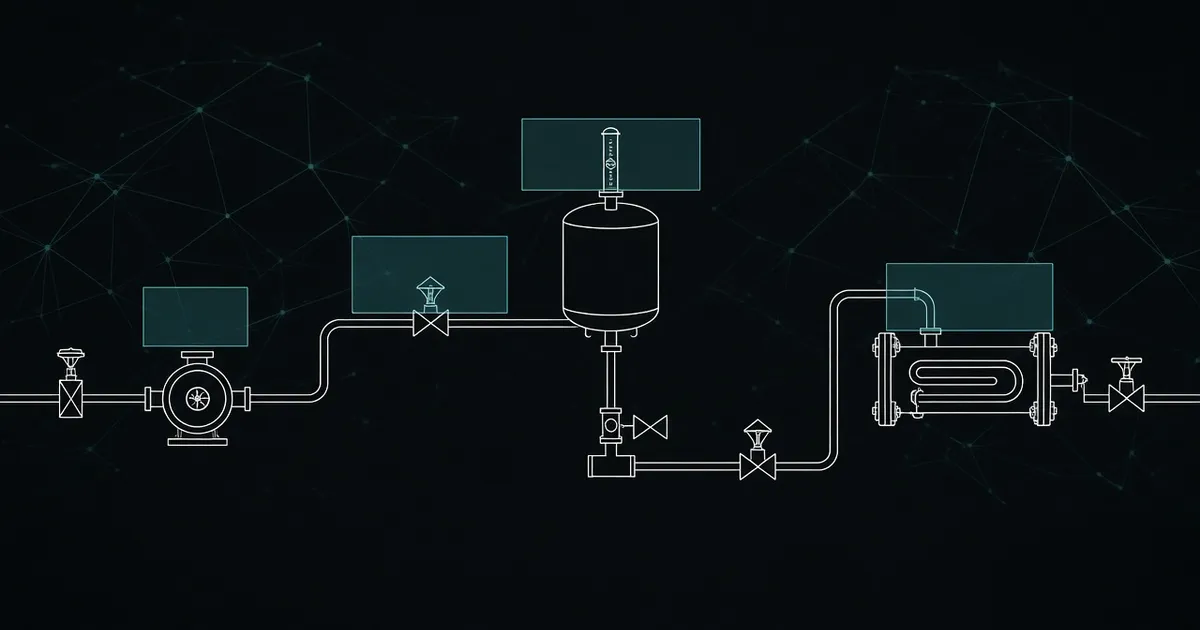
Класифікатор дивиться на картинку і відповідає одним словом: «клапан». На технологічній схемі цього замало. На одному аркуші одночасно насос, кілька клапанів, теплообмінник, резервуар, давачі й підписи на кшталт P-101. Потрібно знати, що знайдено, де воно лежить і наскільки модель у цьому впевнена. Для такої постановки й існує сімейство детекторів YOLO: один прохід зображенням, на виході набір об'єктів із рамками.
Нижче — інженерне пояснення, а не огляд усіх версій поспіль. Розберемо, чим детекція відрізняється від класифікації та сегментації, що саме передбачає мережа, як з'являється власна модель із готових ваг, як збирати розмітку й міряти якість, і чому на схемі YOLO — лише перший шар. Далі потрібні розпізнавання тексту, геометрія ліній, граф зв'язків і вже потім мовна модель. Сусідні матеріали тієї самої дисципліни: від згортки до TrOCR на цифрах, компактна CRNN на замірах і карта зору на рентгенограмах шва.
Ключові висновки
YOLO — детектор, а не «розуміння картинки». Вона вчиться знаходити об'єкти заданих класів і ставити їм рамку. Сенс схеми, текст підпису і зв'язок «насос → клапан» із самих рамок не випливають.
Однієї моделі YOLO не існує. Є ідея «дивишся один раз», сімейство архітектур, конкретний файл ваг і ваша модель після донавчання. Плутати їх — обіцяти замовнику чужий чекпойнт як готовий цех.
Власна модель майже завжди починається з готових ваг. Випадкова ініціалізація і величезний набір — запасний шлях, не перший промисловий крок.
Якість даних важливіша за розмір мережі. Більша архітектура не компенсує криву розмітку, рідкісний клас і витік майже однакових аркушів між навчанням і перевіркою.
На схемі детектор, розпізнавання тексту і лінії відповідають на різні питання. Їх з'єднують у контур. Мовну модель логічніше ставити на вже зібрану структуру, а не замість координат.
Чому однієї мітки на все зображення замало
Класифікація влаштована коротко. Зображення проходить через згорткову мережу, на виході — один клас:
[ зображення ]
      ↓
     CNN
      ↓
    valve
Питання одне: «що зображено?». Воно чесне, коли в кадрі один об'єкт і координати не потрібні. Рукописна цифра у вже вирізаній комірці — саме такий випадок: картинка → клас 7.
Реальний кадр ставить три питання одразу: що знайдено, де воно, наскільки модель упевнена. Відповідь детектора — не рядок, а запис:
{
  "class": "valve",
  "confidence": 0.96,
  "bbox": [120, 240, 180, 310]
}
bbox — обмежувальна рамка: прямокутник навколо об'єкта. Числа — пікселі кутів або еквівалент «центр, ширина, висота». Сенс один: об'єкт прив'язаний до місця на аркуші.
На технологічній схемі в одному кадрі живуть насос, клапани, теплообмінник, резервуар, давачі й текстові позначення. Один класифікатор на весь аркуш змушений обрати «головний» клас і відкинути решту. Можна нарізати аркуш на сотні кропів і класифікувати кожен, але тоді ви самі винайшли детектор — лише повільніше і без спільної картини. Детекція якраз для того, щоб не робити цей обхід вручну.
Що таке YOLO і чим вона не є
YOLO розшифровується як You Only Look Once — «дивишся один раз». Ідея: зображення проходить через модель, і та одразу видає набір виявлених об'єктів, а не шукає їх ковзним вікном по всьому кадру.
                 IMAGE
                   ↓
               YOLO model
                   ↓
     ┌─────────────┼─────────────┐
     ↓             ↓             ↓
   pump          valve          tank
Важливо не склеїти чотири різні речі в одну «модель YOLO»:
- ідея і сімейство архітектур — один прохід, передбачення рамок і класів;
- конкретна версія — ранні сітки і сучасні голови влаштовані по-різному;
- файл ваг — числа, яких мережа вже навчилася;
- готова модель — ваги, навчені на загальному наборі на кшталт побутових фото;
- ваша модель — ті самі стартові ваги після донавчання на ваших схемах.
Ранні версії справді ділили картинку на фіксовану сітку і передбачали кілька рамок у кожній комірці. Сучасні реалізації відійшли від цієї картинки: якорі, передбачення без якорів, окремі голови на різних масштабах. Для інженера важливий контракт виходу — клас, рамка, впевненість — а не легенда про одну сітку 2016 року.
Популярність сімейства тримається на поєднанні, а не на магії. Воно швидке на виведенні. Якість на вузькій задачі дотягується донавчанням. Розмітка рамками простіша за повну маску. Готові ваги дають перенос ознак. Той самий контур уміє не лише детекцію, а в окремих збірках ще й сегментацію та ключові точки. Для першого промислового детектора це практичніше, ніж збирати архітектуру з нуля.
Три постановки: клас, рамка і маска
Порівняння коротке, але від нього залежить уся розмітка.
Класифікація: image → class. Одна мітка, немає місця.
Детекція: image → class + bbox + confidence. Кілька об'єктів, у кожного прямокутник і оцінка впевненості.
Сегментація: image → class + pixel mask. Клас призначають пікселям, а не прямокутнику. Маска повторює форму.
Для обладнання рамки зазвичай достатньо. Насос, клапан, резервуар — компактні символи:
┌────────────┐
│   P-101    │
└────────────┘
Для трубопроводу рамка груба. Труба може йти кутом через половину аркуша, а прямокутник захопить порожнє поле і чужі символи:
┌─────────────────────────────┐
│                             │
└─────────────────────────────┘
Сегментація виділяє саме лінію. Це дорожче в розмітці й у навчанні, зате геометрія з'єднання перестає бути здогадкою за кутами прямокутників. На шві та сама розвилка: рамка зручна для компактного дефекту, маска — коли потрібні площа і форма. На схемі правило те саме. Обладнання — рамки. Процесні лінії — маски, якщо зв'язок «хто з ким з'єднаний» входить у контракт продукту.
Як мережа бачить кадр
Детектор — це згорткова мережа з головою, яка перетворює ознаки на рамки. Перші шари помічають межі, лінії, кути і прості форми. Глибші шари збирають із них частини об'єктів і характерні силуети: коло клапана, корпус насоса, контур резервуара. Це не «розуміння стандарту P&ID». Це статистика форм, якої мережа навчилася на вашій розмітці.
Ролі всередині сучасної YOLO зручно тримати трьома словами.
Остов (backbone) дістає ознаки із зображення. Готові ваги корисні саме тут: краї й текстури вже вміє майже будь-яка мережа, навчена на фотографіях.
Шия (neck) змішує ознаки різних масштабів. Дрібний давач і великий резервуар не живуть в одній роздільності карти ознак. Без багатомасштабності дрібний символ на великому аркуші зникає — той самий ефект, що в детектора дефектів шва без нарізки кадру.
Голова детекції перетворює карти ознак на передбачення: координати, клас, впевненість. Її якраз і доучують найсильніше, коли домен новий, а остов уже «бачить».
Що саме передбачає детектор
Рамку задають чотири числа. Часто це центр, ширина і висота, іноді кути. У файлі розмітки YOLO вони нормалізовані: діляться на ширину і висоту картинки і лежать від 0 до 1. Так одна й та сама мітка переживає зміну розміру кадру.
Клас — ціле з вашого словника:
0 = pump
1 = valve
2 = tank
3 = exchanger
Мережа не «знає слово pump». Вона видає розподіл за індексами. Ім'я класу живе в конфігу поруч із вагами. Переставити рядки словника і не перенавчити — значить мовчки перейменувати насос на клапан.
Впевненість (confidence) — число, яким модель супроводжує рамку. Його використовують як поріг: нижче 0.25 відкинути, вище лишити. Це не калібрована ймовірність у статистичному сенсі. 0.96 не означає «у 96 випадках зі 100 тут точно клапан», поки ви не перевірили калібрування на своєму тесті. Поріг — робочий важіль точності й повноти, а не фізична істина.
Однакових класів на аркуші може бути багато:
pump
pump
pump
valve
valve
Детектор якраз для цього. Класифікатор на весь аркуш такий список не віддасть.
Як одна модель знаходить багато об'єктів
Єдиний прохід означає, що мережа не запускається окремо на кожен можливий прямокутник. Вона дивиться на карти ознак і одразу пропонує багато кандидатів: на різних масштабах і в різних місцях кадру. Серед кандидатів більшість — тло. Їх відрізають порогом впевненості.
Далі лишається практична неприємність: на один клапан модель часто пропонує кілька рамок, що перекриваються.
        ┌───────────────┐
        │     valve     │
        └───────────────┘

   ┌──────────────┐
   │    valve     │
   └──────────────┘
Придушення немаксимумів (NMS, non-maximum suppression) лишає рамку з найбільшою впевненістю і видаляє сусідів, які перекривають її занадто сильно. «Занадто сильно» міряють перетином.
Перетин до об'єднання (IoU, intersection over union):
IoU = площа перетину / площа об'єднання
Дві майже однакові рамки дають IoU, близький до 1. Рамки, що ледь торкаються, — близький до 0. Поріг NMS каже, за якого перекриття вважати передбачення дублем одного об'єкта. Окремий поріг впевненості каже, які кандидати взагалі доходять до цього кроку.
IoU потрібен не лише в постобробці. Під час оцінки якості ним же вирішують, чи збіглася передбачена рамка з еталонною. Клас вірний, а рамка з'їхала на сусідній символ — це не влучання, якщо перетин нижчий за домовлену межу. Тому у звіті не можна писати голе «mAP 0.8»: потрібні назва методики і пороги IoU.
Власна модель: готові ваги і донавчання
Свою YOLO не збирають із випадкових шарів у перший день проєкту. Звичайний шлях такий:
готові ваги YOLO
       ↓
ваш набір
       ↓
донавчання
       ↓
ваш детектор схем
Готові ваги — мережа, яка вже вміє виділяти краї, кути і грубі форми об'єктів на звичайних фотографіях. Вона не бачила ваш стандарт оформлення схем. Вона бачила світ достатньо, щоб не вчити «що таке лінія» з нуля.
Перенесення навчання (transfer learning) — адаптація цих навичок до нового домену. Аналогія проста: людина, яка вміє читати кресленики іншого заводу, швидше вивчить ваші умовні позначення, ніж людина, яка вперше бачить лінію на папері. Ваги остова — цей уже наявний навик. Донавчання рухає їх до ваших символів.
Навчання з нуля виглядає інакше:
випадкові ваги
      ↓
великий набір
      ↓
довге навчання
Воно виправдане, коли домен візуально далекий від фотографій, набір величезний, а готові ваги стійко заважають. Для першого детектора насосів і клапанів це майже завжди гірший старт: довше, дорожче і легше не зійтися. Донавчання — не гарантія якості. Воно лише дає розумну початкову точку. Погана розмітка зіпсує і її.
Детальніше про те, коли донавчання взагалі доречне, а коли спочатку треба лагодити дані, — у матеріалі про донавчання. Дисципліна набору, а не чекпойнта, — в інженерії датасетів.
Датасет: розмітка, розрізи і помилки як нові приклади
Набір для YOLO — це пари файлів:
images/
labels/
Картинка scheme-014.jpg і мітка scheme-014.txt з тим самим іменем. У кожному рядку мітки один об'єкт:
0 0.52 0.41 0.10 0.14
Перше число — індекс класу. Далі центр за x, центр за y, ширина і висота, усі від 0 до 1 відносно кадру. 0.52 0.41 — об'єкт трохи правіше і вище середини. 0.10 0.14 — він займає близько десятої ширини і сьомої висоти аркуша. Помилка в індексі класу не видна оком на рамці: прямокутник вірний, ім'я неправильне. Такі помилки тихо псують точність.
Набір ділять на три частини. Навчання рухає ваги. Перевірка (validation) дивиться, чи не завчила мережа навчальні аркуші, і за нею обирають пороги й момент зупинки. Тест чіпають рідко: це незалежна оцінка перед розмовою про якість, а не ще одна ручка для підбору. Найчастіший витік на схемах — покласти майже однакові версії одного аркуша в навчання і в перевірку. Мережа «впізнає» аркуш, метрика бреше, на новому стандарті оформлення все розвалюється. Ріжте за документами і за джерелами, не за випадковими файлами з однієї папки.
Універсального числа «потрібно рівно 1000 картинок» немає. Важливіші розмаїття, число об'єктів (на одному аркуші їх десятки), складність, якість рамок і те, чи схожі входи на майбутній потік: скан, фото, експорт із CAD, інший контраст. Баланс класів ламає рідкісні символи:
pump       5000
valve       800
tank        150
Мережа чесно вивчить насос і пропускатиме резервуар. Лікується це не гаслом «візьміть модель більшу», а додатковими прикладами рідкісного класу і чесною метрикою за класами, а не одним середнім.
Помилки моделі — джерело наступних даних. Цикл коротший за будь-яку суперечку про архітектуру:
набір → навчання → модель → помилки → складні приклади → набір+ → знову навчання
Складний приклад (hard example) — кадр, на якому поточна модель уже помилилася: блік, нестандартний символ, щільний вузол арматури, чужий штамп. Його розмічають і повертають у набір. Це той самий прийом, що в пілоті бланків: спірне поле не «довчають гаслом», а кладуть в еталон.
Аугментація — штучні спотворення під час навчання: масштаб, виріз, поворот, яскравість, шум, розмиття, перспектива, сліди стиснення. Вона корисна, коли повторює реальний вхід. Для схем вона небезпечна, коли змінює сенс: відбиття може перевернути напрям потоку, сильний поворот — зробити допустимий символ недопустимим. Спотворення має бути таким, яке ви готові побачити в проді.
Як проходить навчання і чи потрібен GPU
Цикл той самий, що в будь-якої навчуваної мережі, тільки функція втрат дивиться одразу на три речі: чи є об'єкт, де рамка і який клас.
image → прямий прохід → передбачення → втрати → зворотне поширення → оновлення ваг
Деталі функції втрат залежать від версії сімейства. У першій статті їх не потрібно зубрити. Достатньо контракту: мережу штрафують і за пропуск, і за з'їхалу рамку, і за невірний клас. Не можна «добре класифікувати» і при цьому стабільно малювати рамку на сусідньому символі — сумарні втрати це покарають.
Епоха — один прохід навчальним набором. Батч — пачка картинок, за якою рахують один крок оновлення. Швидкість навчання — розмір кроку. Завеликий крок розкидає ваги, замалий застрягає. Перенавчання видно на парі кривих: якість на навчанні зростає, на перевірці падає. Мережа запам'ятала аркуші, а не символи.
Графічний процесор для навчання бажаний: той самий донавчальний прогін займає хвилини або години замість діб. Для виведення картина інша. Один аркуш на секунду часто тягне звичайний процесор. Відеокарта на виведенні потрібна за великого потоку, жорсткої затримки або важкої моделі. Навчання й експлуатація — різні машини:
машина навчання
     ↓
файл ваг / ONNX
     ↓
сервер виведення на CPU
Наявність відеокарти в експерименті не означає відеокарту в контурі замовника.
Як вимірювати якість і які помилки рахувати
Точність (precision): з усього, що модель знайшла, яка частка була вірною. Низька точність — багато хибних тривог.
Повнота (recall): з усього, що на аркуші було, яку частку модель знайшла. Низька повнота — пропуски.
Обережна модель мало бреше і багато пропускає. Агресивна знаходить майже все і засмічує кадр зайвими рамками. Поріг впевненості рухає вас цією віссю. Для схеми пропуск клапана і хибний клапан — різні гроші; поріг обирають за ціною помилки, не за гарним середнім.
AP (average precision) стискає криву точності й повноти за одним класом в одне число. mAP — середнє AP за класами. Воно залежить від порогів IoU і від того, як рахують влучання. Порівнювати дві моделі можна лише за однакової методики. Один клас із п'ятьма прикладами здатний зіпсувати або намалювати середнє — дивіться таблицю за класами.
Типові помилки корисніші за одну цифру:
- хибна тривога — клапан там, де його немає;
- пропуск — клапан є, рамки немає;
- помилка класу — насос названо теплообмінником, рамка при цьому на місці;
- помилка локалізації — клас вірний, рамка з'їхала;
- дубль — один об'єкт двома рамками, поріг
NMSне дотиснув.
Пропуски легко сховати, якщо дивитися лише точність. На схемі пропуск часто дорожчий за зайву рамку: відсутній клапан не потрапить у граф.
Що сильніше за архітектуру
Порядок впливу на перший реліз майже завжди такий:
- якість вихідних зображень;
- якість рамок і індексів класів;
- розмаїття джерел;
- чесний розріз навчання, перевірки і тесту;
- повернення складних помилок у набір;
- швидкість навчання, епохи, пороги;
- розмір і ім'я архітектури.
Більша модель не компенсує поганий набір. Вона дорожче вчиться, охочіше запам'ятовує криву розмітку і повільніше працює на виведенні. Спочатку маленька або середня голова на чистих рамках. Ускладнення — коли стелю виміряно, а не коли «цього року так прийнято».
YOLO на технологічних схемах
На P&ID і близьких креслениках детектору природно віддати компактні символи: насос, клапан, резервуар, компресор, теплообмінник, фільтр, давач, прилад, двигун. Словник має бути таким, який ви готові розмічати стабільно. Сто класів «про всяк випадок» розмазують рідкісні символи і зривають узгодження імен.
Текст — окреме рішення.
Підхід А: детектор знаходить області тексту, кроп іде в розпізнавання (OCR / CRNN). Плюс — текст прив'язаний до рамки, його простіше зіставити з сусіднім символом. Мінус — ви розмічаєте ще один клас і залежите від того, як детектор ріже рядок.
Підхід Б: окрема система сама шукає і читає текст. Плюс — не змішуєте словники обладнання і літер. Мінус — зіставлення «підпис P-101 належить цьому насосу» стає геометричною задачею вже після обох контурів.
На бланках ми вже бачили, що універсальна модель зору на весь аркуш плутає порожні комірки і геометрію. На схемі той самий урок: детектор символів не повинен за сумісництвом бути єдиним читцем підписів. Зв'язка задач така:
YOLO → де об'єкт?
CRNN / OCR → що написано?
Сегментація → де лінія?
Збирач графа → що з чим з'єднано?
Мовна модель → що ця структура означає?
Спеціалізовані моделі тут не змагаються. Вони закривають різні питання. CRNN сильна на послідовності символів і слабка як шукач насоса. YOLO сильна як шукач насоса і не читає P-101. Сучасний OCR буває і не CRNN — важливий контракт «рядок на кропі», не ім'я архітектури.
Чому детектор не розуміє схему
Після вдалого прогону у вас є список:
P-101 — pump
V-101 — valve
E-101 — exchanger
Цього недостатньо, щоб стверджувати:
P-101 → V-101 → E-101
Рамки не зберігають напрям потоку і не знають, яка лінія чия, якщо труби перетинаються. Детекція — не розуміння. Розуміння починається, коли об'єкти, підписи і лінії зібрані в граф, а граф перевірений правилами: чи немає клапана без лінії, чи не висить підпис у порожнечі, чи сходиться позначення з типом символу.
Мовну модель можна підключити двома способами.
Перший — віддати їй картинку і попросити відповідь. Швидкий прототип, зручний огляд. Слабкі місця: повноту по всьому аркушу важко гарантувати, координати плавають, зв'язки на великому кресленику губляться, повтор того самого аркуша не зобов'язаний дати той самий граф.
Другий — спочатку зір і геометрія, потім структура, потім модель:
зображення → зір → структура → мовна модель
Так простіше валідувати, застосовувати інженерні правила і не плутати «модель гарно розповіла» з «усі клапани знайдені». Мовна модель тут інтерпретує граф: шукає аналогії, пояснює контур, відповідає за базою знань. Вона не малює пропущену рамку.
Контур із кількох моделей
Практичний каркас, який варто намалювати до вибору ваг:
                    СХЕМА
                      │
                      ▼
                попередня обробка
                      │
         ┌────────────┴────────────┐
         ▼                         ▼
   детекція символів            текст
         │                         │
         ▼                         ▼
    обладнання               читання рядка
         │                         │
         └────────────┬────────────┘
                      ▼
              лінії і геометрія
                      │
                      ▼
                 логіка зв'язків
                      │
                      ▼
                     ГРАФ
                      │
                      ▼
           правила і мовна модель
Передобробка — поворот скана, обрізка полів, єдиний масштаб. Без неї детектор учиться на кривих фотографіях замість символів. Далі два паралельні зори: символи і текст. Потім лінії. Потім правила з'єднання: хто торкається якої лінії, який підпис ближчий до якого символу (P-101 → насос, V-101 → клапан). Граф — перший продукт, який можна тестувати без розмови про «інтелект». Мовна модель і пошук за знаннями — шар зверху.
Дорожня карта за етапами, а не одним релізом:
1. Детектор обладнання
2. Читання позначень
3. Лінії
4. Геометрія з'єднань
5. Граф
6. Інженерні перевірки
7. Інтерпретація і пошук знань
Кожен етап має свій тест. Не можна закрити етап 1 метрикою етапу 7.
Мініпроєкт, виведення й експлуатація
Короткий навчальний детектор збирається так. Сто–триста зображень. Три–п'ять класів: для першої проби хоч pump, valve, tank, хоч побутові об'єкти, якщо промислових сканів ще немає. Рамки. Розріз без витоку схожих кадрів. Готові ваги. Донавчання. Точність, повнота, mAP і обов'язковий перегляд помилок. Складні кадри назад у набір. Повтор.
Це протокол, не звіт про прогін. Має сенс заздалегідь запланувати кілька заходів і дивитися не одну цифру: базовий прогін, прогін із обережною аугментацією, прогін зі складними прикладами, прогін із розширеним набором, окреме налаштування порогів уже після того, як ваги зафіксовано. Пороги не навчають мережу заново — вони обирають робочу точку точності й повноти.
Після навчання лишаються ваги. Файл у форматі навчання ще не є експлуатацією. Далі експорт під конкретний рантайм: вихідний формат, ONNX, за потреби прискорювач на кшталт TensorRT. Формат обирають за тим, де модель житиме, а не за модою.
Виведення на одному кадрі:
зображення
 ↓
розмір і попередня обробка
 ↓
детектор
 ↓
відсів за впевненістю
 ↓
придушення дублів
 ↓
JSON
{
  "objects": [
    {
      "class": "pump",
      "confidence": 0.97,
      "bbox": [120, 200, 240, 320]
    }
  ]
}
Експлуатація — це затримка, пропускна здатність, пам'ять, розмір файлу, контейнер, версія ваг і моніторинг помилок на живих аркушах. Фраза «на тесті було 97%» не описує жоден із цих пунктів. Після релізу цикл той самий, що в набору: живі помилки → розмітка → нова версія даних → навчання → оцінка → випуск. Модель не «готова назавжди» в момент першого файлу ваг.
Часті помилки
Одразу беруть найбільшу модель і не встигають розмітити рідкісний клас.
Кадрів мало і всі з одного експортера. На чужому штампі детектор сліпне.
Рамки криві, індекси класів переплутані, один символ розмічений по-різному у двох людей.
Майже однакові аркуші потрапили і в навчання, і в перевірку.
Дивляться один mAP і не відкривають пропуски.
Намагаються однією YOLO і знайти насос, і прочитати підпис, і відновити граф.
Вважають, що донавчання само собою робить модель хорошою.
Ігнорують дублі й пороги, а потім сперечаються про якість ваг.
Часті питання
YOLO — це одна конкретна нейромережа?
Ні. Це сімейство детекторів зі спільною ідеєю одного проходу. Версія архітектури, файл готових ваг і ваша модель після донавчання — різні об'єкти. У розмові із замовником їх не можна називати одним іменем.
Чи потрібно писати мережу з нуля?
Для першого детектора обладнання — ні. Беруть готові ваги і донавчають на своїх рамках. Навчання з випадкового старту має сенс пізніше, якщо виміряна стеля донавчання вперлася в чужий домен, а набір уже великий.
Скільки картинок потрібно?
Заздалегідь чесного числа немає. Дивляться число об'єктів за класами, розмаїття джерел і частку помилок на перевірці. Тисяча майже однакових сканів гірша за двісті різних. Рідкісний клас у десятки прикладів важливіший за ще одну тисячу насосів.
Впевненість 0.99 означає, що об'єкт точно є?
Ні, поки ви не відкалібрували оцінку на своєму тесті. Це рахунок, за яким ріжуть список. Робочу точку обирають за ціною пропуску і хибної тривоги.
Чи вистачить процесора без відеокарти?
Вчити комфортніше на відеокарті. Виводити один кресленик часто можна на звичайному процесорі, якщо модель не гігантська і потік не сотні аркушів на секунду. Машину навчання і машину виведення розділяють.
Чи може YOLO прочитати напис P-101?
Як детектор — ні. Вона може знайти область тексту. Рядок читає окрема модель розпізнавання. Зв'язка «рамка символу + рамка тексту + близькість на аркуші» вже збирає відповідність «P-101 — цей насос».
Навіщо сегментація, якщо рамки вже є?
Рамка погано описує довгу ламану трубу. Якщо продукт зобов'язаний знати з'єднання, лінію краще розмічати маскою. Якщо продукт лише перелічує обладнання, маска поки не потрібна.
Куди ставити мовну модель?
Після графа. На сирій картинці вона зручна для прототипу і слабка як гарантія повноти. На структурі вона пояснює і шукає, а пропущений клапан лишається проблемою детектора, яку видно в тесті.
Що почитати далі
Поруч на сайті вже є контури, з яких цей детектор виростає, а не замінює їх.
- Як навчити мережу читати рукописні цифри — клас, послідовність і коли не потрібен важкий розпізнавач.
- Компактна CRNN для замірів — читання короткого рядка на кропі.
- Чому однієї моделі замало на бланку — геометрія, впевненість і людина в контурі.
- Зір на рентгенограмі шва — рамка проти маски на промисловому кадрі.
- Інженерія датасетів — версія набору, витоки й еталон.
- Коли потрібне донавчання — донавчання як зміна поведінки, не як склад документів.
- Як навчають мовні моделі — щоб не плутати детектор і шар інтерпретації.
Наступний практичний крок цієї лінії — окремий розбір навчання на P&ID: словник класів, інструмент розмітки, конфіг запуску, матриця помилок і експорт в ONNX. Його має сенс писати вже з виміряним прогоном, а не з планом прогону.
Висновок
YOLO не «розуміє картинку». Вона вчиться знаходити об'єкти обраних класів і позначати їхнє положення. На технологічній схемі цього достатньо, щоб зняти шар обладнання, і недостатньо, щоб знати, що з чим з'єднано і що написано поруч.
Власну модель починають із готових ваг, вузького словника і чесної розмітки. Якість тримають повнотою і пропусками, а не одним середнім балом. Відеокарта прискорює навчання і не зобов'язана стояти біля кожного сервера виведення.
Інтелектуальний контур з'являється, коли детектор стоїть поруч із читанням тексту, лініями, правилами графа і, лише потім, мовною моделлю. Цього тижня корисний мінімум — розмітити п'ятдесят аркушів на три класи і подивитися, які символи мережа плутає. Цей список помилок вартий більше, ніж зміна архітектури до першого прогону.
Коментарі