Содержание
Курьер несёт посылку в двух коробках разного размера. На складе всё влезает, на пороге клиента — нет: пришлось смять края. С нейросетью та же ловушка: в обучении картинку «подогнали» одним способом, в проде — чуть другим, и модель тихо теряет качество, хотя веса те же. Этот урок не учит читать цифры. Он договаривается об одной коробке для всех моделей курса.
В уроке 1 мы собрали лабораторию и зафиксировали зерно. Сегодня — следующий слой серии «Обучаем CNN и CRNN с нуля»: картинка → тензор.
Нейросеть не видит картинку как глаз. PNG на диске — сжатый файл с пикселями; для сети это слишком «человеческий» формат. На входе ей нужна таблица чисел: каждый пиксель — одно число яркости. Такую таблицу в коде называют массивом (в NumPy — ndarray, в PyTorch — tensor; для этого урока слова «массив» и «тензор» почти синонимы: таблица чисел с известной формой).
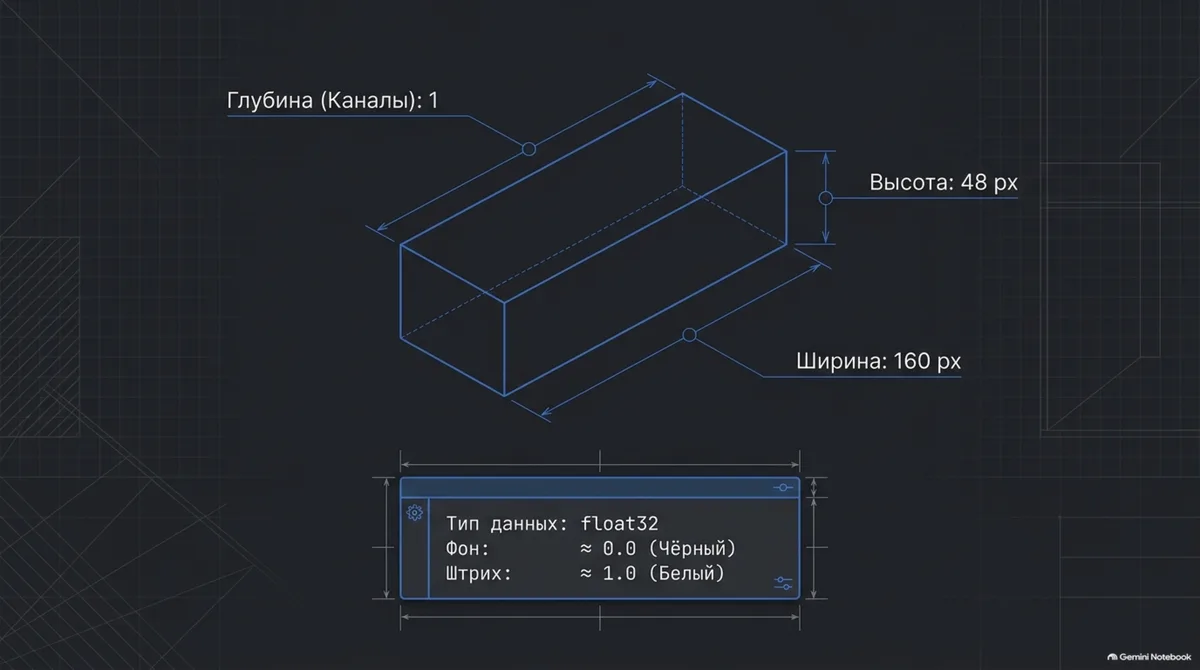
Задача урока — договориться об одном формате этой таблицы для всех моделей курса. Каждый кроп клетки превращается в массив формы [1, 48, 160]: не «список из трёх чисел», а трёхмерная таблица размером 1 × 48 × 160 — всего 1 × 48 × 160 = 7680 чисел, по одному на каждый «пиксель» входа.
Тип float32 — как эти числа хранятся в памяти. Это число с плавающей точкой (дробь) в 32 битах: можно записать не только 0 и 1, но и 0.06, 0.77, 0.98. Целые байты картинки (0…255, тип вроде uint8) для обучения неудобны: сети считают градиенты и веса в дробях. Поэтому после подготовки мы делим яркость на 255 и получаем значения примерно в отрезке [0, 1] именно как float32. В контракте курса: фон (бумага и паддинг) около 0, штрих (чернила) ближе к 1.
Форма [1, 48, 160] читается как канал × высота × ширина — так картинки обычно лежат в PyTorch. Единица спереди: один канал яркости (серый), не RGB. Дальше 48 строк и 160 столбцов. В Pillow чаще думают «ширина × высота» или «высота × ширина × каналы»; здесь порядок другой. Если перепутать оси, сеть увидит «перевёрнутую» геометрию, а тесты на форму (1, 48, 160) сразу покажут ошибку.
Зачем договариваться заранее? И CNN из урока 7, и CRNN из урока 11 будут получать на вход одно и то же. Если препроцессинг в обучении и в проде отличается хотя бы в мелочи, модель тихо теряет качество, и найти причину потом очень трудно. Поэтому вся подготовка картинки живёт в одном файле.
Слово контракт здесь буквальное: это не «красивый препроцессинг», а обещание остальной части курса. Любая будущая модель вправе рассчитывать, что на входе уже лежит [1, 48, 160], float32, фон около нуля, штрих около единицы. Нарушили обещание в одном месте — сломались и обучение, и прод, и сравнение экспериментов.
Четыре шага: серый → контраст → letterbox → инверсия
До первой модели (детектор появится только в уроках 7–9) картинка проходит четыре обязательных превращения. Вместе они и есть контракт. Код ниже повторяет их по порядку; здесь — смысл каждого слова из заголовка урока.
1. Серый. Цвет клетке бланка не нужен: цифра читается по яркости штриха на бумаге. Три канала RGB раздувают вход втрое и учат сеть лишним оттенкам сканера. Мы оставляем один канал яркости (L в Pillow): каждое число — «насколько светлый пиксель», от 0 (чёрный) до 255 (белый). Отдельно чиним прозрачные PNG: «пустой» пиксель часто хранит чёрный цвет с нулевой непрозрачностью — без белой подложки серый фон превратится в кляксу чернил.
2. Контраст. Сканы и синтетика бывают тусклыми: чернила серые, бумага тоже серая, разница маленькая. Растяжение контраста раздвигает этот коридор к краям 0…255, чтобы тусклый кроп не отличался от яркого. Но на пустой клетке раздвигать нечего — там только шум бумаги. Обычный autocontrast сделает из шума «текст»; поэтому у нас autocontrast_safe с порогом: почти однородный кроп не трогаем.
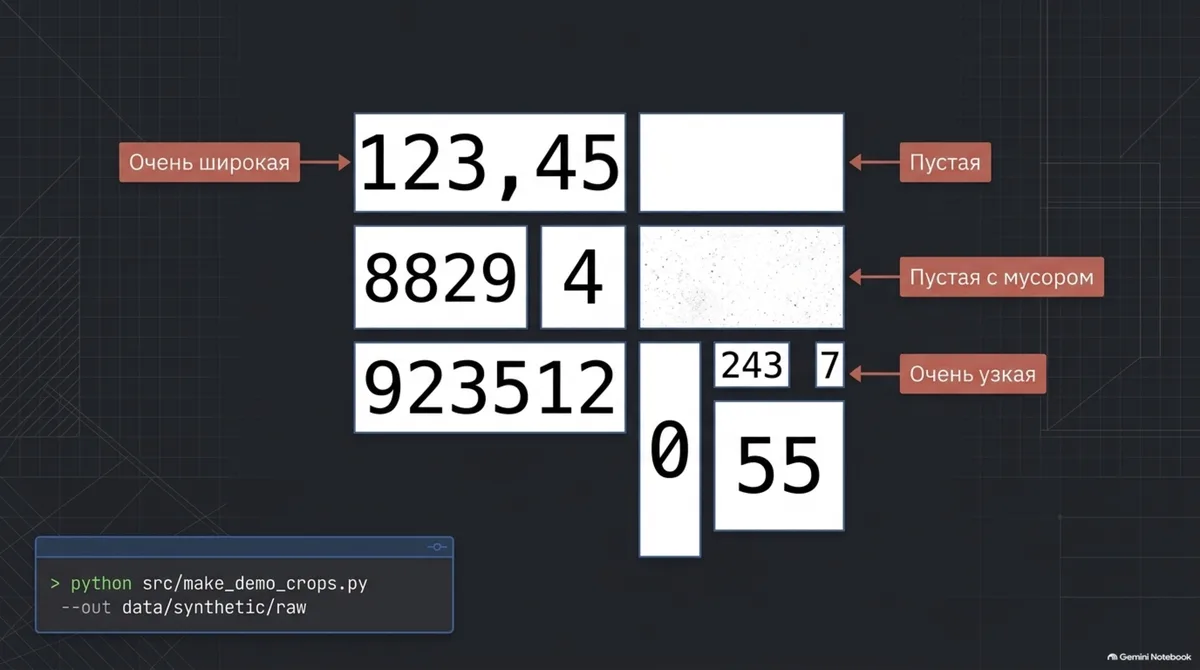
3. Letterbox. Кропы приходят разными: узкая «7», широкая «123,45». Сети нужен один размер — холст 48×160. Слово letterbox — как чёрные полосы у фильма на широком экране: картинку вписывают целиком, пропорции не ломают, пустое место заливают фоном. Альтернатива — растянуть до 48×160 — сплющит цифры. Мы масштабируем с scale = min(…), прижимаем текст влево, по вертикали центрируем.
4. Инверсия. Пока холст похож на бумагу: белый фон, тёмные чернила. После деления на 255 бумага становится около 1, а штрих — около 0. Чернила, которые модель должна замечать, оказываются маленькими числами, а белый паддинг — большими. Инверсия 1 − значение переворачивает шкалу: штрих ≈ 1, фон и паддинг ≈ 0. Пустое место холста и участок без чернил дают модели одно и то же значение — ноль.
После этих четырёх шагов на выходе лежит тензор формы [1, 48, 160] типа float32 — тот самый вход, который обещает контракт курса. Все следующие модели будут принимать именно его.
Файлы урока
src/image_to_tensor.py— препроцессинг: серый → контраст → вписать в холст 48×160 → инверсия.src/make_demo_crops.py— вспомогательный скрипт: рисует 9 демо-кропов разных размеров (цифры и пустые клетки). Полноценный генератор будет в уроке 4.experiments/show_preprocess_grid.py— вспомогательный скрипт: сетка «исходник | холст | тензор».tests/test_image_to_tensor.py— тесты контракта.
Эталон для сверки, если что-то не работает: lesson-02. Клонировать его не нужно: файлы урока вы дописываете в свой репозиторий из урока 1 и коммитите.
Предскажи
Раздел «Предскажи» — не оценка. Перед запуском вы фиксируете ожидание: форму тензора, значение паддинга после инверсии, судьбу пустой клетки при растягивании контраста. После команд сравниваете прогноз с терминалом и сеткой. Расхождение здесь ценнее совпадения: так видно, где интуиция про картинки ошибалась.
Перед запуском запишите ответы:
- Какие форма и тип будут у результата?
- После инверсии паддинг (пустое место, которым мы добиваем картинку до 48×160) будет равен 0 или 1?
- Что случится с пустой клеткой, если «растянуть» её контраст до диапазона 0–255?
Установка и демо-кропы
Окружение и репозиторий — из урока 1. Сначала наберите в репозитории файл src/make_demo_crops.py — короткий скрипт, который рисует девять демо-кропов разных размеров. Это не ядро препроцессинга, а материал для проверки letterbox и защиты контраста. Полный генератор данных появится в уроке 4.
src/make_demo_crops.py
"""Несколько искусственных кропов для уроков 2–3 (полный генератор будет в уроке 4)."""
import argparse
from pathlib import Path
import numpy as np
from PIL import Image, ImageDraw, ImageFont
# (текст, часть имени файла, ширина, высота)
SAMPLES = [
("7,3", "7_3", 120, 40),
("12/14", "12_14", 200, 50),
("0,85", "0_85", 150, 60),
("105", "105", 90, 45),
("1-2", "1-2", 100, 40),
("123,45", "123_45", 380, 70), # очень широкий
("7", "7", 40, 50), # очень узкий
("", "empty", 120, 45), # пустая клетка
("", "empty_noisy", 140, 45), # пустая клетка с мусором
]
def get_font(size: int):
try:
return ImageFont.load_default(size=size)
except Exception: # старый Pillow или нет FreeType
return ImageFont.load_default()
def draw_crop(text: str, w: int, h: int, rng: np.random.Generator, noisy: bool) -> Image.Image:
paper = rng.integers(225, 256)
arr = rng.normal(paper, 3.0, size=(h, w)).clip(0, 255).astype(np.uint8)
img = Image.fromarray(arr, mode="L")
draw = ImageDraw.Draw(img)
if text:
pad = int(rng.integers(6, 13))
size = int(h * 0.6)
font = get_font(size)
bbox = draw.textbbox((0, 0), text, font=font)
while bbox[2] - bbox[0] > w - 2 * pad and size > 8:
size -= 2
font = get_font(size)
bbox = draw.textbbox((0, 0), text, font=font)
ink = int(rng.integers(20, 70))
x = pad - bbox[0]
y = (h - (bbox[3] - bbox[1])) // 2 - bbox[1]
draw.text((x, y), text, fill=ink, font=font)
if noisy:
draw.line([(0, h - 4), (w, h - 4)], fill=150, width=1) # край клетки
for _ in range(6): # пятнышки
cx, cy = int(rng.integers(0, w)), int(rng.integers(0, h))
draw.ellipse([cx, cy, cx + 2, cy + 2], fill=int(rng.integers(90, 160)))
return img
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--out", default="data/synthetic/raw")
ap.add_argument("--seed", type=int, default=42)
args = ap.parse_args()
out = Path(args.out)
out.mkdir(parents=True, exist_ok=True)
rng = np.random.default_rng(args.seed)
for text, name, w, h in SAMPLES:
img = draw_crop(text, w, h, rng, noisy=name.endswith("noisy"))
path = out / f"sample_{name}.png"
img.save(path)
print(f"{path} ({w}x{h}) text={text!r}")
if __name__ == "__main__":
main()Список SAMPLES задаёт текст и размер каждого кропа: широкая строка, узкая семёрка, две пустые клетки. draw_crop рисует шум бумаги и, если нужно, цифры или мусор на пустой клетке. Зерно по умолчанию --seed 42, чтобы у всех получились те же файлы.
Затем сгенерируйте демо-кропы из корня репозитория:
python src/make_demo_crops.py --out data/synthetic/rawПример вывода на теге lesson-02:
data/synthetic/raw/sample_7_3.png  (120x40)  text='7,3'
data/synthetic/raw/sample_12_14.png  (200x50)  text='12/14'
data/synthetic/raw/sample_0_85.png  (150x60)  text='0,85'
data/synthetic/raw/sample_105.png  (90x45)  text='105'
data/synthetic/raw/sample_1-2.png  (100x40)  text='1-2'
data/synthetic/raw/sample_123_45.png  (380x70)  text='123,45'
data/synthetic/raw/sample_7.png  (40x50)  text='7'
data/synthetic/raw/sample_empty.png  (120x45)  text=''
data/synthetic/raw/sample_empty_noisy.png  (140x45)  text=''
В папке появятся девять PNG разной ширины и высоты: 7,3, 12/14, 0,85, 105, 1-2, очень широкая строка 123,45, очень узкая 7 и две пустые клетки (одна из них с мусором). Размеры разные намеренно: именно с этим и придётся справляться препроцессингу.
Код: печатаем руками
make_demo_crops.py уже выше. Дальше набираете ядро image_to_tensor.py и тесты; скрипт сетки — в следующем разделе. Если вывод не сходится, сверьтесь с тегом lesson-02.
src/image_to_tensor.py
"""Картинка → тензор: единый контракт входа для моделей курса (1×48×160).
Ядро написано на NumPy, чтобы его можно было проверять без PyTorch;
в тензор превращает тонкая обёртка image_to_tensor().
"""
import argparse
import numpy as np
from PIL import Image, ImageOps
CANVAS_H = 48
CANVAS_W = 160
PAD_FILL = 255 # фон холста: белая бумага (после инверсии станет 0)
MIN_CONTRAST_RANGE = 30 # если в кропе меньше 30 уровней яркости, контраст не растягиваем
def load_image(source) -> Image.Image:
"""Принимает путь или готовый PIL-образ."""
if isinstance(source, Image.Image):
return source # уже открытый образ (тесты, Dataset)
return Image.open(source) # путь к файлу
def to_gray_on_white(img: Image.Image) -> Image.Image:
"""В оттенки серого; прозрачность подкладывается на белый фон."""
has_alpha = img.mode in ("RGBA", "LA") or (img.mode == "P" and "transparency" in img.info)
if has_alpha:
rgba = img.convert("RGBA")
white = Image.new("RGBA", rgba.size, (255, 255, 255, 255)) # белая подложка
img = Image.alpha_composite(white, rgba) # иначе прозрачность станет чёрной
return img.convert("L") # один канал яркости
def autocontrast_safe(img: Image.Image, min_range: int = MIN_CONTRAST_RANGE) -> Image.Image:
"""Растягивает контраст, но не трогает почти однородные кропы.
Пустая клетка почти однородна. Если растянуть её контраст до 0..255,
шум бумаги превратится в «текст».
"""
lo, hi = img.getextrema() # мин/макс яркости в кропе
if hi - lo < min_range:
return img # почти однородно: не раздуваем шум бумаги
return ImageOps.autocontrast(img) # растягиваем контраст до 0..255
def letterbox(img: Image.Image, h: int = CANVAS_H, w: int = CANVAS_W,
fill: int = PAD_FILL) -> Image.Image:
"""Вписывает картинку в холст h×w без искажения пропорций.
По горизонтали прижимаем влево (текст начинается всегда с одного места),
по вертикали центрируем. Остаток холста заливаем фоном.
"""
w0, h0 = img.size
scale = min(w / w0, h / h0) # вписать целиком, без растяжения
new_w = max(1, round(w0 * scale))
new_h = max(1, round(h0 * scale))
resized = img.resize((new_w, new_h), Image.Resampling.LANCZOS)
canvas = Image.new("L", (w, h), fill) # белый холст 48×160
canvas.paste(resized, (0, (h - new_h) // 2)) # влево + по вертикали центр
return canvas
def preprocess_array(source) -> np.ndarray:
"""Путь или PIL-образ → float32-массив [1, 48, 160]: фон ≈ 0, штрих ≈ 1."""
img = load_image(source)
if min(img.size) == 0:
raise ValueError("пустое изображение (нулевой размер)")
gray = to_gray_on_white(img)
gray = autocontrast_safe(gray)
canvas = letterbox(gray)
arr = np.asarray(canvas, dtype=np.float32) / 255.0 # [0, 1], бумага ≈ 1
return (1.0 - arr)[None, :, :] # инверсия: штрих ≈ 1, паддинг = 0; канал впереди
def image_to_tensor(source):
"""То же, но в виде torch.Tensor."""
import torch # импорт здесь: ядро выше не требует torch
return torch.from_numpy(preprocess_array(source))
def main() -> None:
ap = argparse.ArgumentParser(description="Показать результат препроцессинга одного кропа")
ap.add_argument("--image", required=True)
args = ap.parse_args()
arr = preprocess_array(args.image)
zero_cols = int((arr[0].max(axis=0) == 0).sum()) # столбцы чистого паддинга
print(f"shape={arr.shape} dtype={arr.dtype} "
f"min={arr.min():.3f} max={arr.max():.3f} mean={arr.mean():.3f}")
print(f"полностью нулевых столбцов (паддинг): {zero_cols} из {arr.shape[2]}")
if __name__ == "__main__":
main()Разберём функции по порядку.
load_image. Принимает путь или готовый PIL-образ. Так одну и ту же функцию удобно вызывать и из тестов, и из будущего Dataset.
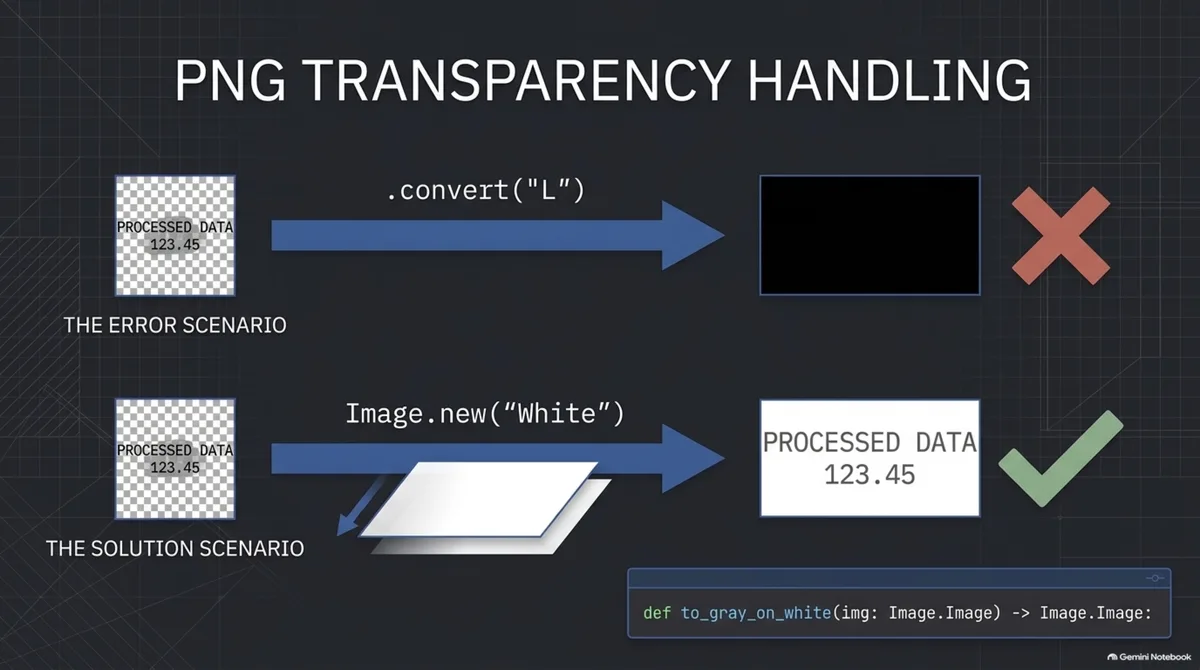
to_gray_on_white. Это шаг «серый» из карты выше. Переводит в один канал яркости: цвет отбрасываем, остаётся «светлее / темнее». Есть нюанс с прозрачностью: у PNG с прозрачным фоном «пустые» пиксели хранят чёрный цвет с нулевой непрозрачностью. Если просто вызвать convert("L"), прозрачный фон станет чёрным, а модель решит, что вся картинка залита чернилами. Поэтому сначала подкладываем белую подложку — как лист бумаги под плёнку с дырками.
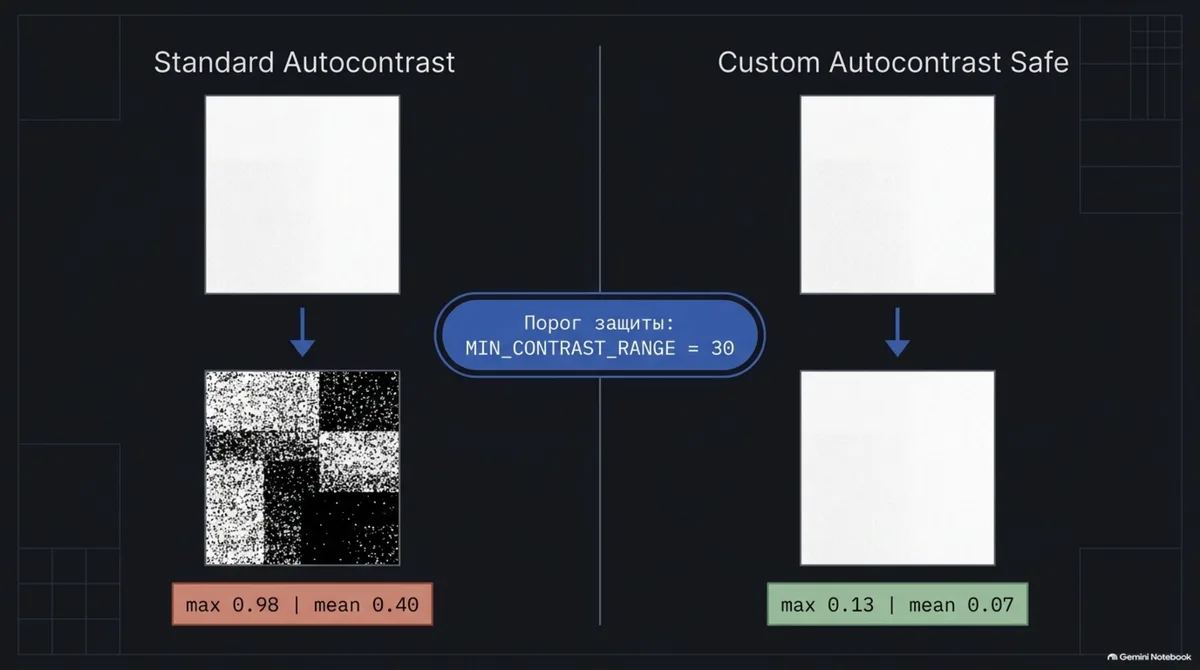
autocontrast_safe. Это шаг «контраст». Растягивает яркости, чтобы тусклые кропы не отличались от ярких: самый тёмный пиксель кропа уезжает к 0, самый светлый — к 255, середина растягивается пропорционально. Но у функции есть защита, и вот зачем. Пустая клетка почти однородна: в ней только лёгкий шум бумаги. Обычный autocontrast честно растянет этот шум на весь диапазон 0–255, и клетка превратится в «текст». На нашем демо-кропе empty без защиты максимум после препроцессинга получается 0.98 при среднем 0.40, а с защитой — 0.13 при среднем 0.07. Это важно: через несколько уроков мы будем учить детектор отличать пустые клетки от заполненных, и ему нельзя подсовывать пустые клетки, превращённые в шум. Порог MIN_CONTRAST_RANGE = 30 — наш выбор; подробнее о его цене в разделе «Ещё нет».
На пальцах: пусть яркости в кропе лежат в узком коридоре, скажем от 230 до 245 (hi − lo = 15). Обычный autocontrast растянет 230 → 0 и 245 → 255: серый шум бумаги станет контрастным «рисунком». Защита смотрит именно на разницу hi − lo: меньше 30 — кроп не трогаем. Настоящий текст с бледными, но различимыми чернилами обычно даёт размах больше порога и проходит растяжение как надо.
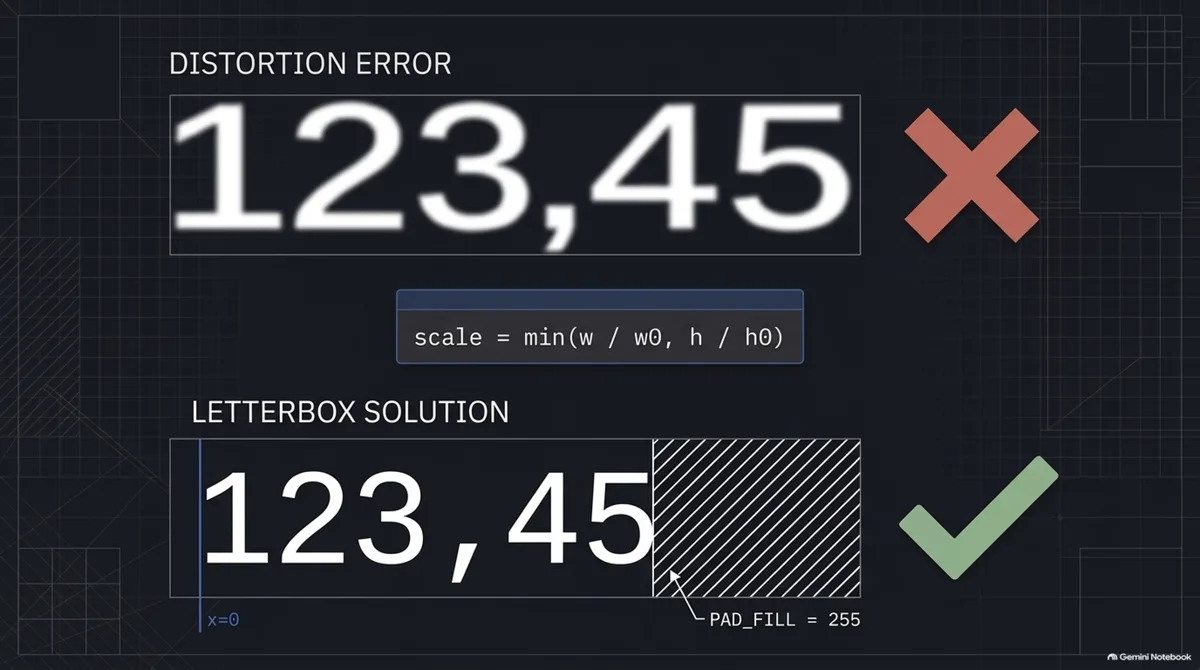
letterbox. Это шаг «вписать в холст». Название — из видео: картинку кладут на фиксированный кадр так, чтобы она целиком влезла, а пустые поля залили фоном. Если вместо этого растянуть широкий кроп до 48×160, буквы станут приплюснутыми, а модель должна читать нормальные пропорции. Поэтому масштабируем с сохранением сторон и добиваем остаток фоном (PAD_FILL = 255, белая «бумага»). По горизонтали прижимаем влево (текст всегда начинается с одного места), по вертикали центрируем.
Числа для демо-кропа 7,3 размером 120×40: scale = min(160/120, 48/40) = min(1.333…, 1.2) = 1.2. Новая картинка ≈ 144×48 — по высоте ровно влезла, по ширине справа остаётся полоса в 160 − 144 = 16 столбцов. Именно это печатает CLI: «полностью нулевых столбцов … 16 из 160». Для узкой 7 (40×50) ограничивает ширина холста слабее высоты: картинка вырастает по вертикали до 48, по горизонтали остаётся узкой — и паддинг справа занимает большую часть кадра (122 из 160). Прижим влево важен заранее: и детектор, и читатель строки будут ждать, что символы начинаются с одного и того же края, а не «плавают» по центру.
preprocess_array. Собирает все четыре шага подряд и в конце делает инверсию: 1 - arr. Это не отдельная «пятая магия», а перевод холста в язык контракта: фон около 0, штрих около 1. Зачем именно так? Паддинг мы заливаем белым (255), после инверсии он ровно 0: «пустое место холста» и «нет чернил» совпадают, и паддинг не создаёт ложных штрихов. Если бы мы не инвертировали, нулями пришлось бы добивать тёмные «штрихи» — а тогда и бумага, и паддинг жили бы в разных шкалах.
Три последних операции в числах. asarray(...)/255.0 переводит байты 0…255 в доли 0…1 (белая бумага ≈ 1, тёмный штрих ≈ 0). 1.0 - arr переворачивает шкалу: бумага → около 0, штрих → около 1. [None, :, :] добавляет ось канала спереди: из матрицы (48, 160) получается (1, 48, 160). Без этой оси позже нельзя сложить несколько кропов в один батч одной и той же формы.
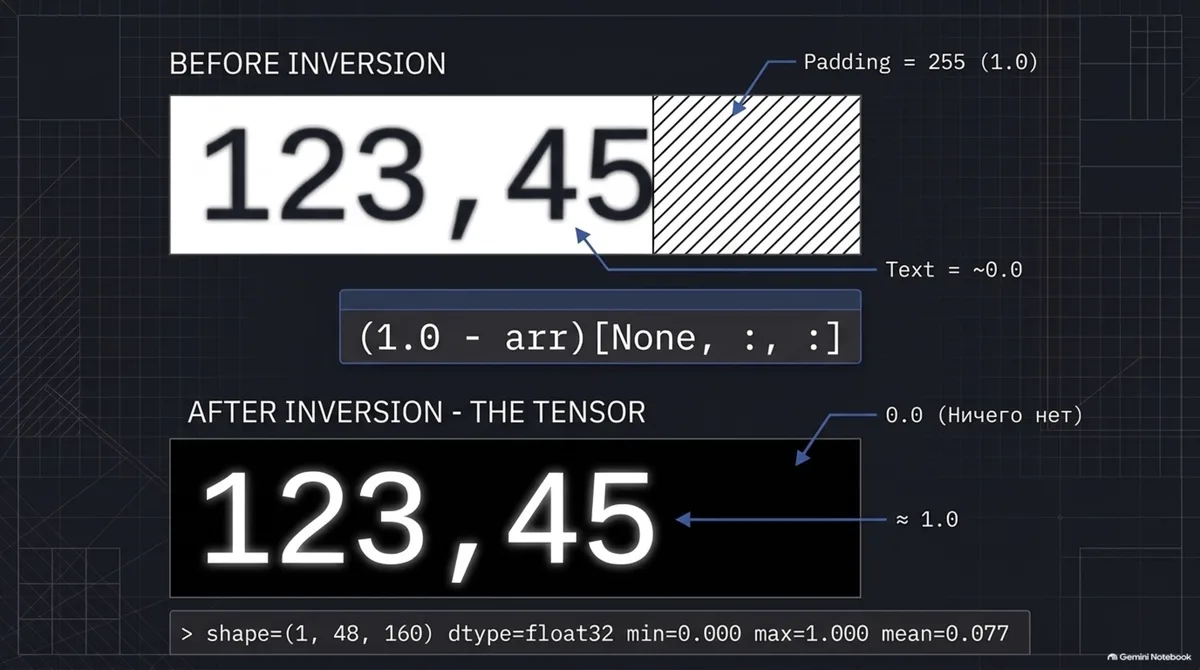
image_to_tensor. Тонкая обёртка: torch.from_numpy(...). Импорт torch стоит внутри функции намеренно: всё остальное считается на NumPy, поэтому ядро можно проверять и без PyTorch.
Запуск на широком и узком кропе:
python src/image_to_tensor.py --image data/synthetic/raw/sample_7_3.png
python src/image_to_tensor.py --image data/synthetic/raw/sample_7.png
Пример вывода на теге lesson-02 (в третьем знаке значения могут чуть плавать от версии Pillow):
shape=(1, 48, 160) dtype=float32 min=0.000 max=1.000 mean=0.077
полностью нулевых столбцов (паддинг): 16 из 160

shape=(1, 48, 160) dtype=float32 min=0.000 max=1.000 mean=0.017
полностью нулевых столбцов (паддинг): 122 из 160
Форма и тип — ответ на первый вопрос «Предскажи». У узкой «7» паддинг занимает большую часть холста (122 из 160 столбцов ровно нулевые) — ответ на второй вопрос: после инверсии паддинг равен 0.
Как читать строку CLI. shape и dtype — сам контракт. min / max показывают, что значения влезли в отрезок [0, 1]. mean — доля «светлых» (штриховых) пикселей по всему холсту: у узкой «7» среднее меньше, потому что почти весь кадр — нулевой паддинг. «Полностью нулевых столбцов» считает столбцы, где максимум по высоте равен 0: справа чистый паддинг без единого штриха. Это не «сколько пикселей нулевых», а именно целые пустые колонки — удобный индикатор letterbox.
tests/test_image_to_tensor.py
import sys
from pathlib import Path
import numpy as np
import pytest
from PIL import Image
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from image_to_tensor import CANVAS_H, CANVAS_W, preprocess_array # noqa: E402
def text_like(w: int, h: int, bg: int = 240, ink: int = 30) -> Image.Image:
"""Светлый фон и тёмный «штрих» посередине."""
img = Image.new("L", (w, h), bg)
img.paste(ink, (w // 4, h // 4, w // 2, 3 * h // 4))
return img
def test_shape_dtype_range():
arr = preprocess_array(text_like(200, 50))
assert arr.shape == (1, CANVAS_H, CANVAS_W)
assert arr.dtype == np.float32
assert arr.min() >= 0.0 and arr.max() <= 1.0
def test_ink_is_bright():
arr = preprocess_array(text_like(200, 50))
assert arr.max() > 0.9
def test_horizontal_padding_is_zero_for_narrow_image():
arr = preprocess_array(text_like(40, 50)) # после масштаба ширина ≈ 38
assert np.all(arr[0, :, 40:] == 0.0)
def test_vertical_padding_is_zero_for_wide_image():
arr = preprocess_array(text_like(400, 30)) # после масштаба высота ≈ 12
assert np.all(arr[0, :10, :] == 0.0)
assert np.all(arr[0, -10:, :] == 0.0)
def test_empty_crop_noise_is_not_amplified():
rng = np.random.default_rng(0)
noise = rng.normal(240, 3, size=(45, 120)).clip(0, 255).astype(np.uint8)
arr = preprocess_array(Image.fromarray(noise, mode="L"))
assert arr.max() < 0.2
def test_transparent_background_becomes_white():
img = Image.new("RGBA", (100, 40), (0, 0, 0, 0)) # полностью прозрачная картинка
arr = preprocess_array(img)
assert arr.max() < 0.01
def test_zero_size_image_raises():
with pytest.raises(ValueError):
preprocess_array(Image.new("L", (0, 10)))
def test_tensor_wrapper():
torch = pytest.importorskip("torch")
from image_to_tensor import image_to_tensor
t = image_to_tensor(text_like(200, 50))
assert tuple(t.shape) == (1, CANVAS_H, CANVAS_W)
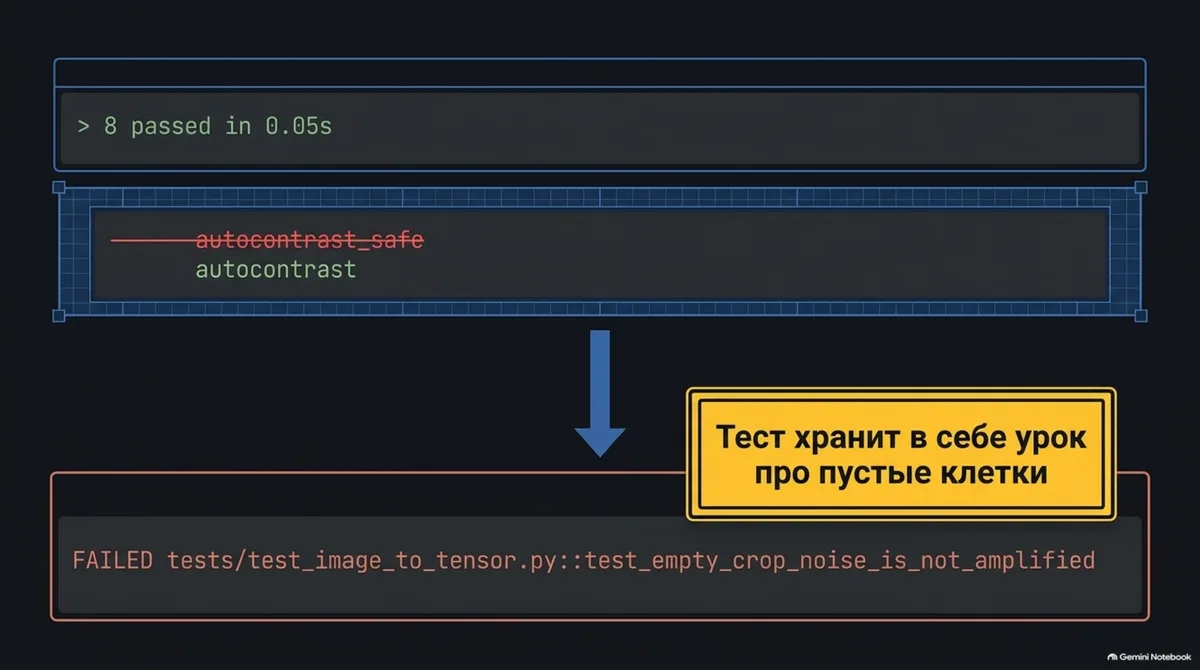
assert t.dtype == torch.float32Обратите внимание на тест test_empty_crop_noise_is_not_amplified: если заменить autocontrast_safe на обычный autocontrast, он падает. Тест хранит в себе урок про пустые клетки. Соседние тесты на паддинг проверяют не «красоту», а контракт: у узкой картинки правее столбца 40 все значения ровно 0; у широкой низкой — верхние и нижние полосы нулевые. Так letterbox и инверсия зафиксированы числами, а не скриншотом.
Сетка и тесты
Демо-кропы и CLI на 7,3 / 7 уже прогоняли выше. Дальше по порядку: скрипт сетки → картинка → pytest.
experiments/show_preprocess_grid.py
"""Сетка «исходник | холст до инверсии | тензор» для всех кропов в папке."""
import argparse
import sys
from pathlib import Path
import matplotlib
import numpy as np
matplotlib.use("Agg")
import matplotlib.pyplot as plt # noqa: E402
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from image_to_tensor import ( # noqa: E402
autocontrast_safe, letterbox, load_image, preprocess_array, to_gray_on_white,
)
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--dir", default="data/synthetic/raw")
ap.add_argument("--out", default="experiments/preprocess_grid.png")
args = ap.parse_args()
paths = sorted(Path(args.dir).glob("*.png"))
if not paths:
sys.exit(f"В {args.dir} нет PNG. Сначала: python src/make_demo_crops.py")
fig, axes = plt.subplots(len(paths), 3, figsize=(10, 1.25 * len(paths) + 0.6))
for row, path in enumerate(paths):
raw = load_image(path)
gray = to_gray_on_white(raw)
canvas = letterbox(autocontrast_safe(gray))
tensor = preprocess_array(path)[0]
axes[row, 0].imshow(np.asarray(gray), cmap="gray", vmin=0, vmax=255)
axes[row, 1].imshow(np.asarray(canvas), cmap="gray", vmin=0, vmax=255)
axes[row, 2].imshow(tensor, cmap="gray", vmin=0, vmax=1)
axes[row, 0].set_ylabel(path.stem.replace("sample_", ""), rotation=0,
ha="right", va="center", fontsize=8)
for ax in axes[row]:
ax.set_xticks([])
ax.set_yticks([])
for col, title in enumerate(["исходник", "холст 48×160 (до инверсии)", "тензор (штрих = светлый)"]):
axes[0, col].set_title(title, fontsize=9)
out = Path(args.out)
out.parent.mkdir(parents=True, exist_ok=True)
fig.tight_layout()
fig.savefig(out, dpi=110)
print(f"сохранено: {out}")
if __name__ == "__main__":
main()Скрипт для каждой PNG в папке рисует три колонки: серый исходник, холст 48×160 до инверсии и итоговый тензор. Наберите файл в experiments/, затем запустите по порядку:
python experiments/show_preprocess_grid.py --out experiments/preprocess_grid.png
python -m pytest tests/test_image_to_tensor.py -q
Ожидаемый вывод на теге lesson-02:
сохранено: experiments/preprocess_grid.png
........                                                                 [100%]
8 passed in 1.48s
Если torch не установлен, тест обёртки будет skipped — для ядра на NumPy это нормально; к окружению вернитесь в уроке 1.
Ожидаемое
Сетка, которую вы получите в experiments/preprocess_grid.png:
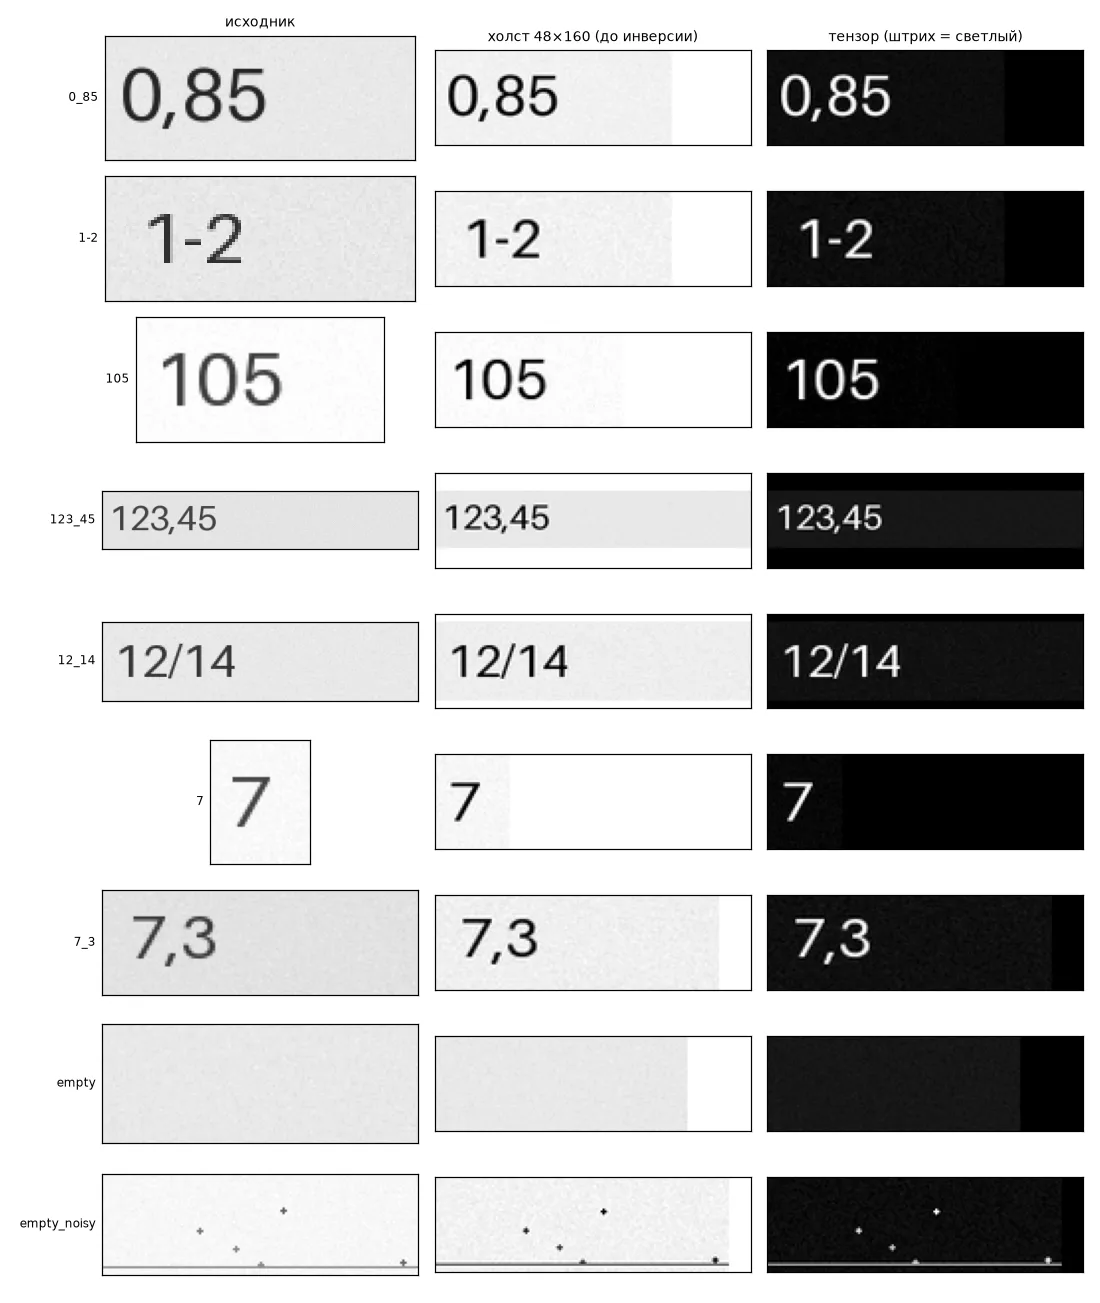
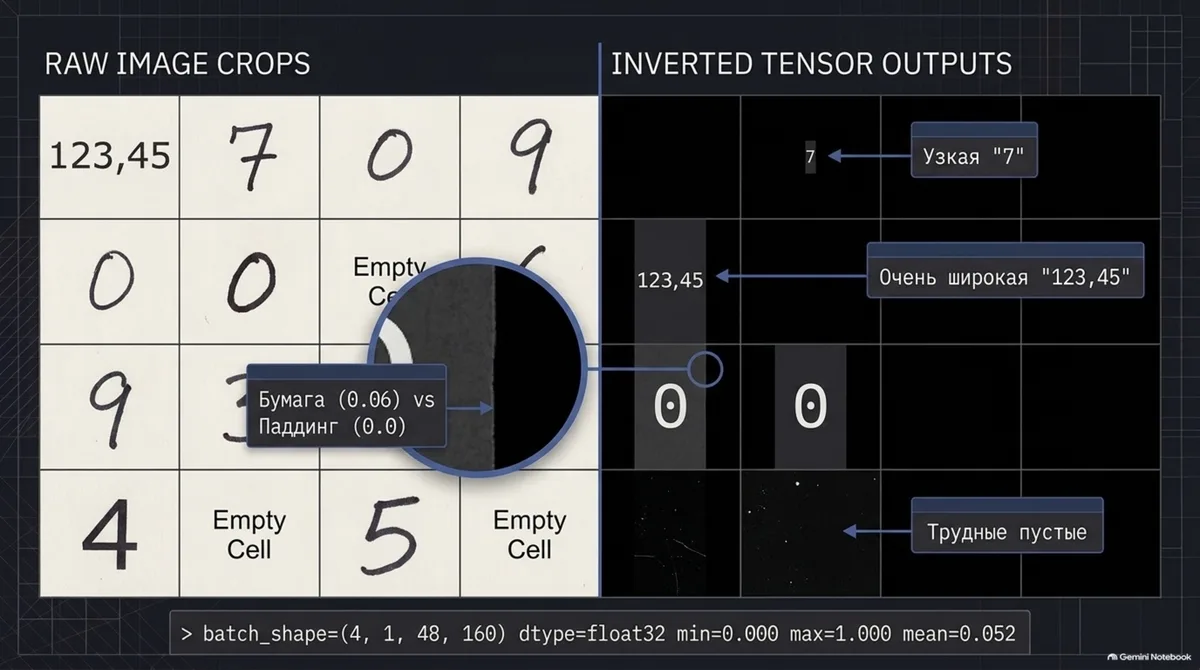
Что на ней стоит заметить:
- Узкая «7» прижата к левому краю, весь остальной холст — чёрный паддинг. Модель будет видеть такие кропы постоянно.
- Очень широкая строка
123,45после вписывания стала маленькой. Это цена letterbox: широкие строки теряют разрешение. Холст 48×160 хорошо подходит для типичных значений, но не для всего. - Бумага и паддинг разные. Фон кропа в тензоре тёмно-серый (около 0.06), а паддинг — ровно 0. Это видно по границе справа: бумага чуть светлее пустого места. Почему бумага не ноль? В исходнике фон не идеальные 255: генератор кладёт шум примерно в диапазоне 225–255. После деления на 255 и инверсии получается небольшой «хвост» около 0.06. Паддинг мы сами залили ровно 255 → после инверсии ровно 0. На сетке эта граница — не баг, а след двух разных источников «белого».
- Две пустые клетки не одинаковы. Первая ровная, во второй линия и пятнышки. Такие «трудные пустые» клетки и будет учиться распознавать детектор. Колонка «холст» на сетке ещё до инверсии: бумага светлая, паддинг белый. Колонка «тензор» уже после: штрих светлый, пустота тёмная — так модель и увидит вход.
Сравните с вашими предсказаниями. Особенно с ответом на третий вопрос: если вы ждали, что пустая клетка останется пустой, то теперь видите, почему защита в autocontrast_safe нужна. Без неё на том же empty получается max ≈ 0.98 и mean ≈ 0.40 — шум бумаги выглядит как текст.
Упражнение (эксперимент)
- Подайте на вход очень широкую и очень узкую строки (в папке уже есть
123_45и7) и посмотрите, что делает letterbox. Затем смените холст на 32×128 (константыCANVAS_H,CANVAS_W) и сравните сетки. Что стало с широкой строкой? - В
preprocess_arrayзаменитеautocontrast_safeнаImageOps.autocontrastи пересоздайте сетку. Как изменились пустые клетки? Какой тест упал? - Поставьте
MIN_CONTRAST_RANGE = 80и посмотрите на самые тусклые кропы. Что произойдёт с кропом, в котором чернила бледные?
Если не так
FileNotFoundErrorили «В папке нет PNG». Сначала запуститеpython src/make_demo_crops.py --out data/synthetic/raw, потом остальные команды. Все команды выполняются из корня репозитория.ModuleNotFoundError: image_to_tensorв тестах. Запускайте тесты из корня репозитория:python -m pytest tests/test_image_to_tensor.py -q.- Текст на демо-кропах очень мелкий. В Pillow старше 10.1 нельзя задать размер встроенного шрифта, и скрипт откатывается к маленькому. Обновите Pillow:
pip install -U "Pillow>=10.1". ModuleNotFoundError: matplotlib. Окружение из урока 1 не активировано или зависимости не установлены:pip install -r requirements.txt.- Тест
test_tensor_wrapperпропущен (skipped). Не установленtorch. Это нормально для ядра на NumPy, но вернитесь к уроку 1. - На своей картинке всё чёрное. Наш контракт ожидает тёмные чернила на светлой бумаге. Если у вас светлый текст на тёмном фоне, сначала инвертируйте исходник.
Чеклист готовности
- Файлы урока в вашем репозитории, демо-кропы сгенерированы, изменения закоммичены
- CLI печатает
shape=(1, 48, 160) dtype=float32 - Сетка сохранена и разобрана по четырём наблюдениям
-
python -m pytest tests/test_image_to_tensor.py -q→8 passed - Сверены три прогноза из «Предскажи»
Ещё нет
- Алфавита и меток (урок 3) и Dataset с аугментациями (уроки 4–6). Сегодня только картинка → числа одного формата.
- Цены порога
MIN_CONTRAST_RANGE. Защита сработает и на очень бледном, но настоящем тексте: если размах яркости меньше 30 уровней, контраст не растянется, и бледные чернила останутся тусклыми. Для нашей синтетики это нормально. На реальных сканах порог придётся подбирать — этим займёмся в приложении про реальные данные. - Скрипта сетки как «ядра».
experiments/show_preprocess_grid.py— удобная картинка для глаз. Логика контракта — только вimage_to_tensor.py. - EXIF-ориентации. У фотографий из телефона может быть записан поворот; для синтетических PNG он не нужен.
FAQ
Почему холст именно 48×160, а не квадрат?
Кропы клеток бланка обычно шире, чем выше: цифры идут в строку. Квадрат либо обрежет текст, либо оставит слишком много пустого места по бокам. 48×160 — компромисс для типичных значений курса; очень широкие строки всё равно мельчают — это видно на сетке.
Зачем инверсия, если можно оставить бумагу белой?
После letterbox паддинг белый (255). Инверсия делает его ровно 0, а штрих — около 1. Тогда «пустое место холста» и «фон без чернил» согласованы: модель не путает паддинг с белой бумагой как с сильным сигналом.
Можно ли растянуть кроп до 48×160 без letterbox?
Можно, но пропорции сломаются: широкая «123,45» станет приплюснутой. Letterbox сохраняет форму цифр ценой потери разрешения на очень широких строках. Для OCR это обычно меньшее зло, чем искажённый шрифт.
Почему тесты на NumPy, а не сразу на torch.Tensor?
Ядро препроцессинга не зависит от PyTorch: его проще отлаживать и гонять в CI. Обёртка image_to_tensor тонкая; тест обёртки пропускается только если torch не установлен.
Что будет, если убрать autocontrast_safe?
Пустая клетка с шумом бумаги превратится в «текст»: max около 0.98. Детектор пустых/заполненных клеток потом получит ложный сигнал. Тест test_empty_crop_noise_is_not_amplified как раз ловит эту поломку.
Нужно ли коммитить data/synthetic/raw?
Нет. Кропы пересоздаются скриптом с --seed 42. В репозитории папка в .gitignore; для статьи и урока достаточно команды генерации.
Что дальше
Следующий урок — Урок 3. Алфавит, лейблы, формат. Dataset с аугментациями — уроки 4–6.
Эталон для сверки: lesson-02. Клонировать его не нужно. Предыдущий: Урок 1. Лаборатория.
Комментарии