Зміст
Кур’єр несе посилку в двох коробках різного розміру. На складі все вміщується, на порозі клієнта — ні: довелося зім’яти краї. З нейромережею та сама пастка: на навчанні картинку «підігнали» одним способом, у проді — трохи інакше, і модель тихо втрачає якість, хоча ваги ті самі. Цей урок не вчить читати цифри. Він домовляється про одну коробку для всіх моделей курсу.
У уроці 1 ми зібрали лабораторію і зафіксували зерно. Сьогодні — наступний шар серії «Навчаємо CNN і CRNN з нуля»: картинка → тензор.
Нейромережа не бачить картинку як око. PNG на диску — стиснутий файл із пікселями; для мережі це занадто «людський» формат. На вході їй потрібна таблиця чисел: кожен піксель — одне число яскравості. Таку таблицю в коді називають масивом (у NumPy — ndarray, у PyTorch — tensor; для цього уроку слова «масив» і «тензор» майже синоніми: таблиця чисел із відомою формою).
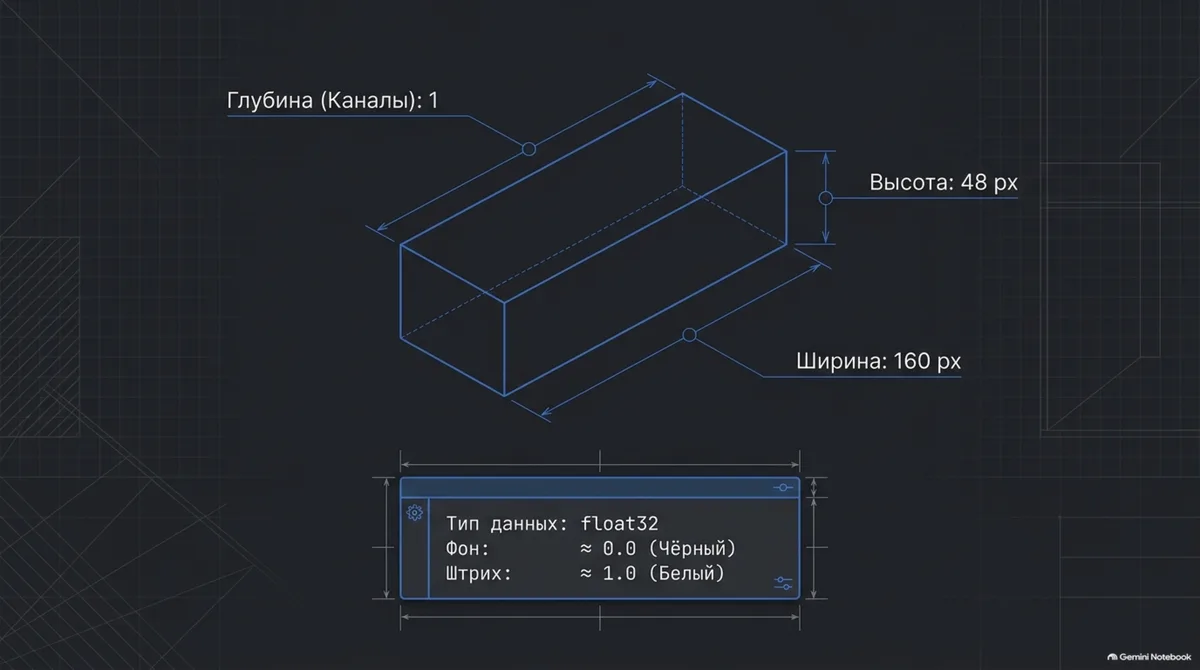
Завдання уроку — домовитися про один формат цієї таблиці для всіх моделей курсу. Кожна вирізка клітинки перетворюється на масив форми [1, 48, 160]: не «список із трьох чисел», а тривимірна таблиця розміром 1 × 48 × 160 — усього 1 × 48 × 160 = 7680 чисел, по одному на кожен «піксель» входу.
Тип float32 — як ці числа зберігаються в пам’яті. Це число з плаваючою комою (дроби) у 32 бітах: можна записати не лише 0 і 1, а й 0.06, 0.77, 0.98. Цілі байти картинки (0…255, тип на кшталт uint8) для навчання незручні: мережі рахують градієнти і ваги в дробах. Тому після підготовки ми ділимо яскравість на 255 і отримуємо значення приблизно в відрізку [0, 1] саме як float32. У контракті курсу: фон (папір і падінг) близько 0, штрих (чорнило) ближче до 1.
Форма [1, 48, 160] читається як канал × висота × ширина — так картинки зазвичай лежать у PyTorch. Одиниця попереду: один канал яскравості (сірий), не RGB. Далі 48 рядків і 160 стовпців. У Pillow частіше думають «ширина × висота» або «висота × ширина × канали»; тут порядок інший. Якщо переплутати осі, мережа побачить «перевернуту» геометрію, а тести на форму (1, 48, 160) одразу покажуть помилку.
Навіщо домовлятися заздалегідь? І CNN з уроку 7, і CRNN з уроку 11 отримуватимуть на вхід одне й те саме. Якщо препроцесинг на навчанні і в проді відрізняється хоча б у дрібниці, модель тихо втрачає якість, і знайти причину потім дуже важко. Тому вся підготовка картинки живе в одному файлі.
Слово контракт тут буквальне: це не «гарний препроцесинг», а обіцянка решті курсу. Будь-яка майбутня модель має право розраховувати, що на вході вже лежить [1, 48, 160], float32, фон близько нуля, штрих близько одиниці. Порушили обіцянку в одному місці — зламалося і навчання, і прод, і порівняння експериментів.
Чотири кроки: сірий → контраст → letterbox → інверсія
До першої моделі (детектор з’явиться лише в уроках 7–9) картинка проходить чотири обов’язкові перетворення. Разом вони й є контракт. Код нижче повторює їх по порядку; тут — зміст кожного слова з заголовка уроку.
1. Сірий. Колір клітинці бланка не потрібен: цифра читається за яскравістю штриха на папері. Три канали RGB роздувають вхід утричі і вчать мережу зайвим відтінкам сканера. Ми лишаємо один канал яскравості (L у Pillow): кожне число — «наскільки світлий піксель», від 0 (чорний) до 255 (білий). Окремо лагодимо прозорі PNG: «порожній» піксель часто зберігає чорний колір із нульовою непрозорістю — без білої підкладки сірий фон перетвориться на пляму чорнила.
2. Контраст. Скани і синтетика бувають тусклими: чорнило сіре, папір теж сірий, різниця маленька. Розтягування контрасту розсуває цей коридор до країв 0…255, щоб тускла вирізка не відрізнялася від яскравої. Але на порожній клітинці розсувати нічого — там лише шум паперу. Звичайний autocontrast зробить із шуму «текст»; тому у нас autocontrast_safe із порогом: майже однорідну вирізку не чіпаємо.
3. Letterbox. Вирізки приходять різними: вузька «7», широка «123,45». Мережі потрібен один розмір — полотно 48×160. Слово letterbox — як чорні смуги у фільму на широкому екрані: картинку вписують цілком, пропорції не ламають, порожнє місце заливають фоном. Альтернатива — розтягнути до 48×160 — сплющить цифри. Ми масштабуємо з scale = min(…), притискаємо текст ліворуч, по вертикалі центруємо.
4. Інверсія. Поки полотно схоже на папір: білий фон, темне чорнило. Після ділення на 255 папір стає близько 1, а штрих — близько 0. Чорнило, яке модель має помічати, опиняється маленькими числами, а білий падінг — великими. Інверсія 1 − значення перевертає шкалу: штрих ≈ 1, фон і падінг ≈ 0. Порожнє місце полотна і ділянка без чорнила дають моделі одне й те саме значення — нуль.
Після цих чотирьох кроків на виході лежить тензор форми [1, 48, 160] типу float32 — той самий вхід, який обіцяє контракт курсу. Усі наступні моделі прийматимуть саме його.
Файли уроку
src/image_to_tensor.py— препроцесинг: сірий → контраст → вписати в полотно 48×160 → інверсія.src/make_demo_crops.py— допоміжний скрипт: малює 9 демо-вирізок різних розмірів (цифри і порожні клітинки). Повноцінний генератор буде в уроці 4.experiments/show_preprocess_grid.py— допоміжний скрипт: сітка «вихідник | полотно | тензор».tests/test_image_to_tensor.py— тести контракту.
Еталон для звірки, якщо щось не працює: lesson-02. Клонувати його не потрібно: файли уроку ви дописуєте у свій репозиторій з уроку 1 і комітите.
Передбачте
Розділ «Передбачте» — не оцінка. Перед запуском ви фіксуєте очікування: форму тензора, значення падінгу після інверсії, долю порожньої клітинки при розтягуванні контрасту. Після команд порівнюєте прогноз із терміналом і сіткою. Розбіжність тут цінніша за збіг: так видно, де інтуїція про картинки помилялася.
Перед запуском запишіть відповіді:
- Які форма і тип будуть у результату?
- Після інверсії падінг (порожнє місце, яким ми добиваємо картинку до 48×160) буде дорівнювати 0 чи 1?
- Що станеться з порожньою клітинкою, якщо «розтягнути» її контраст до діапазону 0–255?
Встановлення і демо-вирізки
Оточення і репозиторій — з уроку 1. Спочатку наберіть у репозиторії файл src/make_demo_crops.py — короткий скрипт, який малює дев’ять демо-вирізок різних розмірів. Це не ядро препроцесингу, а матеріал для перевірки letterbox і захисту контрасту. Повний генератор даних з’явиться в уроці 4.
src/make_demo_crops.py
"""Несколько искусственных кропов для уроков 2–3 (полный генератор будет в уроке 4)."""
import argparse
from pathlib import Path
import numpy as np
from PIL import Image, ImageDraw, ImageFont
# (текст, часть имени файла, ширина, высота)
SAMPLES = [
("7,3", "7_3", 120, 40),
("12/14", "12_14", 200, 50),
("0,85", "0_85", 150, 60),
("105", "105", 90, 45),
("1-2", "1-2", 100, 40),
("123,45", "123_45", 380, 70), # очень широкий
("7", "7", 40, 50), # очень узкий
("", "empty", 120, 45), # пустая клетка
("", "empty_noisy", 140, 45), # пустая клетка с мусором
]
def get_font(size: int):
try:
return ImageFont.load_default(size=size)
except Exception: # старый Pillow или нет FreeType
return ImageFont.load_default()
def draw_crop(text: str, w: int, h: int, rng: np.random.Generator, noisy: bool) -> Image.Image:
paper = rng.integers(225, 256)
arr = rng.normal(paper, 3.0, size=(h, w)).clip(0, 255).astype(np.uint8)
img = Image.fromarray(arr, mode="L")
draw = ImageDraw.Draw(img)
if text:
pad = int(rng.integers(6, 13))
size = int(h * 0.6)
font = get_font(size)
bbox = draw.textbbox((0, 0), text, font=font)
while bbox[2] - bbox[0] > w - 2 * pad and size > 8:
size -= 2
font = get_font(size)
bbox = draw.textbbox((0, 0), text, font=font)
ink = int(rng.integers(20, 70))
x = pad - bbox[0]
y = (h - (bbox[3] - bbox[1])) // 2 - bbox[1]
draw.text((x, y), text, fill=ink, font=font)
if noisy:
draw.line([(0, h - 4), (w, h - 4)], fill=150, width=1) # край клетки
for _ in range(6): # пятнышки
cx, cy = int(rng.integers(0, w)), int(rng.integers(0, h))
draw.ellipse([cx, cy, cx + 2, cy + 2], fill=int(rng.integers(90, 160)))
return img
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--out", default="data/synthetic/raw")
ap.add_argument("--seed", type=int, default=42)
args = ap.parse_args()
out = Path(args.out)
out.mkdir(parents=True, exist_ok=True)
rng = np.random.default_rng(args.seed)
for text, name, w, h in SAMPLES:
img = draw_crop(text, w, h, rng, noisy=name.endswith("noisy"))
path = out / f"sample_{name}.png"
img.save(path)
print(f"{path} ({w}x{h}) text={text!r}")
if __name__ == "__main__":
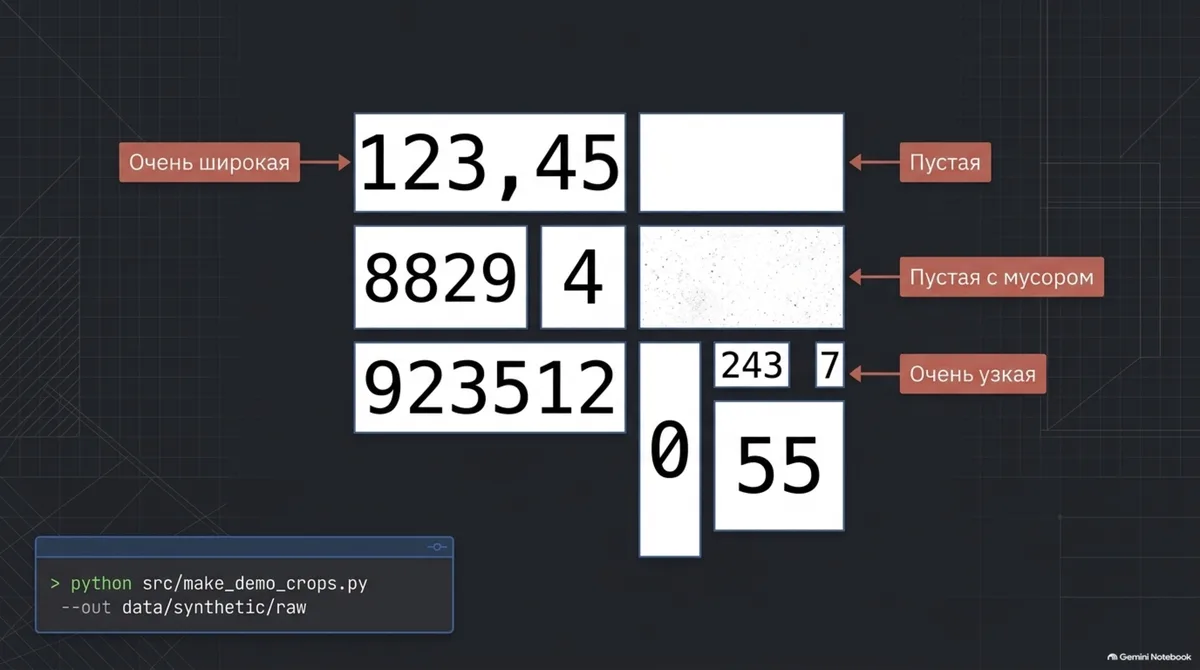
main()Список SAMPLES задає текст і розмір кожної вирізки: широкий рядок, вузька сімка, дві порожні клітинки. draw_crop малює шум паперу і, якщо потрібно, цифри або сміття на порожній клітинці. Зерно за замовчуванням --seed 42, щоб у всіх вийшли ті самі файли.
Потім згенеруйте демо-вирізки з кореня репозиторію:
python src/make_demo_crops.py --out data/synthetic/rawПриклад виводу на тегу lesson-02:
data/synthetic/raw/sample_7_3.png  (120x40)  text='7,3'
data/synthetic/raw/sample_12_14.png  (200x50)  text='12/14'
data/synthetic/raw/sample_0_85.png  (150x60)  text='0,85'
data/synthetic/raw/sample_105.png  (90x45)  text='105'
data/synthetic/raw/sample_1-2.png  (100x40)  text='1-2'
data/synthetic/raw/sample_123_45.png  (380x70)  text='123,45'
data/synthetic/raw/sample_7.png  (40x50)  text='7'
data/synthetic/raw/sample_empty.png  (120x45)  text=''
data/synthetic/raw/sample_empty_noisy.png  (140x45)  text=''
У теці з’являться дев’ять PNG різної ширини і висоти: 7,3, 12/14, 0,85, 105, 1-2, дуже широкий рядок 123,45, дуже вузька 7 і дві порожні клітинки (одна зі сміттям). Розміри різні навмисно: саме з цим і доведеться впоратися препроцесингу.
Код: набираємо руками
make_demo_crops.py уже вище. Далі набираєте ядро image_to_tensor.py і тести; скрипт сітки — у наступному розділі. Якщо вивід не сходиться, звіртеся з тегом lesson-02.
src/image_to_tensor.py
"""Картинка → тензор: единый контракт входа для моделей курса (1×48×160).
Ядро написано на NumPy, чтобы его можно было проверять без PyTorch;
в тензор превращает тонкая обёртка image_to_tensor().
"""
import argparse
import numpy as np
from PIL import Image, ImageOps
CANVAS_H = 48
CANVAS_W = 160
PAD_FILL = 255 # фон холста: белая бумага (после инверсии станет 0)
MIN_CONTRAST_RANGE = 30 # если в кропе меньше 30 уровней яркости, контраст не растягиваем
def load_image(source) -> Image.Image:
"""Принимает путь или готовый PIL-образ."""
if isinstance(source, Image.Image):
return source # уже открытый образ (тесты, Dataset)
return Image.open(source) # путь к файлу
def to_gray_on_white(img: Image.Image) -> Image.Image:
"""В оттенки серого; прозрачность подкладывается на белый фон."""
has_alpha = img.mode in ("RGBA", "LA") or (img.mode == "P" and "transparency" in img.info)
if has_alpha:
rgba = img.convert("RGBA")
white = Image.new("RGBA", rgba.size, (255, 255, 255, 255)) # белая подложка
img = Image.alpha_composite(white, rgba) # иначе прозрачность станет чёрной
return img.convert("L") # один канал яркости
def autocontrast_safe(img: Image.Image, min_range: int = MIN_CONTRAST_RANGE) -> Image.Image:
"""Растягивает контраст, но не трогает почти однородные кропы.
Пустая клетка почти однородна. Если растянуть её контраст до 0..255,
шум бумаги превратится в «текст».
"""
lo, hi = img.getextrema() # мин/макс яркости в кропе
if hi - lo < min_range:
return img # почти однородно: не раздуваем шум бумаги
return ImageOps.autocontrast(img) # растягиваем контраст до 0..255
def letterbox(img: Image.Image, h: int = CANVAS_H, w: int = CANVAS_W,
fill: int = PAD_FILL) -> Image.Image:
"""Вписывает картинку в холст h×w без искажения пропорций.
По горизонтали прижимаем влево (текст начинается всегда с одного места),
по вертикали центрируем. Остаток холста заливаем фоном.
"""
w0, h0 = img.size
scale = min(w / w0, h / h0) # вписать целиком, без растяжения
new_w = max(1, round(w0 * scale))
new_h = max(1, round(h0 * scale))
resized = img.resize((new_w, new_h), Image.Resampling.LANCZOS)
canvas = Image.new("L", (w, h), fill) # белый холст 48×160
canvas.paste(resized, (0, (h - new_h) // 2)) # влево + по вертикали центр
return canvas
def preprocess_array(source) -> np.ndarray:
"""Путь или PIL-образ → float32-массив [1, 48, 160]: фон ≈ 0, штрих ≈ 1."""
img = load_image(source)
if min(img.size) == 0:
raise ValueError("пустое изображение (нулевой размер)")
gray = to_gray_on_white(img)
gray = autocontrast_safe(gray)
canvas = letterbox(gray)
arr = np.asarray(canvas, dtype=np.float32) / 255.0 # [0, 1], бумага ≈ 1
return (1.0 - arr)[None, :, :] # инверсия: штрих ≈ 1, паддинг = 0; канал впереди
def image_to_tensor(source):
"""То же, но в виде torch.Tensor."""
import torch # импорт здесь: ядро выше не требует torch
return torch.from_numpy(preprocess_array(source))
def main() -> None:
ap = argparse.ArgumentParser(description="Показать результат препроцессинга одного кропа")
ap.add_argument("--image", required=True)
args = ap.parse_args()
arr = preprocess_array(args.image)
zero_cols = int((arr[0].max(axis=0) == 0).sum()) # столбцы чистого паддинга
print(f"shape={arr.shape} dtype={arr.dtype} "
f"min={arr.min():.3f} max={arr.max():.3f} mean={arr.mean():.3f}")
print(f"полностью нулевых столбцов (паддинг): {zero_cols} из {arr.shape[2]}")
if __name__ == "__main__":
main()Розберемо функції по порядку.
load_image. Приймає шлях або готовий PIL-образ. Так одну й ту саму функцію зручно викликати і з тестів, і з майбутнього Dataset.
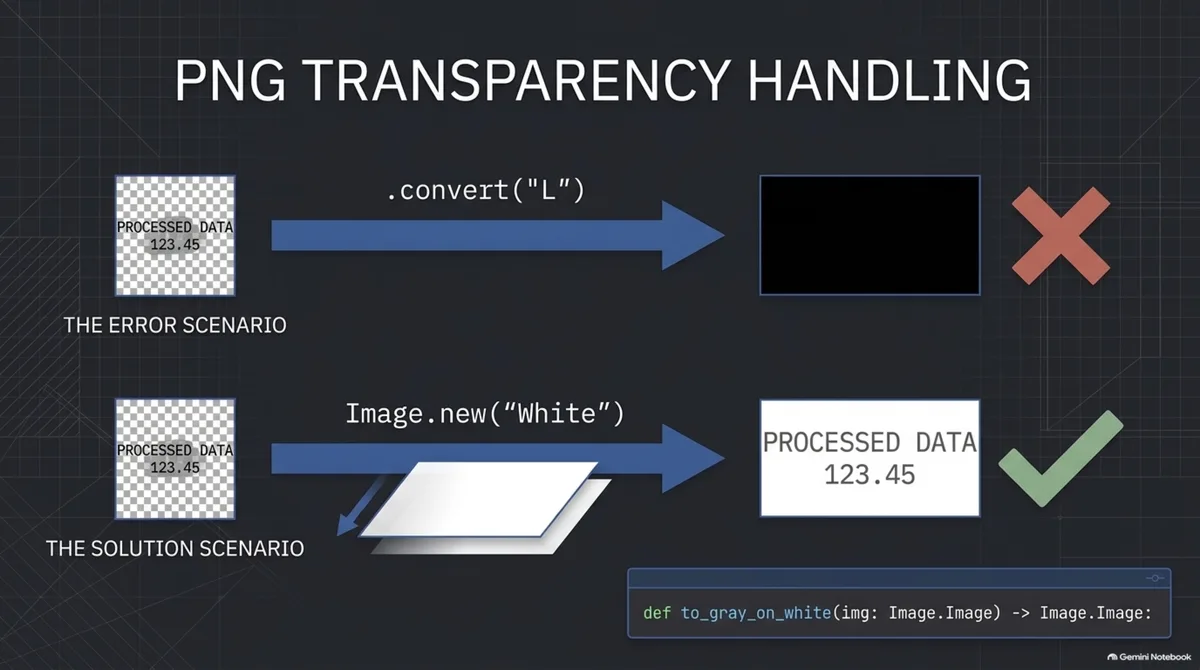
to_gray_on_white. Це крок «сірий» з карти вище. Переводить в один канал яскравості: колір відкидаємо, лишається «світліше / темніше». Є нюанс із прозорістю: у PNG із прозорим фоном «порожні» пікселі зберігають чорний колір із нульовою непрозорістю. Якщо просто викликати convert("L"), прозорий фон стане чорним, а модель вирішить, що вся картинка залита чорнилом. Тому спочатку підкладаємо білу підкладку — як аркуш паперу під плівку з дірками.
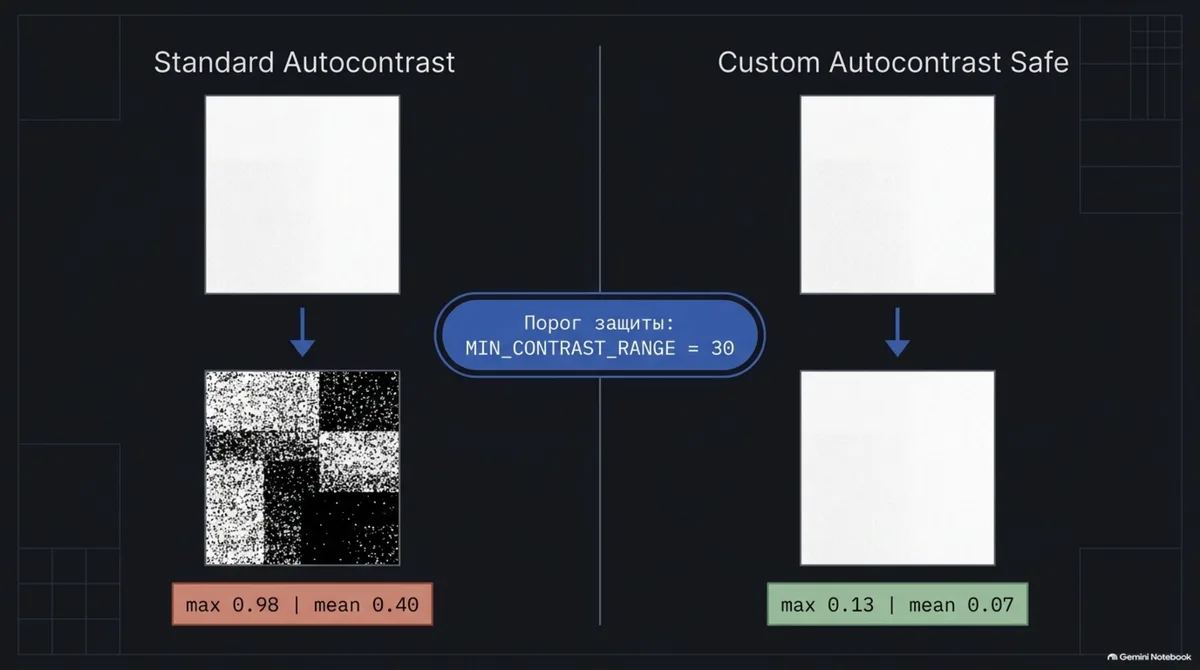
autocontrast_safe. Це крок «контраст». Розтягує яскравості, щоб тусклі вирізки не відрізнялися від яскравих: найтемніший піксель вирізки їде до 0, найсвітліший — до 255, середина розтягується пропорційно. Але у функції є захист, і ось навіщо. Порожня клітинка майже однорідна: у ній лише легкий шум паперу. Звичайний autocontrast чесно розтягне цей шум на весь діапазон 0–255, і клітинка перетвориться на «текст». На нашому демо-вирізці empty без захисту максимум після препроцесингу виходить 0.98 при середньому 0.40, а з захистом — 0.13 при середньому 0.07. Це важливо: через кілька уроків ми вчитимемо детектор відрізняти порожні клітинки від заповнених, і йому не можна підсовувати порожні клітинки, перетворені на шум. Поріг MIN_CONTRAST_RANGE = 30 — наш вибір; докладніше про його ціну в розділі «Ще немає».
На пальцях: нехай яскравості у вирізці лежать у вузькому коридорі, скажімо від 230 до 245 (hi − lo = 15). Звичайний autocontrast розтягне 230 → 0 і 245 → 255: сірий шум паперу стане контрастним «малюнком». Захист дивиться саме на різницю hi − lo: менше 30 — вирізку не чіпаємо. Справжній текст із блідими, але розрізнимими чорнилами зазвичай дає розмах більше порога і проходить розтягування як треба.
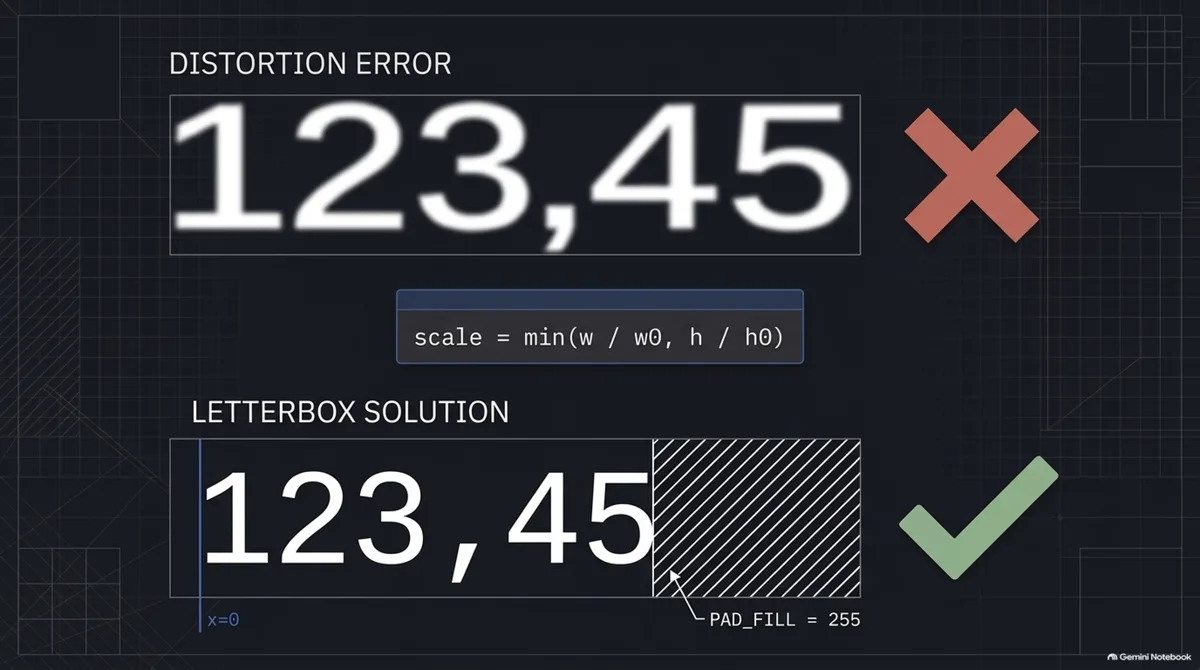
letterbox. Це крок «вписати в полотно». Назва — з відео: картинку кладуть на фіксований кадр так, щоб вона цілком вмістилася, а порожні поля залили фоном. Якщо натомість розтягнути широку вирізку до 48×160, літери стануть приплюснутими, а модель має читати нормальні пропорції. Тому масштабуємо зі збереженням сторін і добиваємо залишок фоном (PAD_FILL = 255, білий «папір»). По горизонталі притискаємо ліворуч (текст завжди починається з одного місця), по вертикалі центруємо.
Числа для демо-вирізки 7,3 розміром 120×40: scale = min(160/120, 48/40) = min(1.333…, 1.2) = 1.2. Нова картинка ≈ 144×48 — по висоті рівно вмістилася, по ширині праворуч лишається смуга в 160 − 144 = 16 стовпців. Саме це друкує CLI: «полностью нулевых столбцов … 16 из 160». Для вузької 7 (40×50) обмежує ширину полотна слабше за висоту: картинка виростає по вертикалі до 48, по горизонталі лишається вузькою — і падінг праворуч займає більшу частину кадру (122 з 160). Притиск ліворуч важливий заздалегідь: і детектор, і читач рядка чекатимуть, що символи починаються з одного й того самого краю, а не «плавають» по центру.
preprocess_array. Збирає всі чотири кроки поспіль і наприкінці робить інверсію: 1 - arr. Це не окрема «п’ята магія», а переклад полотна мовою контракту: фон близько 0, штрих близько 1. Навіщо саме так? Падінг ми заливаємо білим (255), після інверсії він рівно 0: «порожнє місце полотна» і «немає чорнила» збігаються, і падінг не створює хибних штрихів. Якби ми не інвертували, нулями довелося б добивати темні «штрихи» — а тоді і папір, і падінг жили б у різних шкалах.
Три останні операції в числах. asarray(...)/255.0 переводить байти 0…255 у частки 0…1 (білий папір ≈ 1, темний штрих ≈ 0). 1.0 - arr перевертає шкалу: папір → близько 0, штрих → близько 1. [None, :, :] додає вісь каналу попереду: з матриці (48, 160) виходить (1, 48, 160). Без цієї осі пізніше не можна скласти кілька вирізок в один батч однієї й тієї форми.
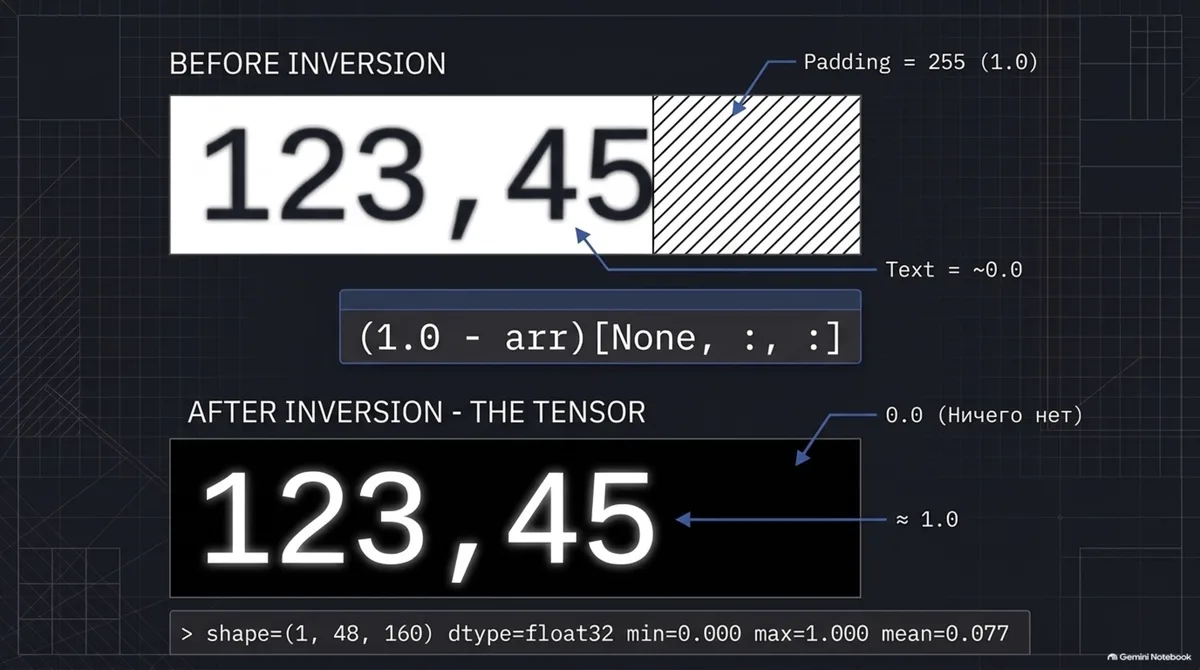
image_to_tensor. Тонка обгортка: torch.from_numpy(...). Імпорт torch стоїть усередині функції навмисно: усе інше рахується на NumPy, тому ядро можна перевіряти і без PyTorch.
Запуск на широкій і вузькій вирізці:
python src/image_to_tensor.py --image data/synthetic/raw/sample_7_3.png
python src/image_to_tensor.py --image data/synthetic/raw/sample_7.png
Приклад виводу на тегу lesson-02 (у третьому знаку значення можуть трохи плавати від версії Pillow):
shape=(1, 48, 160) dtype=float32 min=0.000 max=1.000 mean=0.077
полностью нулевых столбцов (паддинг): 16 из 160

shape=(1, 48, 160) dtype=float32 min=0.000 max=1.000 mean=0.017
полностью нулевых столбцов (паддинг): 122 из 160
Форма і тип — відповідь на перше питання «Передбачте». У вузької «7» падінг займає більшу частину полотна (122 з 160 стовпців рівно нульові) — відповідь на друге питання: після інверсії падінг дорівнює 0.
Як читати рядок CLI. shape і dtype — сам контракт. min / max показують, що значення вмістилися в відрізок [0, 1]. mean — частка «світлих» (штрихових) пікселів по всьому полотну: у вузької «7» середнє менше, бо майже весь кадр — нульовий падінг. «Полностью нулевых столбцов» рахує стовпці, де максимум по висоті дорівнює 0: праворуч чистий падінг без жодного штриха. Це не «скільки пікселів нульових», а саме цілі порожні колонки — зручний індикатор letterbox.
tests/test_image_to_tensor.py
import sys
from pathlib import Path
import numpy as np
import pytest
from PIL import Image
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from image_to_tensor import CANVAS_H, CANVAS_W, preprocess_array # noqa: E402
def text_like(w: int, h: int, bg: int = 240, ink: int = 30) -> Image.Image:
"""Светлый фон и тёмный «штрих» посередине."""
img = Image.new("L", (w, h), bg)
img.paste(ink, (w // 4, h // 4, w // 2, 3 * h // 4))
return img
def test_shape_dtype_range():
arr = preprocess_array(text_like(200, 50))
assert arr.shape == (1, CANVAS_H, CANVAS_W)
assert arr.dtype == np.float32
assert arr.min() >= 0.0 and arr.max() <= 1.0
def test_ink_is_bright():
arr = preprocess_array(text_like(200, 50))
assert arr.max() > 0.9
def test_horizontal_padding_is_zero_for_narrow_image():
arr = preprocess_array(text_like(40, 50)) # после масштаба ширина ≈ 38
assert np.all(arr[0, :, 40:] == 0.0)
def test_vertical_padding_is_zero_for_wide_image():
arr = preprocess_array(text_like(400, 30)) # после масштаба высота ≈ 12
assert np.all(arr[0, :10, :] == 0.0)
assert np.all(arr[0, -10:, :] == 0.0)
def test_empty_crop_noise_is_not_amplified():
rng = np.random.default_rng(0)
noise = rng.normal(240, 3, size=(45, 120)).clip(0, 255).astype(np.uint8)
arr = preprocess_array(Image.fromarray(noise, mode="L"))
assert arr.max() < 0.2
def test_transparent_background_becomes_white():
img = Image.new("RGBA", (100, 40), (0, 0, 0, 0)) # полностью прозрачная картинка
arr = preprocess_array(img)
assert arr.max() < 0.01
def test_zero_size_image_raises():
with pytest.raises(ValueError):
preprocess_array(Image.new("L", (0, 10)))
def test_tensor_wrapper():
torch = pytest.importorskip("torch")
from image_to_tensor import image_to_tensor
t = image_to_tensor(text_like(200, 50))
assert tuple(t.shape) == (1, CANVAS_H, CANVAS_W)
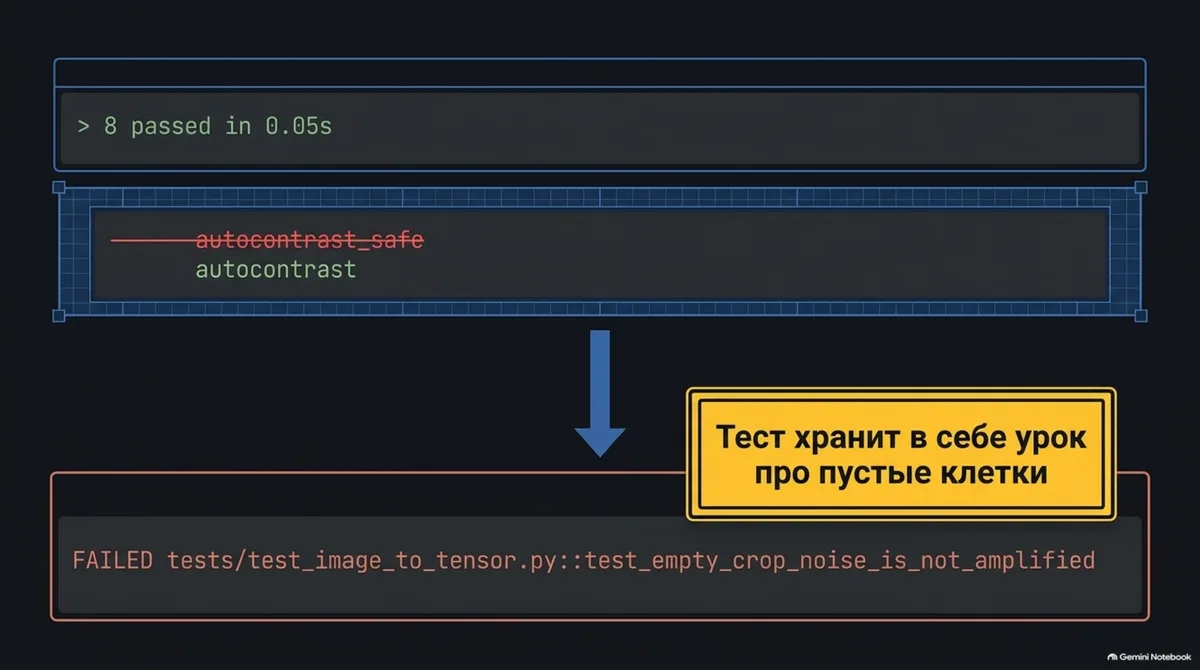
assert t.dtype == torch.float32Зверніть увагу на тест test_empty_crop_noise_is_not_amplified: якщо замінити autocontrast_safe на звичайний autocontrast, він падає. Тест зберігає в собі урок про порожні клітинки. Сусідні тести на падінг перевіряють не «красу», а контракт: у вузької картинки праворуч від стовпця 40 усі значення рівно 0; у широкої низької — верхні і нижні смуги нульові. Так letterbox і інверсія зафіксовані числами, а не скріншотом.
Сітка і тести
Демо-вирізки і CLI на 7,3 / 7 уже проганяли вище. Далі по порядку: скрипт сітки → картинка → pytest.
experiments/show_preprocess_grid.py
"""Сетка «исходник | холст до инверсии | тензор» для всех кропов в папке."""
import argparse
import sys
from pathlib import Path
import matplotlib
import numpy as np
matplotlib.use("Agg")
import matplotlib.pyplot as plt # noqa: E402
sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "src"))
from image_to_tensor import ( # noqa: E402
autocontrast_safe, letterbox, load_image, preprocess_array, to_gray_on_white,
)
def main() -> None:
ap = argparse.ArgumentParser()
ap.add_argument("--dir", default="data/synthetic/raw")
ap.add_argument("--out", default="experiments/preprocess_grid.png")
args = ap.parse_args()
paths = sorted(Path(args.dir).glob("*.png"))
if not paths:
sys.exit(f"В {args.dir} нет PNG. Сначала: python src/make_demo_crops.py")
fig, axes = plt.subplots(len(paths), 3, figsize=(10, 1.25 * len(paths) + 0.6))
for row, path in enumerate(paths):
raw = load_image(path)
gray = to_gray_on_white(raw)
canvas = letterbox(autocontrast_safe(gray))
tensor = preprocess_array(path)[0]
axes[row, 0].imshow(np.asarray(gray), cmap="gray", vmin=0, vmax=255)
axes[row, 1].imshow(np.asarray(canvas), cmap="gray", vmin=0, vmax=255)
axes[row, 2].imshow(tensor, cmap="gray", vmin=0, vmax=1)
axes[row, 0].set_ylabel(path.stem.replace("sample_", ""), rotation=0,
ha="right", va="center", fontsize=8)
for ax in axes[row]:
ax.set_xticks([])
ax.set_yticks([])
for col, title in enumerate(["исходник", "холст 48×160 (до инверсии)", "тензор (штрих = светлый)"]):
axes[0, col].set_title(title, fontsize=9)
out = Path(args.out)
out.parent.mkdir(parents=True, exist_ok=True)
fig.tight_layout()
fig.savefig(out, dpi=110)
print(f"сохранено: {out}")
if __name__ == "__main__":
main()Скрипт для кожної PNG у теці малює три колонки: сірий вихідник, полотно 48×160 до інверсії і підсумковий тензор. Наберіть файл у experiments/, потім запустіть по порядку:
python experiments/show_preprocess_grid.py --out experiments/preprocess_grid.png
python -m pytest tests/test_image_to_tensor.py -q
Очікуваний вивід на тегу lesson-02:
сохранено: experiments/preprocess_grid.png
........                                                                 [100%]
8 passed in 1.48s
Якщо torch не встановлено, тест обгортки буде skipped — для ядра на NumPy це нормально; до оточення поверніться в уроці 1.
Очікуване
Сітка, яку ви отримаєте в experiments/preprocess_grid.png:
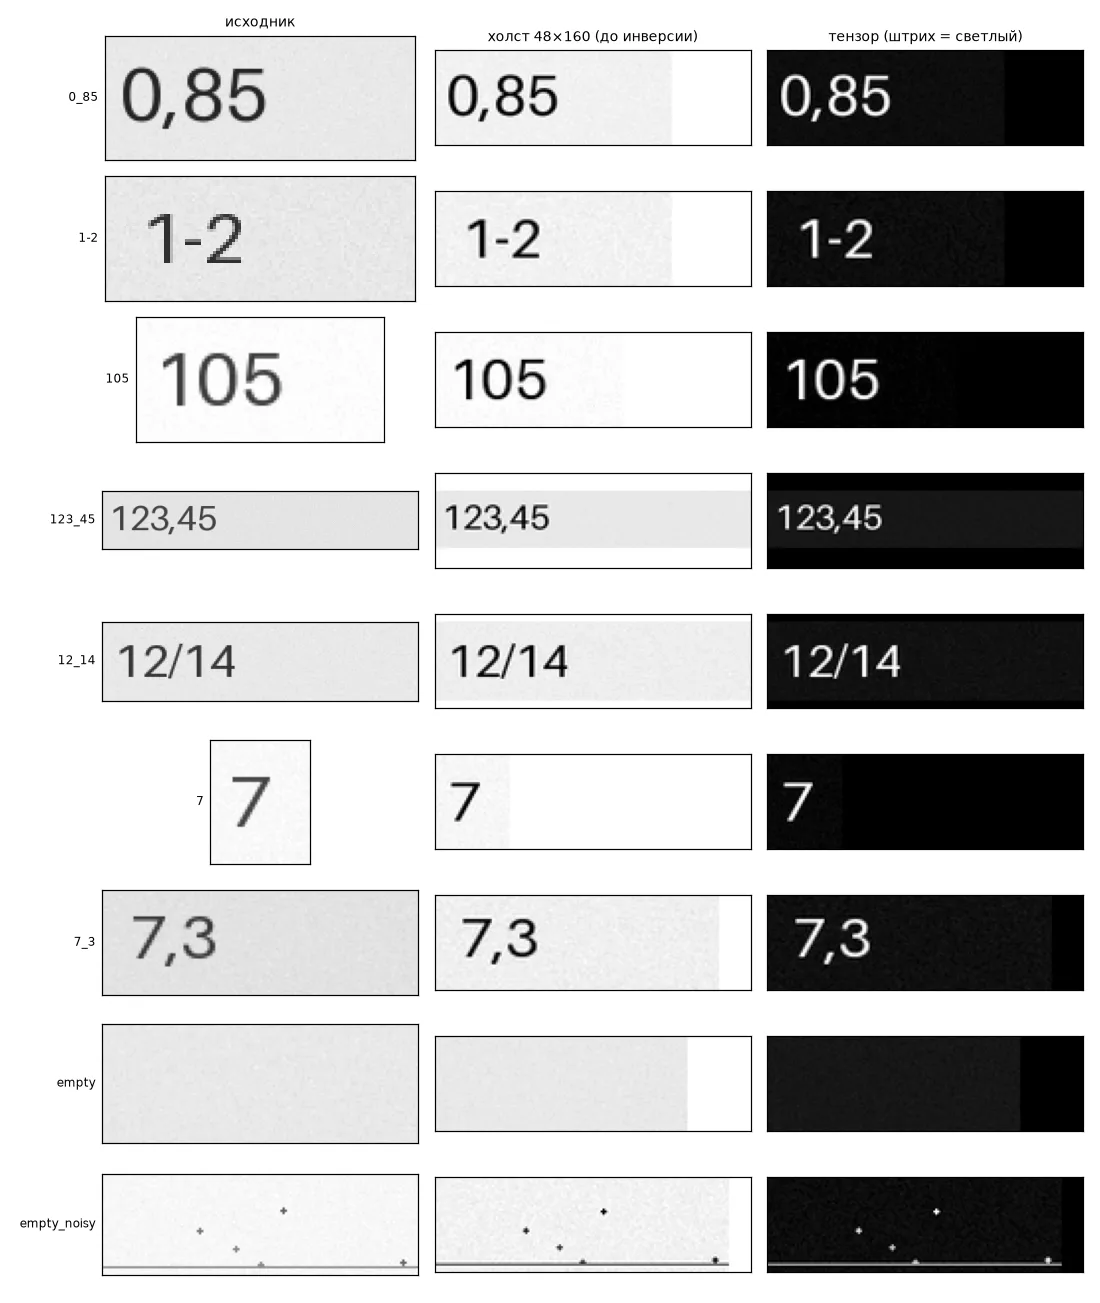
Що на ній варто помітити:
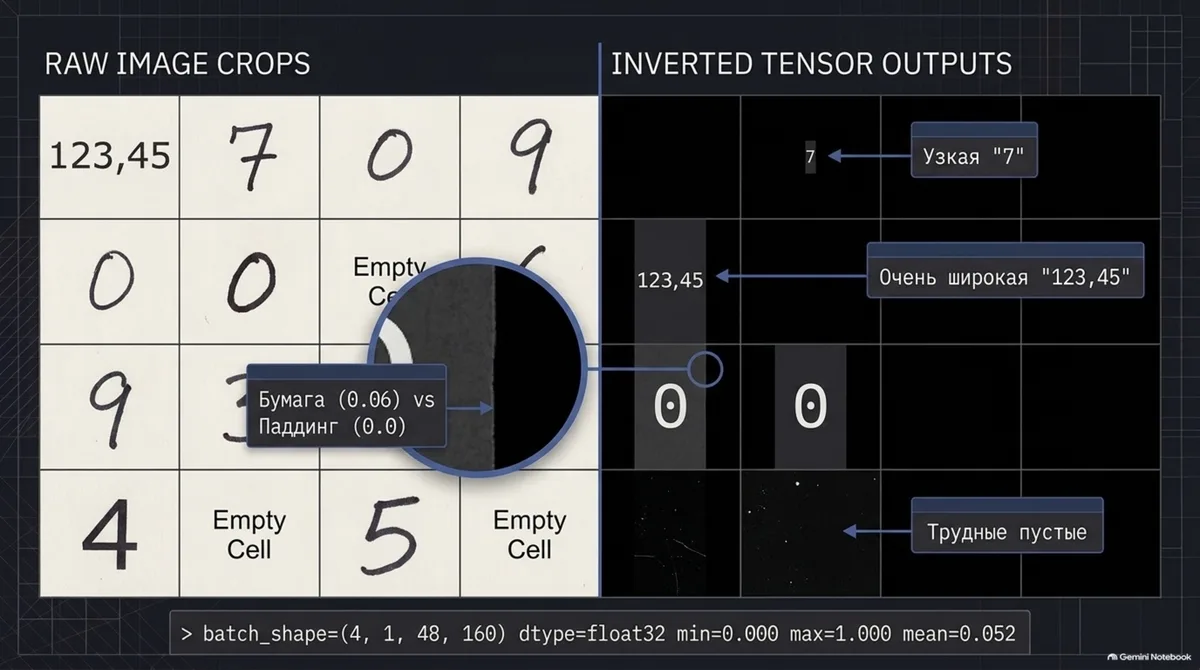
- Вузька «7» притиснута до лівого краю, увесь решта полотна — чорний падінг. Модель бачитиме такі вирізки постійно.
- Дуже широкий рядок
123,45після вписування став маленьким. Це ціна letterbox: широкі рядки втрачають роздільність. Полотно 48×160 добре підходить для типових значень, але не для всього. - Папір і падінг різні. Фон вирізки в тензорі темно-сірий (близько 0.06), а падінг — рівно 0. Це видно по межі праворуч: папір трохи світліший за порожнє місце. Чому папір не нуль? У вихіднику фон не ідеальні 255: генератор кладе шум приблизно в діапазоні 225–255. Після ділення на 255 і інверсії виходить невеликий «хвіст» близько 0.06. Падінг ми самі залили рівно 255 → після інверсії рівно 0. На сітці ця межа — не баг, а слід двох різних джерел «білого».
- Дві порожні клітинки не однакові. Перша рівна, у другій лінія і плямки. Саме такі «важкі порожні» клітинки і вчитиметься розпізнавати детектор. Колонка «полотно» на сітці ще до інверсії: папір світлий, падінг білий. Колонка «тензор» уже після: штрих світлий, порожнеча темна — так модель і побачить вхід.
Порівняйте з вашими прогнозами. Особливо з відповіддю на третє питання: якщо ви чекали, що порожня клітинка лишиться порожньою, то тепер бачите, навіщо потрібен захист у autocontrast_safe. Без нього на тому самому empty виходить max ≈ 0.98 і mean ≈ 0.40 — шум паперу виглядає як текст.
Вправа (експеримент)
- Подайте на вхід дуже широкий і дуже вузький рядки (у теці вже є
123_45і7) і подивіться, що робить letterbox. Потім змініть полотно на 32×128 (константиCANVAS_H,CANVAS_W) і порівняйте сітки. Що сталося з широким рядком? - У
preprocess_arrayзамінітьautocontrast_safeнаImageOps.autocontrastі перестворіть сітку. Як змінилися порожні клітинки? Який тест упав? - Поставте
MIN_CONTRAST_RANGE = 80і подивіться на найтускіліші вирізки. Що станеться з вирізкою, в якій чорнило бліде?
Якщо не так
FileNotFoundErrorабо «В папке нет PNG». Спочатку запустітьpython src/make_demo_crops.py --out data/synthetic/raw, потім решту команд. Усі команди виконуються з кореня репозиторію.ModuleNotFoundError: image_to_tensorу тестах. Запускайте тести з кореня репозиторію:python -m pytest tests/test_image_to_tensor.py -q.- Текст на демо-вирізках дуже дрібний. У Pillow старіше 10.1 не можна задати розмір вбудованого шрифту, і скрипт відкочується до маленького. Оновіть Pillow:
pip install -U "Pillow>=10.1". ModuleNotFoundError: matplotlib. Оточення з уроку 1 не активоване або залежності не встановлені:pip install -r requirements.txt.- Тест
test_tensor_wrapperпропущено (skipped). Не встановленоtorch. Це нормально для ядра на NumPy, але поверніться до уроку 1. - На своїй картинці все чорне. Наш контракт очікує темне чорнило на світлому папері. Якщо у вас світлий текст на темному фоні, спочатку інвертуйте вихідник.
Контрольний список
- Файли уроку у вашому репозиторії, демо-вирізки згенеровані, зміни закомічені
- CLI друкує
shape=(1, 48, 160) dtype=float32 - Сітку збережено і розібрано за чотирма спостереженнями
-
python -m pytest tests/test_image_to_tensor.py -q→8 passed - Звірено три прогнози з «Передбачте»
Ще немає
- Абетки і міток (урок 3) і Dataset з аугментаціями (уроки 4–6). Сьогодні лише картинка → числа одного формату.
- Ціни порога
MIN_CONTRAST_RANGE. Захист спрацює і на дуже блідому, але справжньому тексті: якщо розмах яскравості менше 30 рівнів, контраст не розтягнеться, і бліде чорнило лишиться тусклим. Для нашої синтетики це нормально. На реальних сканах поріг доведеться підбирати — цим займемося в додатку про реальні дані. - Скрипта сітки як «ядра».
experiments/show_preprocess_grid.py— зручна картинка для очей. Логіка контракту — лише вimage_to_tensor.py. - EXIF-орієнтації. У фото з телефона може бути записаний поворот; для синтетичних PNG він не потрібен.
FAQ
Чому полотно саме 48×160, а не квадрат?
Вирізки клітинок бланка зазвичай ширші, ніж вищі: цифри йдуть у рядок. Квадрат або обріже текст, або лишить занадто багато порожнього місця по боках. 48×160 — компроміс для типових значень курсу; дуже широкі рядки все одно дрібнішають — це видно на сітці.
Навіщо інверсія, якщо можна лишити папір білим?
Після letterbox падінг білий (255). Інверсія робить його рівно 0, а штрих — близько 1. Тоді «порожнє місце полотна» і «фон без чорнила» узгоджені: модель не плутає падінг із білим папером як із сильним сигналом.
Чи можна розтягнути вирізку до 48×160 без letterbox?
Можна, але пропорції зламаються: широка «123,45» стане приплюснутою. Letterbox зберігає форму цифр ціною втрати роздільності на дуже широких рядках. Для OCR це зазвичай менше зло, ніж спотворений шрифт.
Чому тести на NumPy, а не одразу на torch.Tensor?
Ядро препроцесингу не залежить від PyTorch: його простіше відлагоджувати і ганяти в CI. Обгортка image_to_tensor тонка; тест обгортки пропускається лише якщо torch не встановлено.
Що буде, якщо прибрати autocontrast_safe?
Порожня клітинка з шумом паперу перетвориться на «текст»: max близько 0.98. Детектор порожніх/заповнених клітинок потім отримає хибний сигнал. Тест test_empty_crop_noise_is_not_amplified якраз ловить цю поломку.
Чи потрібно комітити data/synthetic/raw?
Ні. Вирізки перестворюються скриптом з --seed 42. У репозиторії теку в .gitignore; для статті й уроку достатньо команди генерації.
Що далі
Наступний урок — Урок 3. Абетка, мітки, формат. Dataset з аугментаціями — уроки 4–6.
Еталон для звірки: lesson-02. Клонувати його не потрібно. Попередній: Урок 1. Лабораторія.
Коментарі