Содержание
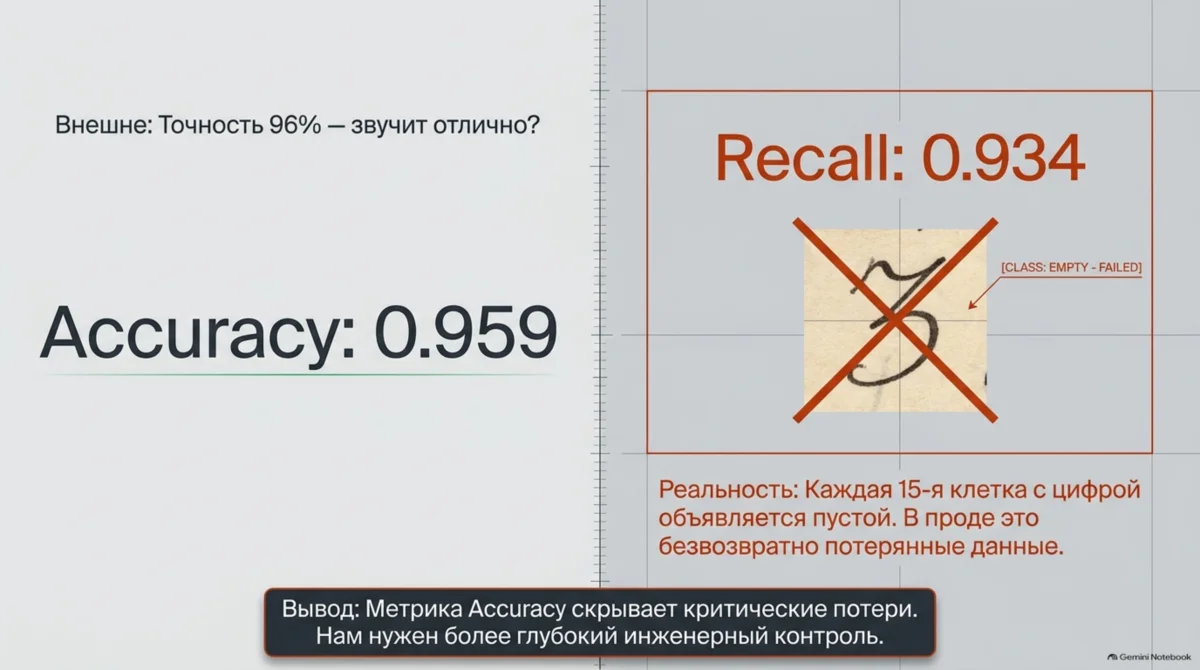
«Точность 96 %» звучит как победа — пока не узнаешь, что каждая пятнадцатая клетка с цифрой объявлена пустой. В проде это не «чуть хуже», а безвозвратно потерянное значение.
В уроке 6 мы собрали Dataset и безопасные аугментации. Сегодня серия «Обучаем CNN и CRNN с нуля» учит первую настоящую модель: маленькую свёрточную сеть empty / value. Но прежде чем нажимать «обучить», нужно ответить на три вопроса.
Файлы урока
src/conv_from_scratch.py— свёртка руками, размер выхода,receptive field, формы и параметрыtiny CNN.src/metrics.py—binary_report: accuracy иrecallпо каждому классу.src/baselines.py— дополненная версия: к 1-NN из урока 5 добавились самый частый класс и правила по «чернилам».src/compare_baselines.py— обучает базовые модели и печатает таблицу.src/models/tiny_cnn.pyиsrc/models/__init__.py— сама сеть.src/train_tiny_cnn.py— обучение с проверками и итоговой таблицей.tests/test_conv_from_scratch.py,tests/test_baselines_simple.py,tests/test_metrics.py,tests/test_tiny_cnn.py— тесты.
Эталон для сверки, если обучение или тесты не сходятся: lesson-07. Клонировать его не нужно: файлы урока вы дописываете в свой репозиторий и коммитите.
Предскажи
Раздел «Предскажи» — не экзамен. Запишите ожидание до таблиц и обучения.
Перед запуском запишите ответы:
- Какая accuracy на
valу наивной модели «всегда отвечай самым частым классом»? А у простого правила «мало ярких пикселей — значит, пусто»: выше 0.9 или ниже 0.8? - Какое
receptive field(сколько пикселей входа видит одна клетка карты признаков) будет у последнего слояtiny CNN? Сравнимо ли оно с высотой цифры (около 30 пикселей)? - Мы дважды применяем к необученной модели на двух классах функцию потерь «кросс-энтропия». Какое число вы ожидаете увидеть как стартовый loss?
Три вопроса урока
- Что такое свёртка на самом деле? Мы напишем её руками на NumPy и сверим с
nn.Conv2d. - С чем сравнивать модель? «Точность 0.96» ничего не значит, пока не известно, сколько даёт глупое правило.
- Как понять, что обучение вообще работает? Две проверки до полного обучения: стартовый loss и переобучение одного батча.
Часть 1. Свёртка руками
Свёртка — это скользящее окно: берём маленький фрагмент картинки, умножаем поэлементно на ядро (набор весов), складываем и записываем одно число. Сдвигаем окно, повторяем. Одно и то же ядро применяется ко всем местам картинки, поэтому свёрточный слой имеет мало параметров и находит один и тот же узор где угодно.
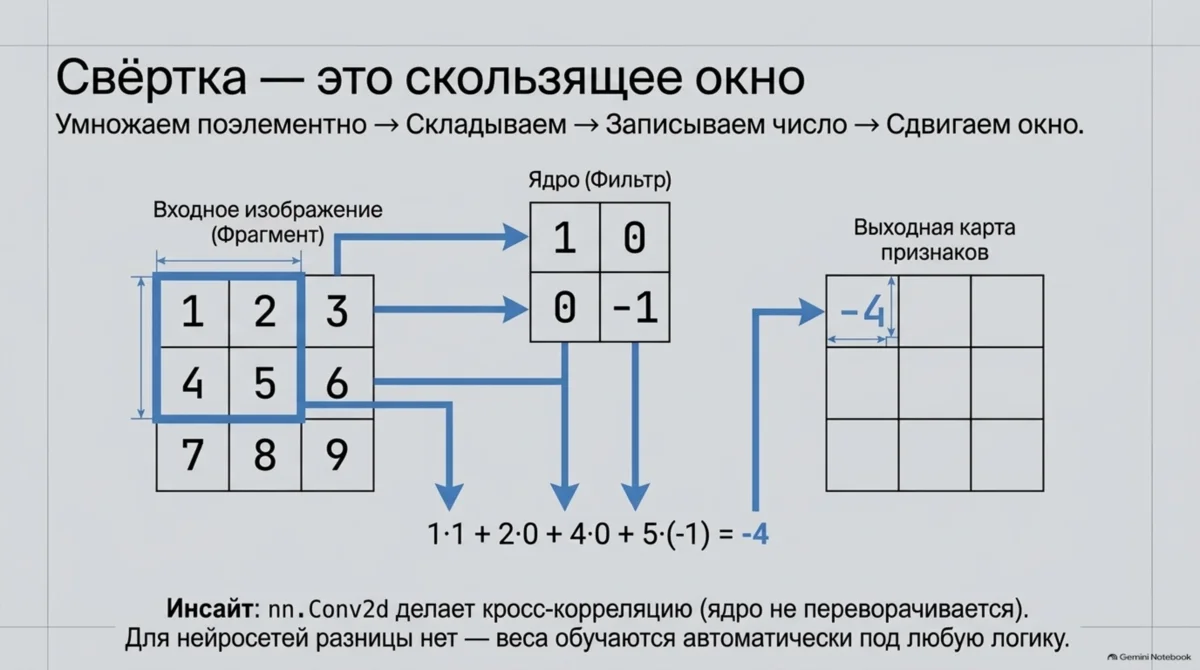
Пример, который стоит проверить на бумаге. Картинка 3×3 с числами от 1 до 9 и ядро 2×2:
вход:     1 2 3         ядро:   1  0
          4 5 6                 0 -1
          7 8 9
Для левого верхнего окна получаем 1·1 + 2·0 + 4·0 + 5·(-1) = -4. Ядро не переворачивается: nn.Conv2d делает кросс-корреляцию; для нейросетей это не важно — веса обучаются.
Размер выхода: (n + 2·padding - k) // stride + 1 по каждой оси. С padding=1 и окном 3×3 размер сохраняется; пулинг 2×2 с шагом 2 уменьшает его вдвое.
receptive field. Одна клетка выхода зависит не от всей картинки, а от окна входа. После нескольких слоёв окно растёт.
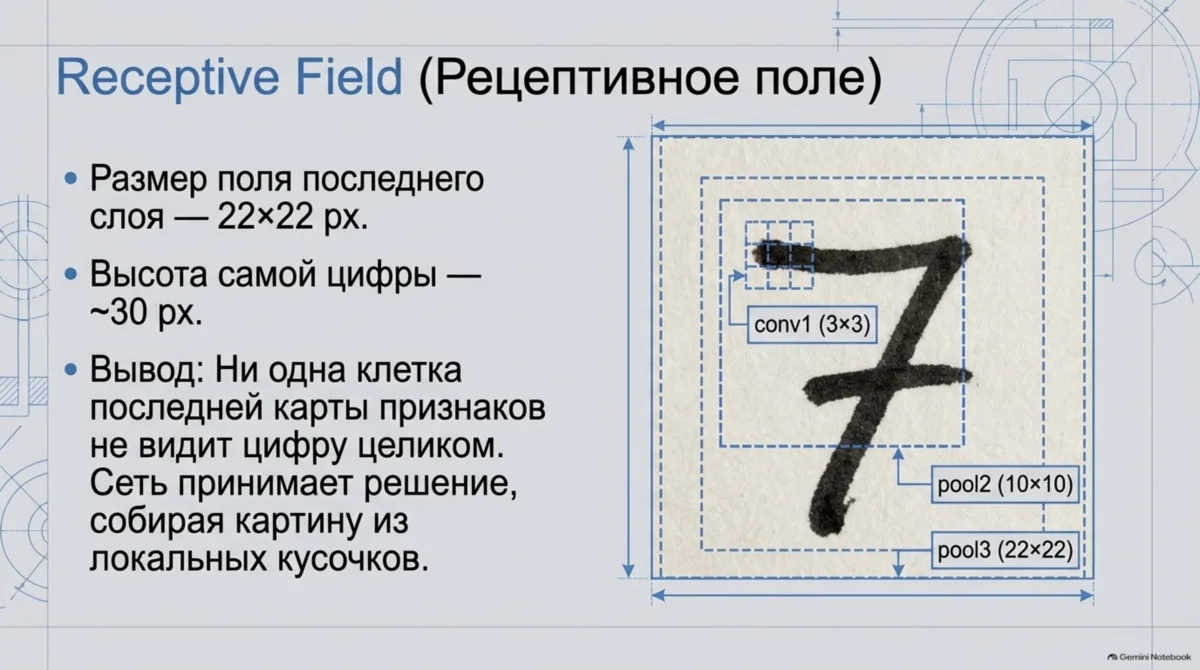
| Слой | Поле, px | «Прыжок» (расстояние между соседними клетками, px) |
|---|---|---|
conv1 |
3 | 1 |
pool1 |
4 | 2 |
conv2 |
8 | 2 |
pool2 |
10 | 4 |
conv3 |
18 | 4 |
pool3 |
22 | 8 |
Ни одна клетка последней карты не видит цифру целиком (~30 px). Сеть собирает решение из локальных кусочков.
Часть 2. С чем сравнивать: базовые модели
Метки: 1 = empty, 0 = value. Базовые модели:
- самый частый класс: всегда один и тот же ответ;
- порог по «чернилам»: «мало чернил — пусто» (два варианта признака);
- 1-NN по пикселям из урока 5.
python src/compare_baselines.py --data-dir data/processedРезультат (val) на теге lesson-07:
модель                              accuracy  value_recall  empty_recall   (val)
всегда самый частый класс              0.622         1.000         0.000
порог по сумме пикселей                0.632         0.966         0.080
порог по числу ярких пикселей          0.709         0.789         0.578
1-NN по пикселям                       0.959         0.934         1.000
Первая идея не сработала. Сумма пикселей ≈ наивный ответ: после инверсии фон тусклой бумаги тоже «светится», и сумма измеряет тусклость бумаги, а не чернила.
Вторая идея лучше, но слабая. Число пикселей ярче 0.3 даёт 0.709. Трудные пустые из урока 4 ломают правило:
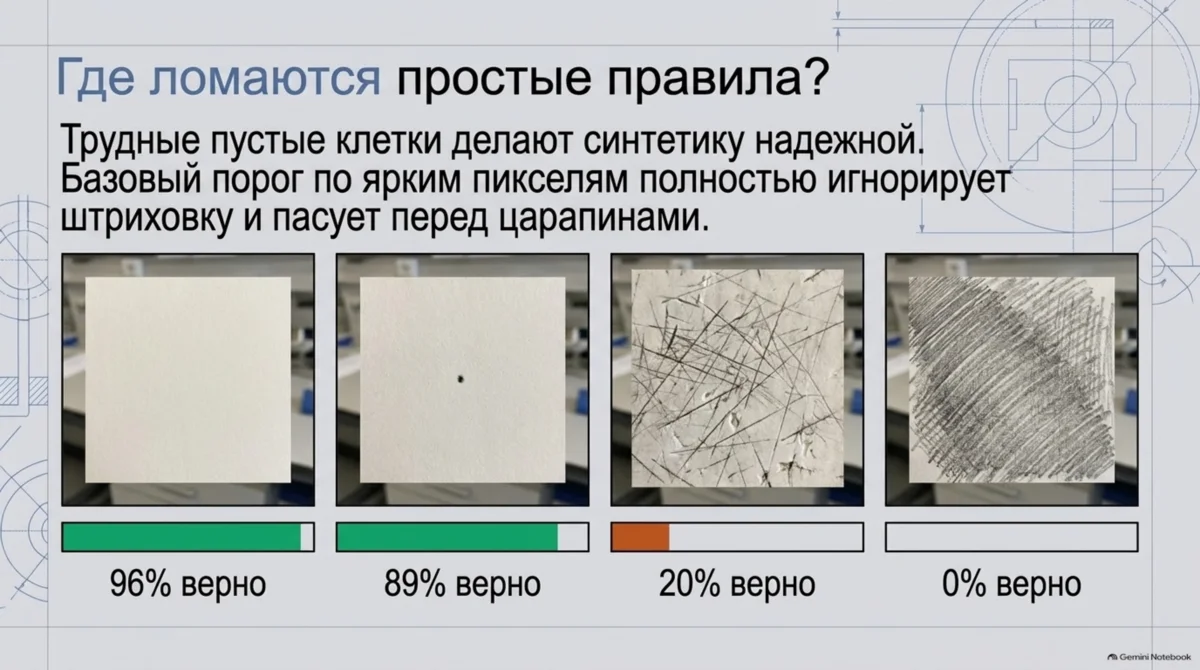
| Вид | Верно |
|---|---|
clean |
0.96 |
specks |
0.89 |
scratch |
0.20 |
hatch |
0.00 |
Accuracy скрывает потери. У 1-NN accuracy 0.959, но value_recall 0.934. Поэтому в таблице три числа, а не одно.
На test (другие 38 листов):
модель                              accuracy  value_recall  empty_recall   (test)
всегда самый частый класс              0.578         1.000         0.000
порог по сумме пикселей                0.592         0.986         0.053
порог по числу ярких пикселей          0.712         0.879         0.483
1-NN по пикселям                       0.983         0.970         1.000
Ориентир для сети: не хуже 0.99 на val (линейные модели на пикселях уже дают около этого).
Часть 3. Модель
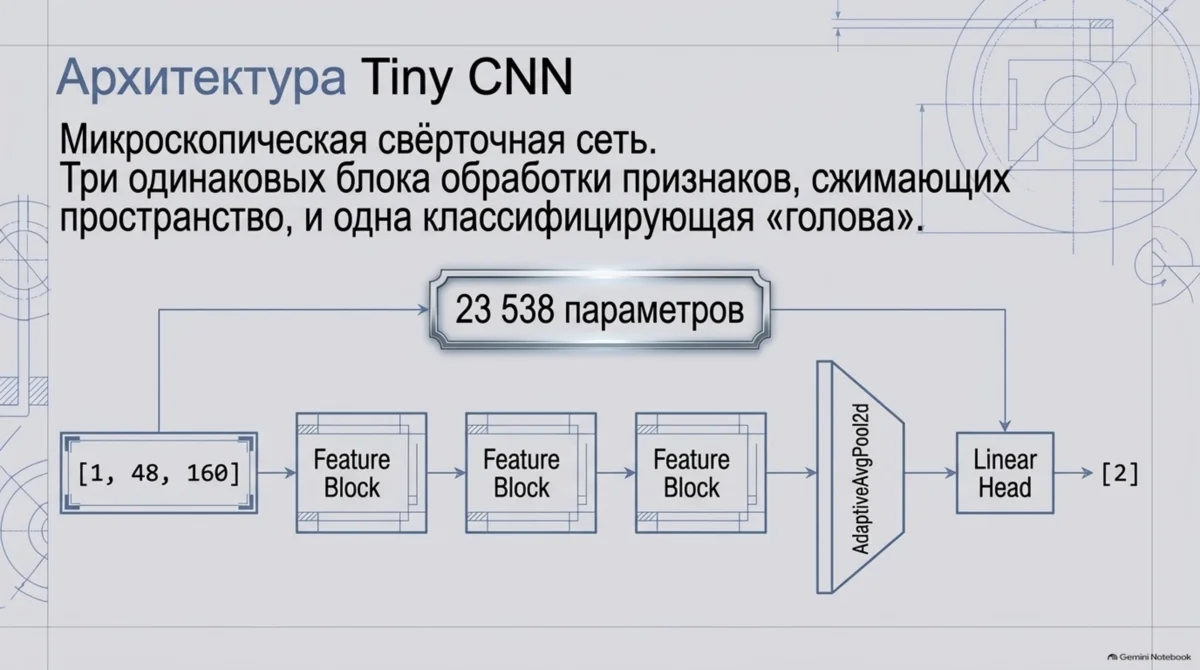
class TinyCNN(nn.Module):
def __init__(self, channels=(16, 32, 64), num_classes: int = 2) -> None:
super().__init__()
layers: list[nn.Module] = []
c_in = 1
for c in channels:
layers += [
nn.Conv2d(c_in, c, kernel_size=3, padding=1, bias=False),
nn.BatchNorm2d(c),
nn.ReLU(inplace=True),
nn.MaxPool2d(2),
]
c_in = c
self.features = nn.Sequential(*layers)
self.pool = nn.AdaptiveAvgPool2d(1)
self.head = nn.Linear(c_in, num_classes)
def forward(self, x: torch.Tensor) -> torch.Tensor:
x = self.features(x)
x = self.pool(x).flatten(1)
return self.head(x)- Три блока: свёртка →
BatchNorm→ReLU→MaxPool. bias=Falseу свёртки: смещение даётBatchNorm.AdaptiveAvgPool2d(1)— голове всё равно, какой ширины картинка.- Голова —
Linearна два класса.
Формы (считает conv_from_scratch.py):
вход             (1, 48, 160)
conv1+BN+ReLU    (16, 48, 160)
pool1            (16, 24, 80)
conv2+BN+ReLU    (32, 24, 80)
pool2            (32, 12, 40)
conv3+BN+ReLU    (64, 12, 40)
pool3            (64, 6, 20)
global avg pool  (64,)
голова           (2,)
параметров: 23538Часть 4. Обучение и две проверки
Если хотя бы одна проверка не проходит, дальше не идём: ошибка в коде или данных, а не «мало эпох».
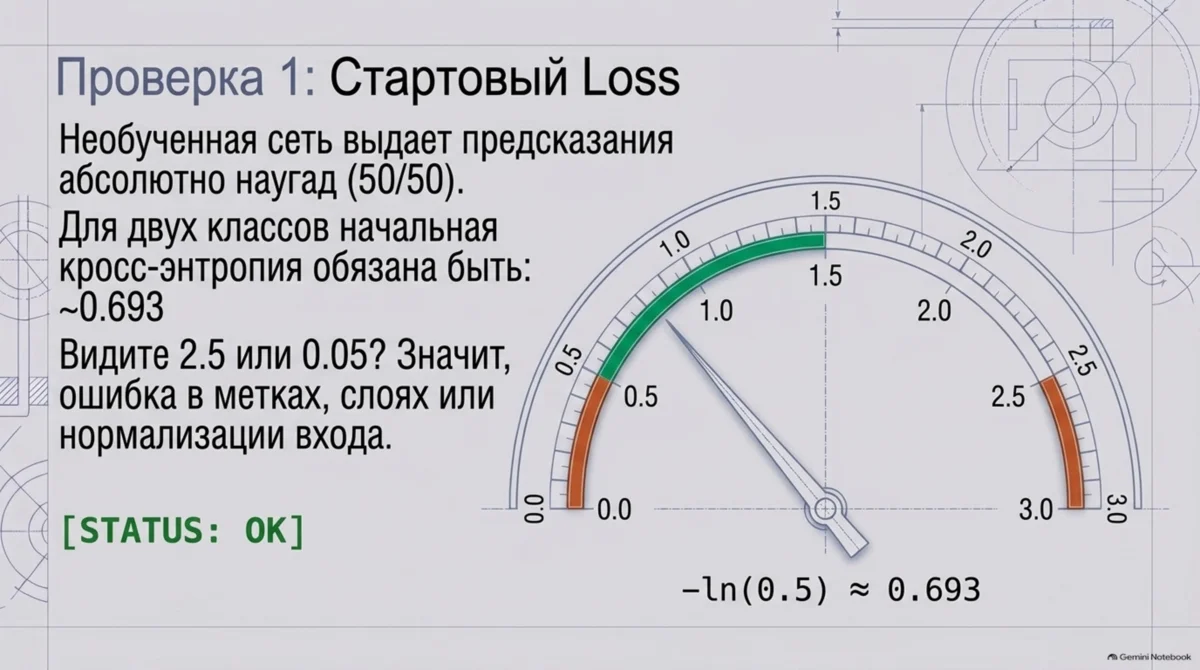
Проверка 1: стартовый loss. У необученной модели на двух классах кросс-энтропия около ln 2 ≈ 0.693.
Проверка 2: переобучение одного батча. За 200 шагов loss уходит почти в ноль, accuracy на батче 1.000.
Обе проверки встроены в train_tiny_cnn.py. Файл набираете сами. Если стартовый loss или переобучение батча не сходятся, сверьте его с эталоном lesson-07 в браузере.
Команды
python src/conv_from_scratch.py
python src/compare_baselines.py --data-dir data/processed
python src/train_tiny_cnn.py --data-dir data/processed --overfit-batch
python src/train_tiny_cnn.py --data-dir data/processed --epochs 10 --out checkpoints/tiny_cnn.pt
python -m pytest tests/test_conv_from_scratch.py tests/test_baselines_simple.py tests/test_metrics.py tests/test_tiny_cnn.py -q
Короткий прогон
python src/conv_from_scratch.py
python src/compare_baselines.py --data-dir data/processed-smoke
python src/train_tiny_cnn.py --data-dir data/processed-smoke --overfit-batch
python src/train_tiny_cnn.py --data-dir data/processed-smoke --epochs 1 --max-batches 3 --out checkpoints/tiny_cnn_smoke.pt
python -m pytest tests/test_conv_from_scratch.py tests/test_baselines_simple.py tests/test_metrics.py tests/test_tiny_cnn.py -q
Ожидаемое
Вывод conv_from_scratch.py (захвачено на теге lesson-07):
форма результата: (4, 12, 20)
naive vs fast: max |разница| = 2.86e-06
naive vs torch nn.Conv2d: max |разница| = 2.86e-06

recept. поле tiny CNN (слой: поле в пикселях входа, прыжок):
  conv1  поле   3 px, прыжок 1
  pool1  поле   4 px, прыжок 2
  conv2  поле   8 px, прыжок 2
  pool2  поле  10 px, прыжок 4
  conv3  поле  18 px, прыжок 4
  pool3  поле  22 px, прыжок 8
...
параметров: 23538
Переобучение одного батча:
Device: mps
параметров: 23538
стартовый loss: 0.689 (ln 2 = 0.693)  OK
  шаг   0: loss 0.7339
  шаг  25: loss 0.0570
  ...
  шаг 200: loss 0.0015
overfit одного батча: loss 0.0015, accuracy 1.000  OK
Полное обучение (10 эпох; лучшая — эпоха 7):
эпоха  1: train loss 0.1720 acc 0.946 | val loss 0.0941 acc 0.991 ...  <- лучшая
...
эпоха  7: train loss 0.0113 acc 0.999 | val loss 0.0119 acc 1.000 (value_recall 1.000, empty_recall 1.000)  <- лучшая
...
чекпоинт: checkpoints/tiny_cnn.pt (эпоха 7)

модель                              accuracy  value_recall  empty_recall   (val)
всегда самый частый класс              0.622         1.000         0.000
порог по сумме пикселей                0.632         0.966         0.080
порог по числу ярких пикселей          0.709         0.789         0.578
1-NN по пикселям                       0.959         0.934         1.000
tiny CNN (эпоха 7)                     1.000         1.000         1.000
У вас устройство может быть cpu или cuda, а лучшая эпоха — другая; важно: стартовый loss около 0.69, overfit OK, val accuracy не хуже 0.99.
Тесты: 20 passed (вся сюита уроков 2–7: 90 passed).
Сравните с предсказаниями.
- Самый частый класс: 0.622 на
val. Правило по ярким пикселям: 0.709 (ниже 0.8). receptive fieldпоследнего слоя 22 пикселя < высоты цифры (~30).- Стартовый loss около
ln 2 = 0.693(у нас 0.689, OK).
Упражнение (эксперимент)
- Уберите
BatchNorm. ВTinyCNNудалитеnn.BatchNorm2d(c)и верните свёрткеbias=True. Как изменились кривая loss и итоговая точность? - Уменьшите сеть вдвое. Поставьте
channels=(8, 16, 32). Параметров станет 6010 (tiny_cnn_summary(channels=(8, 16, 32))). Сколько точности потеряли? - Включите аугментацию. Добавьте
--augmentи сравните разрывtrain/valaccuracy с запуском без неё.
Запишите для каждого варианта: val accuracy, value_recall, empty_recall.
Если не так
ModuleNotFoundError: No module named 'torch'. Окружение из урока 1 не активировано.- Стартовый loss сильно отличается от 0.69. Проверьте метки (только 0 и 1), форму входа
[B, 1, 48, 160]и головуLinear(64, 2). - Переобучение одного батча не получается. Слишком маленький/большой
lr, перепутанные метки, модель вeval, «пустые» данные. Сначала почините--overfit-batch. val accзастыла на 0.62. Модель всегда отвечает одним классом: проверьтеmodel.train(),optimizer.step(),lr.RuntimeError: mat1 and mat2 shapes cannot be multiplied. Размер входа головы не 64.- Обучение медленное на CPU.
--max-batchesдля отладки или--workers 2. - Тест
test_matches_scipy_correlateпропущен.scipyне установлен; это нормально.
Чек-лист
- Файлы урока в вашем репозитории и закоммичены
-
conv_from_scratch.py:naive≈ torch, RF до 22 px, 23538 параметров - Таблица
baselinesнаvalпрочитана -
--overfit-batch→ OK - Полное обучение:
valacc≥ 0.99, чекпоинт сохранён -
pytest→20 passed - Сверены три прогноза из «Предскажи»
FAQ
Почему метка 1 = empty, а не value?
Так договорено в Dataset (урок 6): EMPTY_CLASS = 1. P(empty) в следующих уроках — вероятность класса 1.
Зачем BatchNorm в такой маленькой сети?
Он стабилизирует масштабы активаций и позволяет убрать bias у свёртки. В упражнении можно убрать BatchNorm и сравнить кривую loss.
Почему не смотреть сразу на test?
Лучшую эпоху мы выбираем по val. Итог на test откроем в уроке 8, когда появится порог и честное разведение настройки и итога.
У меня на CPU обучение долгое. Это нормально?
Да. На Apple Silicon / GPU 10 эпох занимают минуты; на CPU — дольше. Для отладки используйте --max-batches и датасет smoke.
Accuracy 1.000 на val — это не подозрительно?
На нашей синтетике задача empty/value действительно лёгкая для обучаемой модели (линейные модели уже ~0.99). Подозрительнее было бы 0.62. В проде появятся реальные сканы и фотографии бланков — тогда цифры упадут, а порог из урока 8 станет критичен.
Нужно ли коммитить checkpoints/tiny_cnn.pt?
Нет. Папка в .gitignore; чекпоинт пересоздаётся командой обучения.
Что дальше
argmax — не прод-решение. Следующий урок — Урок 8. Порог решения. Прод-рецепт (баланс, early stopping, config) — урок 9.
Эталон для сверки: lesson-07. Клонировать его не нужно. Предыдущий: Урок 6. Dataset и аугментации.
Комментарии