Зміст
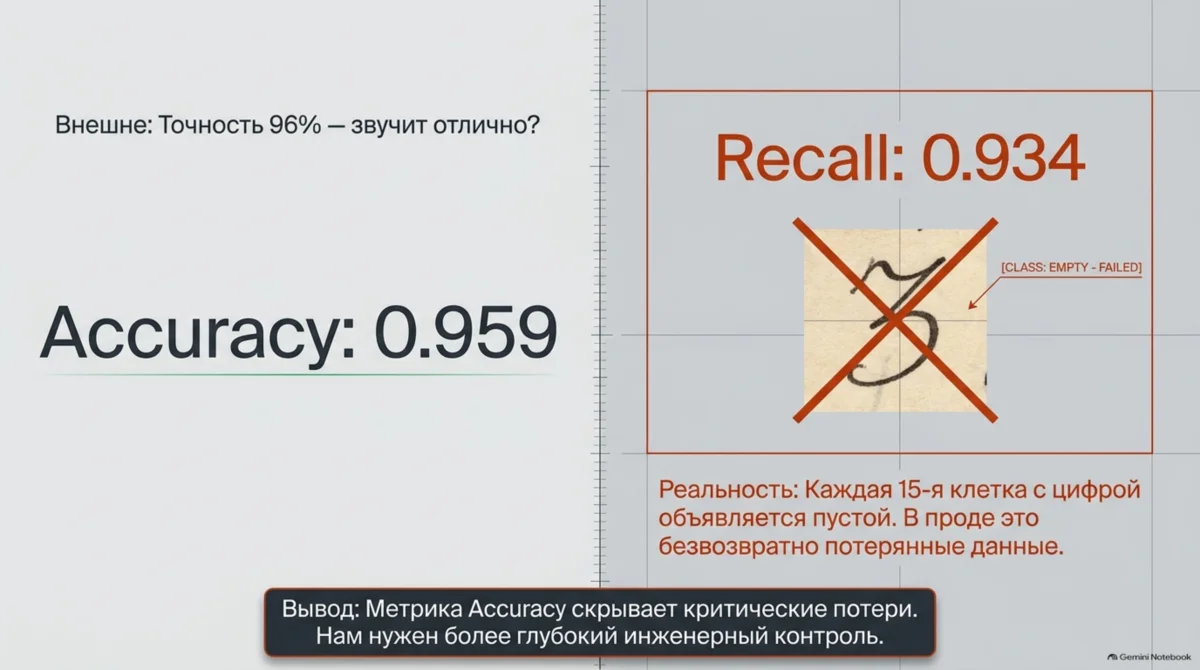
«Точність 96 %» звучить як перемога, поки не з'ясуєш, що кожну п'ятнадцяту клітинку з цифрою оголошено порожньою. У робочій системі це не «трохи гірше», а безповоротно втрачене значення.
У уроці 6 ми зібрали Dataset і безпечні аугментації. Сьогодні серія «Навчаємо CNN і CRNN з нуля» навчає першу справжню модель: маленьку згорткову мережу empty / value. Перш ніж натискати «навчити», треба відповісти на три питання.
Файли уроку
src/conv_from_scratch.py— згортка руками, розмір виходу,receptive field, форми і параметриtiny CNN.src/metrics.py—binary_report: accuracy іrecallдля кожного класу.src/baselines.py— доповнена версія: до 1-NN з уроку 5 додались найчастіший клас і правила за «чорнилом».src/compare_baselines.py— навчає базові моделі і друкує таблицю.src/models/tiny_cnn.pyіsrc/models/__init__.py— сама мережа.src/train_tiny_cnn.py— навчання з перевірками і підсумковою таблицею.tests/test_conv_from_scratch.py,tests/test_baselines_simple.py,tests/test_metrics.py,tests/test_tiny_cnn.py— тести.
Еталон для звірки, якщо навчання або тести не сходяться: lesson-07. Клонувати його не потрібно: файли уроку ви дописуєте у свій репозиторій і комітите.
Передбачте
Розділ «Передбачте» — не іспит. Запишіть очікування до таблиць і навчання.
Перед запуском запишіть відповіді:
- Яка accuracy на
valу наївної моделі «завжди відповідай найчастішим класом»? А у простого правила «мало яскравих пікселів — значить, порожньо»: вище 0.9 чи нижче 0.8? - Яке
receptive field(скільки пікселів входу бачить одна клітинка карти ознак) буде в останнього шаруtiny CNN? Чи порівнянне воно з висотою цифри (близько 30 пікселів)? - Ми двічі застосовуємо до ненавченої моделі на двох класах функцію втрат «крос-ентропія». Яке число ви очікуєте побачити як стартовий loss?
Три питання уроку
- Що таке згортка насправді? Ми напишемо її руками на NumPy і звіримо з
nn.Conv2d. - З чим порівнювати модель? «Точність 0.96» нічого не означає, поки не відомо, скільки дає дурне правило.
- Як зрозуміти, що навчання взагалі працює? Дві перевірки до повного навчання: стартовий loss і перенавчання одного батча.
Частина 1. Згортка руками
Згортка — це ковзне вікно: беремо маленький фрагмент картинки, множимо поелементно на ядро (набір ваг), складаємо і записуємо одне число. Зсуваємо вікно, повторюємо. Те саме ядро застосовується до всіх місць картинки, тому згортковий шар має мало параметрів і знаходить той самий візерунок будь-де.
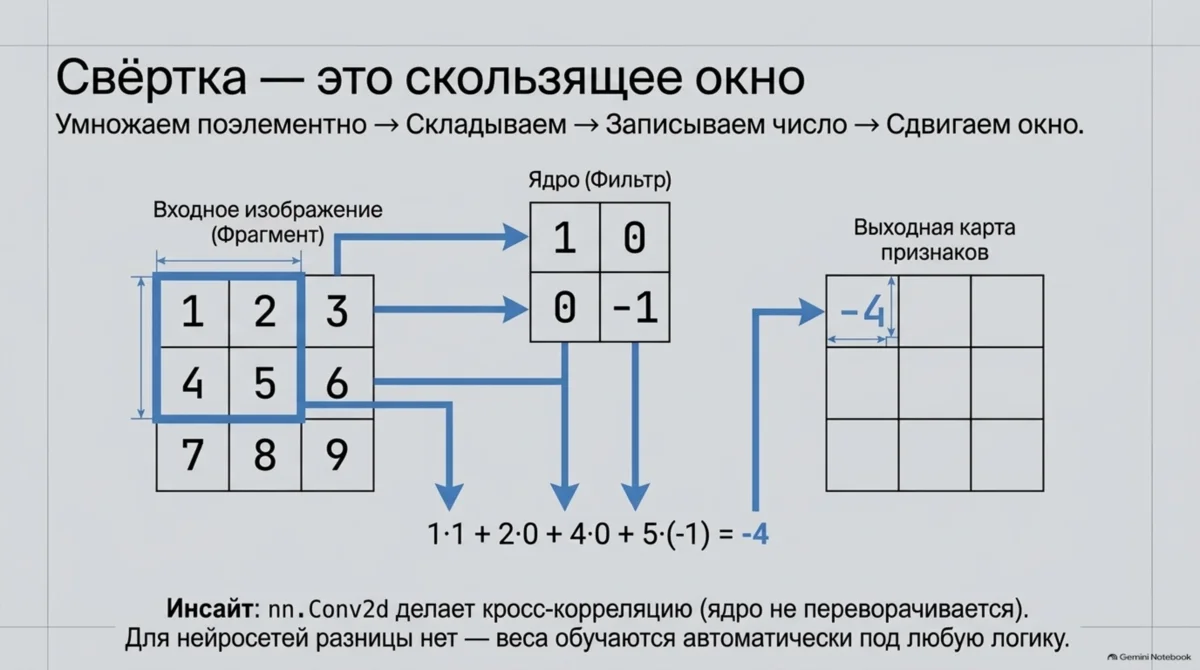
Приклад, який варто перевірити на папері. Картинка 3×3 з числами від 1 до 9 і ядро 2×2:
вхід:     1 2 3         ядро:   1  0
          4 5 6                 0 -1
          7 8 9
Для лівого верхнього вікна отримуємо 1·1 + 2·0 + 4·0 + 5·(-1) = -4. Ядро не перевертається: nn.Conv2d рахує взаємну кореляцію. Для нейромереж це не важливо, бо ваги навчаються.
Розмір виходу: (n + 2·padding - k) // stride + 1 по кожній осі. З padding=1 і вікном 3×3 розмір зберігається; пулінг 2×2 з кроком 2 зменшує його вдвічі.
receptive field. Одна клітинка виходу залежить не від усієї картинки, а від вікна входу. Після кількох шарів вікно росте.
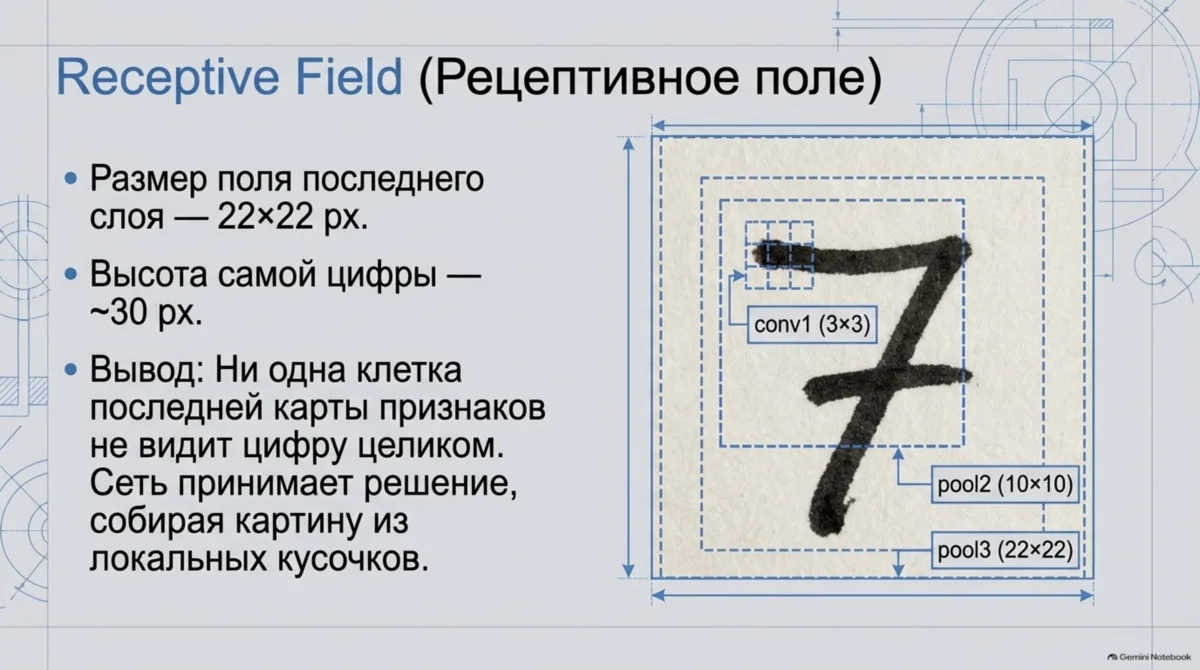
| Шар | Поле, px | «Стрибок» (відстань між сусідніми клітинками, px) |
|---|---|---|
conv1 |
3 | 1 |
pool1 |
4 | 2 |
conv2 |
8 | 2 |
pool2 |
10 | 4 |
conv3 |
18 | 4 |
pool3 |
22 | 8 |
Жодна клітинка останньої карти не бачить цифру цілком (~30 px). Мережа збирає рішення з локальних шматків.
Частина 2. З чим порівнювати: базові моделі
Мітки: 1 = empty, 0 = value. Базові моделі:
- найчастіший клас: завжди одна й та сама відповідь;
- поріг за «чорнилом»: «мало чорнила — порожньо» (два варіанти ознаки);
- 1-NN за пікселями з уроку 5.
python src/compare_baselines.py --data-dir data/processedРезультат (val) на тегу lesson-07. Скрипт друкує російські підписи; звіряйте числа:
модель                              accuracy  value_recall  empty_recall   (val)
всегда самый частый класс              0.622         1.000         0.000
порог по сумме пикселей                0.632         0.966         0.080
порог по числу ярких пикселей          0.709         0.789         0.578
1-NN по пикселям                       0.959         0.934         1.000
Перша ідея не спрацювала. Сума пікселів ≈ наївна відповідь: після інверсії фон тьмяного паперу теж «світиться», і сума міряє тьмяність паперу, а не чорнило.
Друга ідея краща, але слабка. Число пікселів яскравіших за 0.3 дає 0.709. Важкі порожні з уроку 4 ламають правило:
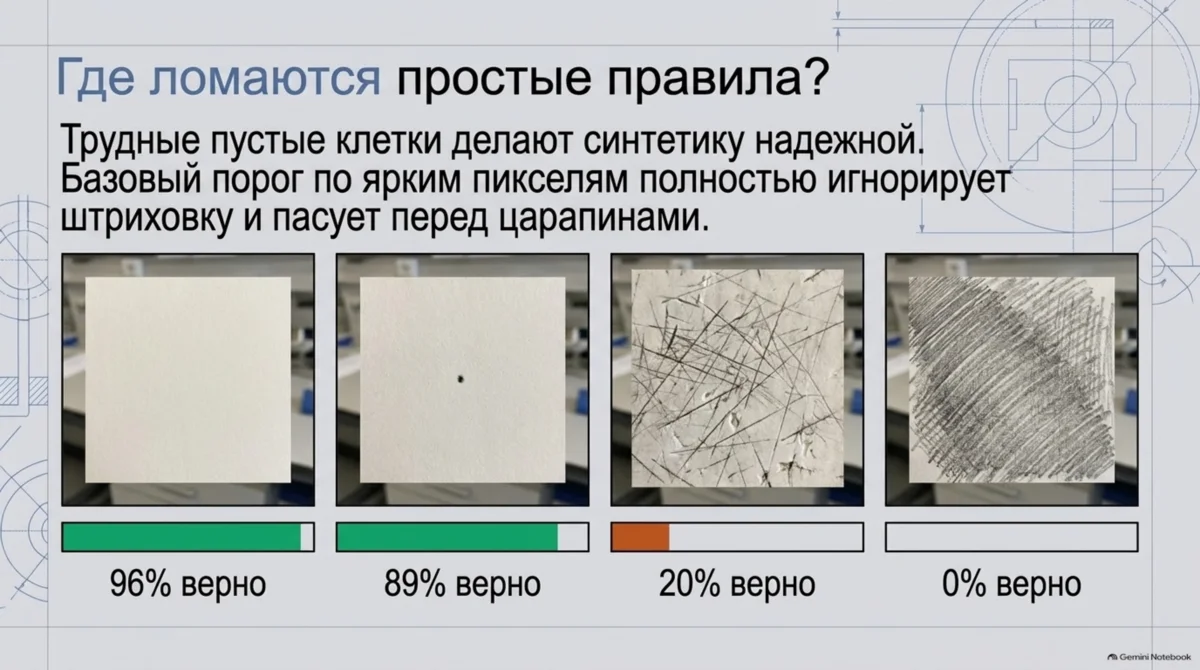
| Вид | Вірно |
|---|---|
clean |
0.96 |
specks |
0.89 |
scratch |
0.20 |
hatch |
0.00 |
Accuracy ховає втрати. У 1-NN accuracy 0.959, але value_recall 0.934. Тому в таблиці три числа, а не одне.
На test (інші 38 аркушів):
модель                              accuracy  value_recall  empty_recall   (test)
всегда самый частый класс              0.578         1.000         0.000
порог по сумме пикселей                0.592         0.986         0.053
порог по числу ярких пикселей          0.712         0.879         0.483
1-NN по пикселям                       0.983         0.970         1.000
Орієнтир для мережі: не гірше 0.99 на val (лінійні моделі на пікселях уже дають близько цього).
Частина 3. Модель
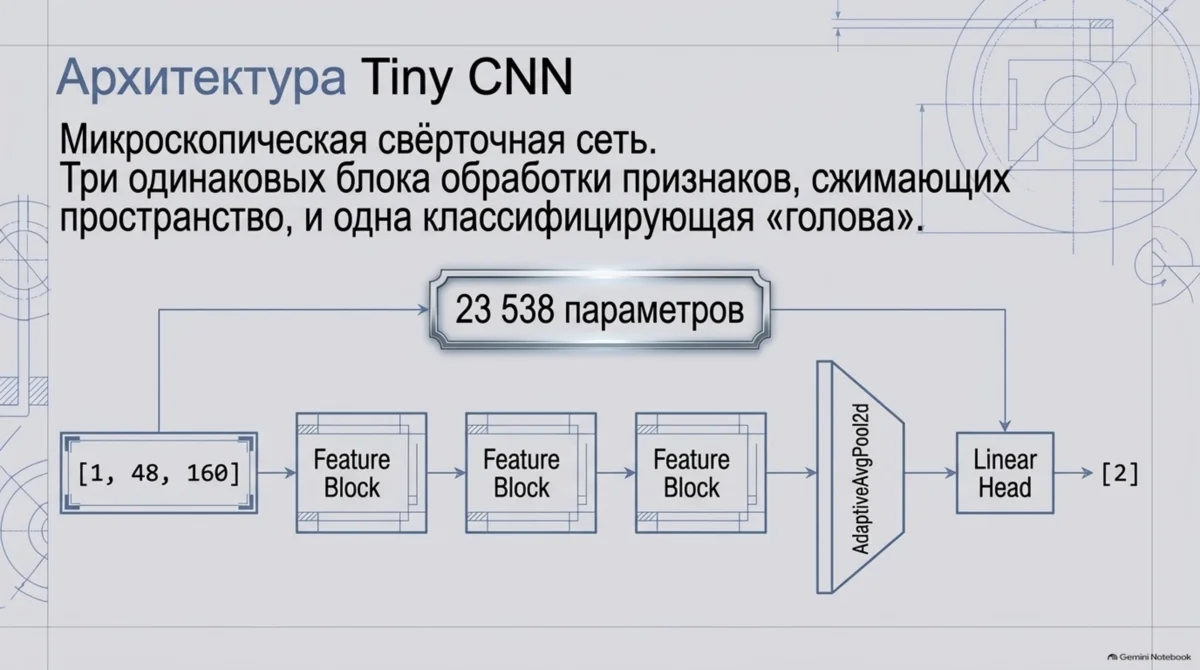
class TinyCNN(nn.Module):
def __init__(self, channels=(16, 32, 64), num_classes: int = 2) -> None:
super().__init__()
layers: list[nn.Module] = []
c_in = 1
for c in channels:
layers += [
nn.Conv2d(c_in, c, kernel_size=3, padding=1, bias=False),
nn.BatchNorm2d(c),
nn.ReLU(inplace=True),
nn.MaxPool2d(2),
]
c_in = c
self.features = nn.Sequential(*layers)
self.pool = nn.AdaptiveAvgPool2d(1)
self.head = nn.Linear(c_in, num_classes)
def forward(self, x: torch.Tensor) -> torch.Tensor:
x = self.features(x)
x = self.pool(x).flatten(1)
return self.head(x)- Три блоки: згортка →
BatchNorm→ReLU→MaxPool. bias=Falseу згортки: зсув даєBatchNorm.AdaptiveAvgPool2d(1)— голові байдуже, якої ширини картинка.- Голова —
Linearна два класи.
Форми (рахує conv_from_scratch.py). Скрипт друкує російські підписи; звіряйте числа:
вход             (1, 48, 160)
conv1+BN+ReLU    (16, 48, 160)
pool1            (16, 24, 80)
conv2+BN+ReLU    (32, 24, 80)
pool2            (32, 12, 40)
conv3+BN+ReLU    (64, 12, 40)
pool3            (64, 6, 20)
global avg pool  (64,)
голова           (2,)
параметров: 23538Частина 4. Навчання і дві перевірки
Якщо хоч одна перевірка не проходить, далі не йдемо: помилка в коді або даних, а не «мало епох».
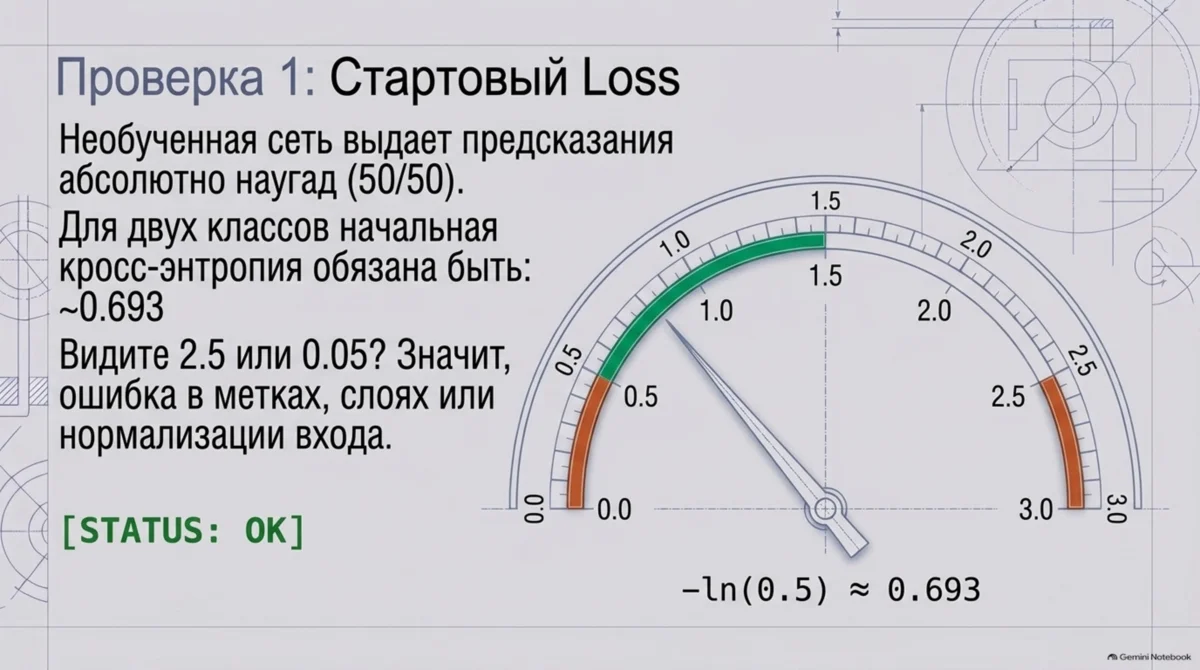
Перевірка 1: стартовий loss. У ненавченої моделі на двох класах крос-ентропія близько ln 2 ≈ 0.693.
Перевірка 2: перенавчання одного батча. За 200 кроків loss іде майже в нуль, accuracy на батчі 1.000.
Обидві перевірки вбудовані в train_tiny_cnn.py. Файл набираєте самі. Якщо стартовий loss або перенавчання батча не сходяться, звіряйте його з еталоном lesson-07 у браузері.
Команди
python src/conv_from_scratch.py
python src/compare_baselines.py --data-dir data/processed
python src/train_tiny_cnn.py --data-dir data/processed --overfit-batch
python src/train_tiny_cnn.py --data-dir data/processed --epochs 10 --out checkpoints/tiny_cnn.pt
python -m pytest tests/test_conv_from_scratch.py tests/test_baselines_simple.py tests/test_metrics.py tests/test_tiny_cnn.py -q
Короткий прогін
python src/conv_from_scratch.py
python src/compare_baselines.py --data-dir data/processed-smoke
python src/train_tiny_cnn.py --data-dir data/processed-smoke --overfit-batch
python src/train_tiny_cnn.py --data-dir data/processed-smoke --epochs 1 --max-batches 3 --out checkpoints/tiny_cnn_smoke.pt
python -m pytest tests/test_conv_from_scratch.py tests/test_baselines_simple.py tests/test_metrics.py tests/test_tiny_cnn.py -q
Очікуване
Вивід conv_from_scratch.py (знято на тегу lesson-07). Скрипт друкує російські підписи; звіряйте числа:
форма результата: (4, 12, 20)
naive vs fast: max |разница| = 2.86e-06
naive vs torch nn.Conv2d: max |разница| = 2.86e-06

recept. поле tiny CNN (слой: поле в пикселях входа, прыжок):
  conv1  поле   3 px, прыжок 1
  pool1  поле   4 px, прыжок 2
  conv2  поле   8 px, прыжок 2
  pool2  поле  10 px, прыжок 4
  conv3  поле  18 px, прыжок 4
  pool3  поле  22 px, прыжок 8
...
параметров: 23538
Перенавчання одного батча:
Device: mps
параметров: 23538
стартовый loss: 0.689 (ln 2 = 0.693)  OK
  шаг   0: loss 0.7339
  шаг  25: loss 0.0570
  ...
  шаг 200: loss 0.0015
overfit одного батча: loss 0.0015, accuracy 1.000  OK
Повне навчання (10 епох; найкраща — епоха 7):
эпоха  1: train loss 0.1720 acc 0.946 | val loss 0.0941 acc 0.991 ...  <- лучшая
...
эпоха  7: train loss 0.0113 acc 0.999 | val loss 0.0119 acc 1.000 (value_recall 1.000, empty_recall 1.000)  <- лучшая
...
чекпоинт: checkpoints/tiny_cnn.pt (эпоха 7)

модель                              accuracy  value_recall  empty_recall   (val)
всегда самый частый класс              0.622         1.000         0.000
порог по сумме пикселей                0.632         0.966         0.080
порог по числу ярких пикселей          0.709         0.789         0.578
1-NN по пикселям                       0.959         0.934         1.000
tiny CNN (эпоха 7)                     1.000         1.000         1.000
У вас пристрій може бути cpu або cuda, а найкраща епоха — інша; важливо: стартовий loss близько 0.69, overfit OK, val accuracy не гірше 0.99.
Тести: 20 passed (уся сюїта уроків 2–7: 90 passed).
Порівняйте з прогнозами.
- Найчастіший клас: 0.622 на
val. Правило за яскравими пікселями: 0.709 (нижче 0.8). receptive fieldостаннього шару 22 пікселі < висоти цифри (~30).- Стартовий loss близько
ln 2 = 0.693(у нас 0.689, OK).
Вправа
- Приберіть
BatchNorm. УTinyCNNвидалітьnn.BatchNorm2d(c)і поверніть згортціbias=True. Як змінилися крива loss і підсумкова точність? - Зменште мережу вдвічі. Поставте
channels=(8, 16, 32). Параметрів стане 6010 (tiny_cnn_summary(channels=(8, 16, 32))). Скільки точності втратили? - Увімкніть аугментацію. Додайте
--augmentі порівняйте розривtrain/valaccuracy із запуском без неї.
Запишіть для кожного варіанта: val accuracy, value_recall, empty_recall.
Якщо не так
ModuleNotFoundError: No module named 'torch'. Оточення з уроку 1 не активоване.- Стартовий loss сильно відрізняється від 0.69. Перевірте мітки (лише 0 і 1), форму входу
[B, 1, 48, 160]і головуLinear(64, 2). - Перенавчання одного батча не виходить. Надто малий або великий
lr, переплутані мітки, модель уeval, «порожні» дані. Спочатку полагодьте--overfit-batch. val accзавмерла на 0.62. Модель завжди відповідає одним класом: перевіртеmodel.train(),optimizer.step(),lr.RuntimeError: mat1 and mat2 shapes cannot be multiplied. Розмір входу голови не 64.- Навчання повільне на CPU.
--max-batchesдля налагодження або--workers 2. - Тест
test_matches_scipy_correlateпропущено.scipyне встановлено; це нормально.
Контрольний список
- Файли уроку у вашому репозиторії і закомічені
-
conv_from_scratch.py:naive≈ torch, RF до 22 px, 23538 параметрів - Таблицю
baselinesнаvalпрочитано -
--overfit-batch→ OK - Повне навчання:
valacc≥ 0.99, чекпоінт збережено -
pytest→20 passed - Звірені три прогнози з «Передбачте»
FAQ
Чому мітка 1 = empty, а не value?
Так домовлено в Dataset (урок 6): EMPTY_CLASS = 1. P(empty) у наступних уроках — імовірність класу 1.
Навіщо BatchNorm у такій маленькій мережі?
Він стабілізує масштаби активацій і дозволяє прибрати bias у згортки. У вправі можна прибрати BatchNorm і порівняти криву loss.
Чому не дивитися одразу на test?
Найкращу епоху ми обираємо за val. Підсумок на test відкриємо в уроці 8, коли з'явиться поріг і чесний поділ налаштування й підсумку.
У мене на CPU навчання довге. Це нормально?
Так. На Apple Silicon / GPU 10 епох займають хвилини; на CPU — довше. Для налагодження використовуйте --max-batches і датасет smoke.
Accuracy 1.000 на val — це не підозріло?
На нашій синтетиці задача empty/value справді легка для моделі, що вчиться (лінійні моделі вже ~0.99). Підозріліше було б 0.62. У робочій системі з'являться реальні скани і фотографії бланків — тоді числа впадуть, а поріг з уроку 8 стане критичним.
Чи потрібно комітити checkpoints/tiny_cnn.pt?
Ні. Тека в .gitignore; чекпоінт створюється заново командою навчання.
Що далі
argmax — не рішення для робочої системи. Наступний урок — Урок 8. Поріг рішення. Рецепт для робочої системи (баланс, early stopping, config) — урок 9.
Еталон для звірки: lesson-07. Клонувати його не потрібно. Попередній: Урок 6. Dataset і аугментації.
Коментарі