

Зміст
Таблиця на два мільярди рядків в ERP не «гальмує, бо велика». Вона гальмує, коли запит читає зайве, індекс не збігся з фільтром, статистика бреше, транзакція тримає блокування або звіт щоразу перераховує всю історію. Нижче повний практичний контур: від виміру за 15–30 хвилин до схеми, партицій, кешу та розподіленої архітектури. Матеріал не прив'язаний до однієї СУБД. Приклади спираються на PostgreSQL, Microsoft SQL Server і MySQL/InnoDB, з окремим фокусом на EAV та корпоративні системи.
Ключові висновки
Обсяг сам по собі не дорівнює повільності. Мільярд рядків із вузьким індексом і відсіканням партицій може відповідати швидше, ніж десять мільйонів без селективності та із SELECT *.
Діагноз раніше за рецепт. План виконання, логічні читання, p95 і очікування блокувань кажуть більше, ніж відчуття «база важка».
Індекс не є безкоштовним прискорювачем. Він прискорює читання обраних шляхів і сповільнює кожен запис. Зайвий індекс на гарячій таблиці часто гірший за відсутність потрібного.
EAV і широкі ERP-таблиці ламаються не через «SQL Server / Postgres», а через модель. Багато атрибутів через з'єднання й одна колонка value б'ють і по оптимізатору, і по індексах. Докладний розбір патерну є в окремій статті про EAV.
Партиціонування є інструментом супроводу й відсікання даних, а не чарівною кнопкою. Без pruning і без політики архіву воно лише додає складності.
Масштабування вшир після локального безладу розмножує безлад. Репліка й шард мають сенс, коли вузьке місце вже названо й локально вичерпано.
Чому величезні бази починають гальмувати
«Велика база» в розмові команди зазвичай означає різне. Для одних це десятки мільйонів рядків у замовленні. Для інших це сотні гігабайтів індексів. Для третіх це одна таблиця рухів на два мільярди записів у контурі ERP. Практичніше мислити порогами поведінки, а не ярликами. Поки робочий набір гарячих даних вміщується в буферний пул і фільтри селективні, обсяг на диску майже не відчутний. Біль починається, коли план читає широкі діапазони, оцінка кардинальності бреше на порядки, або конкуренція за гарячі сторінки перетворює швидкий поодинокий запит на чергу.
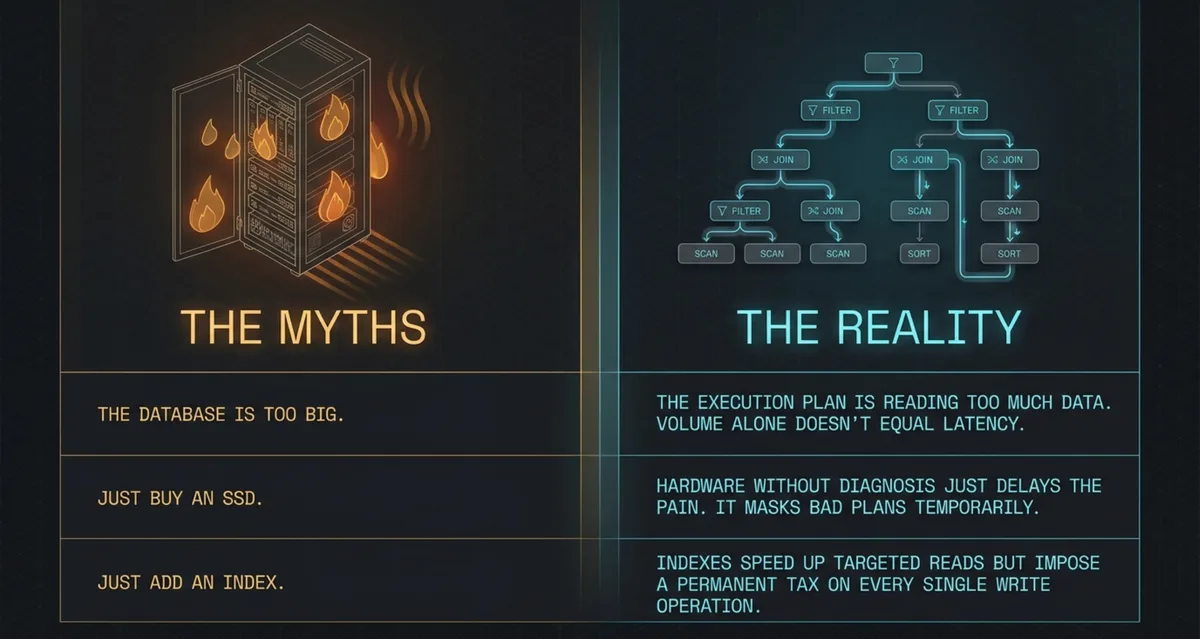
Типовий сценарій знайомий із майданчиків упровадження. Облік живе роками, таблиця документів чи значень атрибутів росте без архіву, звіти за період сканують історію, а «тимчасову» практику додавати індекс під кожен новий фільтр уже ніхто не переглядає. Додавання CPU та SSD на певний час скорочує дискову чергу й маскує той самий поганий план. За квартал навантаження наздоганяє залізо. Суміжний контекст щодо моноліту й накопиченої складності: чому ERP стають монолітами та леґасі на п'ятнадцять років.
Міфи про оптимізацію тримаються, бо іноді спрацьовують. «Додамо індекс» допомагає, якщо фільтр селективний і порядок стовпців збігся. «Купимо SSD» допомагає за суто випадкового читання сторінок. «Перепишемо запит» допомагає, коли зайві з'єднання та неявні перетворення справді є в плані. Помилка в тому, щоб робити будь-який із цих кроків без виміру: на який ресурс чекає потік, скільки сторінок читається, чи збігається оцінка рядків із фактом.
Діагностика: спершу міряємо, потім оптимізуємо
Що вимірювати
Зафіксуйте проблемний сценарій так, щоб його можна було повторити: конкретний запит або API, обсяг вхідних параметрів, час доби. Дивіться не лише на середнє. Для користувача важливі хвости: p50, p95, p99. Поруч відстежуйте пропускну здатність (запити або транзакції на секунду), кількість логічних і фізичних читань сторінок, CPU, тиск на пам'ять, довжину дискової черги, очікування блокувань і дедлоки. Окремо зафіксуйте розмір таблиці, індексів, журналу транзакцій (WAL) та обсяг тимчасових файлів під час сортувань і хеш-з'єднань.
Інструменти за рушіями
У PostgreSQL базовий контур такий: EXPLAIN (ANALYZE, BUFFERS) на відтворюваному запиті та pg_stat_statements для топу за сумарним часом. У SQL Server це Actual Execution Plan, Query Store для регресій планів, DMV щодо очікувань і, за потреби, Extended Events. У MySQL 8 це EXPLAIN ANALYZE, Performance Schema і журнал повільних запитів із розумним порогом. На рівні застосунку корисні трейси з тривалістю SQL і лічильником кіл до сервера. Без них N+1 виглядає як «повільна база», хоча база відповідає за мілісекунди.
Як читати план
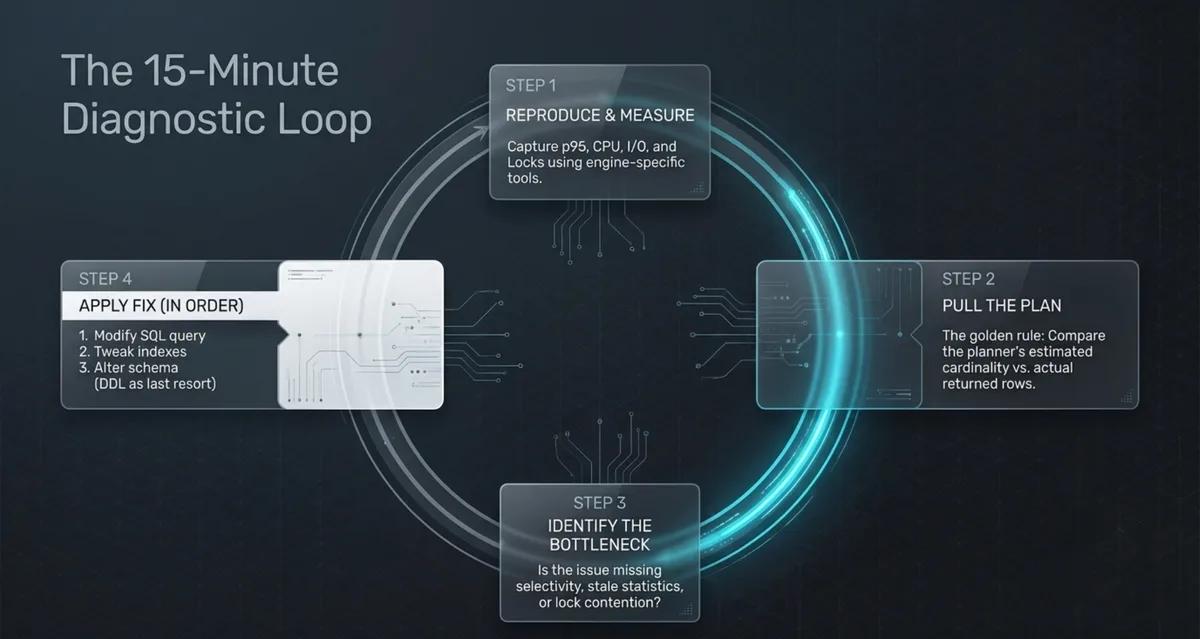
Шукайте повне сканування там, де чекали вузький індекс; Nested Loop на великих сторонах з'єднання; Hash Join або Merge Join із несподіваним сортуванням; вивантаження в тимчасові файли чи TempDB. Головний сигнал: розбіжність оціночної й фактичної кількості рядків на порядки. Причини: застаріла статистика, кореляції стовпців, параметр, для якого план «винюхали» один раз. Алгоритм на 15–30 хвилин: відтворити, зняти план із фактом, назвати домінантне очікування (CPU / I/O / блокування), перевірити селективність фільтра й актуальність статистики, і лише потім змінювати індекс або текст SQL.
Дерево швидкого рішення виглядає так. Багато логічних читань і широкий діапазон: індекс, покриття, ранній фільтр. Оцінка рядків бреше: статистика й параметри. Запит сам по собі швидкий, а під навантаженням ні: блокування й гарячі сторінки. Важкий звіт по історії: агрегати, матеріалізація, винесення в аналітичне сховище, а не ще один B-tree на OLTP.
Практичний прохід за чверть години: (1) відтворити на копії або в тихому вікні з тими самими параметрами; (2) зняти план із фактом (ANALYZE / фактичний план); (3) виписати головне очікування за інтервал проблеми; (4) порівняти оцінку й факт на найдорожчих вузлах; (5) вирішити, що це: селективність, статистика, блокування чи обсяг результату. Лише після п'ятого кроку відкривайте DDL.
Оптимізація SQL-запитів
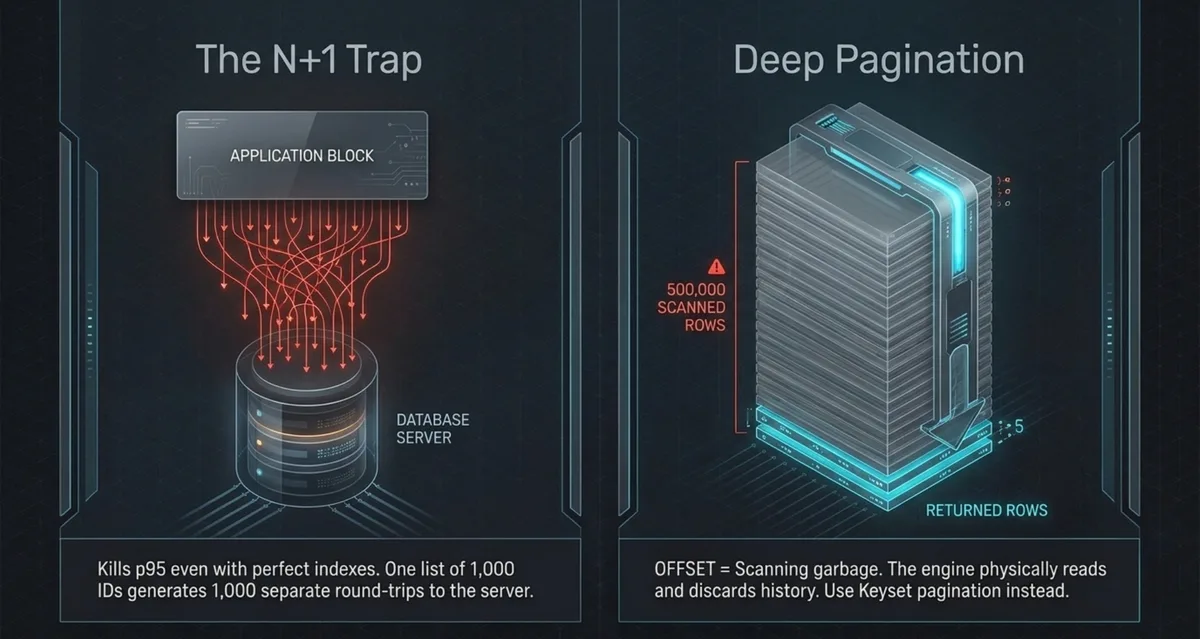
Починайте з форми результату. SELECT * на широкій таблиці тягне зайві сторінки й заважає покривальному індексу. Фільтруйте якомога раніше: у WHERE і в підзапитах, які відсікають сутності до з'єднань. Корельовані підзапити часто перетворюються на Nested Loop по мільйонах рядків. Порівняйте з JOIN, EXISTS або напівз'єднанням на реальному плані, а не за смаком. IN зі списком констант і IN з підзапитом є різними звірами для оптимізатора.
N+1 в ORM на великих колекціях убиває p95 навіть за ідеальних індексів: один список із тисячі id породжує тисячу кіл до сервера. Агрегації й сортування дорогі, якщо сортований набір не вміщується в пам'ять, тож стежте за вивантаженням на диск. CTE в різних рушіях поводяться по-різному: десь це підказка оптимізації, десь матеріалізація. Тимчасова таблиця з індексом іноді дешевша за «гарний» CTE на величезному проміжному результаті. Неявні перетворення (WHERE indexed_col = @nvarchar за int у колонці) мовчки знімають індекс. У SQL Server окремо перевіряйте підстановку параметрів (parameter sniffing): план, добрий для рідкісного параметра, нищить частий. Пагінація через великий OFFSET змушує рушій пройти й відкинути мільйони рядків, а keyset-пагінація / позиціювання за останнім ключем масштабується інакше. Функції на індексованому стовпці (WHERE YEAR(date) = 2024) зазвичай забороняють індексний пошук: винесіть обчислення на константу або використайте індекс за виразом, якщо рушій дозволяє. Масові операції «виправити все однією транзакцією» ламають журнал і блокування, а пакети з контрольованим розміром передбачувані.
Поганий начерк і напрям поліпшення:
-- було: функція на колонці, SELECT *, фільтр статусу після широкого читання
SELECT *
FROM movements m
JOIN entities e ON e.id = m.entity_id
WHERE YEAR(m.created_at) = 2024
  AND e.status = 'active';

-- стало: діапазон дат, вузька проєкція; статус — через селективний шлях
SELECT m.id, m.entity_id, m.amount, m.created_at
FROM movements m
JOIN entities e ON e.id = m.entity_id
WHERE m.created_at >= TIMESTAMP '2024-01-01'
  AND m.created_at <  TIMESTAMP '2025-01-01'
  AND e.status = 'active';
Пагінація «углиб» списку:
-- дорого на великих таблицях: рушій читає і відкидає offset рядків
SELECT id, title FROM tickets
ORDER BY id
OFFSET 500000 LIMIT 50;

-- keyset: продовжити після останнього ключа попередньої сторінки
SELECT id, title FROM tickets
WHERE id > :last_id
ORDER BY id
LIMIT 50;
EXISTS проти агрегувального DISTINCT на великих сторонах часто виграє, коли потрібна лише перевірка наявності. Порівнюйте плани на прод-подібному обсязі: стенд із тисячі рядків бреше і щодо вибору Join, і щодо пам'яті. Економіка структур даних за такими виборами розібрана в статті про структури даних як інвестиції. Короткий розбір шести тактик є в адаптації про стратегії оптимізації БД.
Індекси: від базових до випадків, коли вони не допомагають
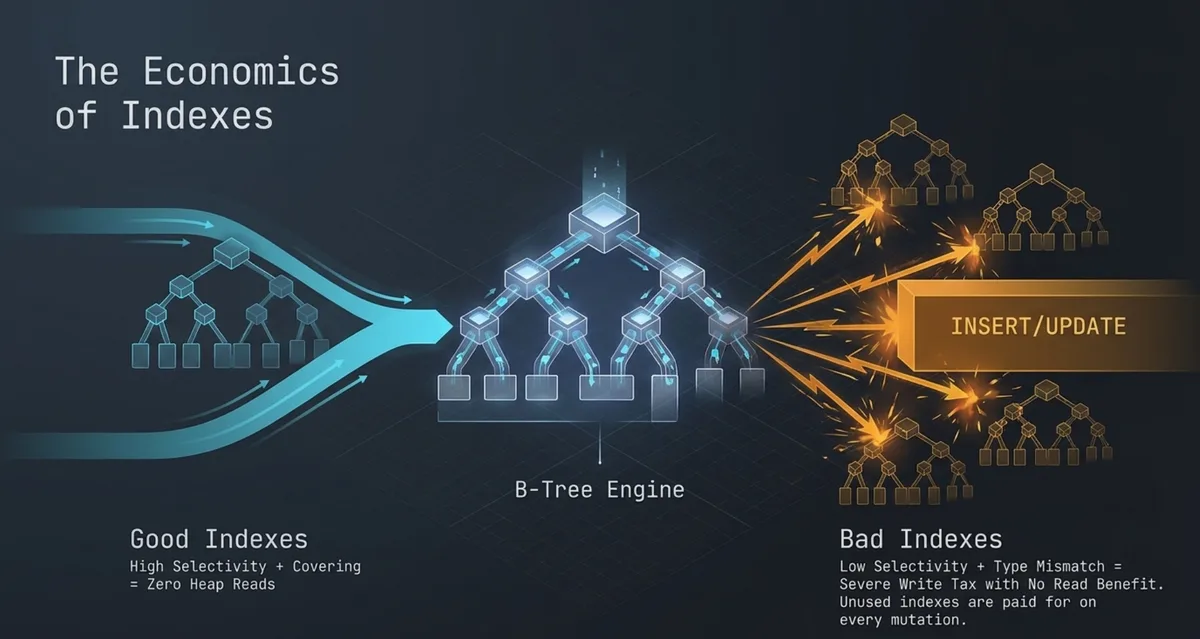
B-tree залишається робочою конякою OLTP. Кластерний / первинний індекс визначає порядок рядків у SQL Server та InnoDB (кластер за первинним ключем). У PostgreSQL купа (heap) і вторинні індекси влаштовані інакше, тому не переносьте звички один до одного. Складений індекс працює зліва направо: (status, created_at) допоможе фільтру за status і діапазону дат, але майже не допоможе самому created_at. Покривальний індекс (INCLUDE у SQL Server / PostgreSQL) прибирає повторне читання рядка з купи, якщо всі потрібні стовпці вже в індексі. Часткові й фільтровані індекси вигідні, коли гарячий зріз малий («лише відкриті», «лише активні»). Індекси за виразами та обчислювані стовпці рятують від функцій у WHERE. Для JSON і повнотекстового пошуку потрібні окремі механізми, а не «ще один B-tree на весь текст». У PostgreSQL на величезних таблицях, упорядкованих за часом, BRIN дає дешеву метаінформацію про діапазони блоків за умови фізичної кореляції. У SQL Server columnstore доречний для аналітичних сканів, а не як заміна вузькому пошуку в OLTP.
Селективність і свіжа статистика вирішують, чи візьме оптимізатор індекс. Надлишкові й невикористовувані індекси все одно оплачуються під час INSERT/UPDATE/DELETE. Фрагментація й перебудова належать до обслуговування, а не є першою кнопкою за повільного SELECT. Спершу план.
Індекс «не допомагає», коли селективність низька (статус із двома значеннями на половину таблиці), порядок стовпців не збігся із запитом, статистика застаріла, тип порівнюється через перетворення, запит повертає надто велику частку таблиці або оптимізатор обрав інший план через параметри. Тоді «додати індекс» без розбору є лотереєю з податком на запис.
Схема даних і особливий випадок EAV в ERP
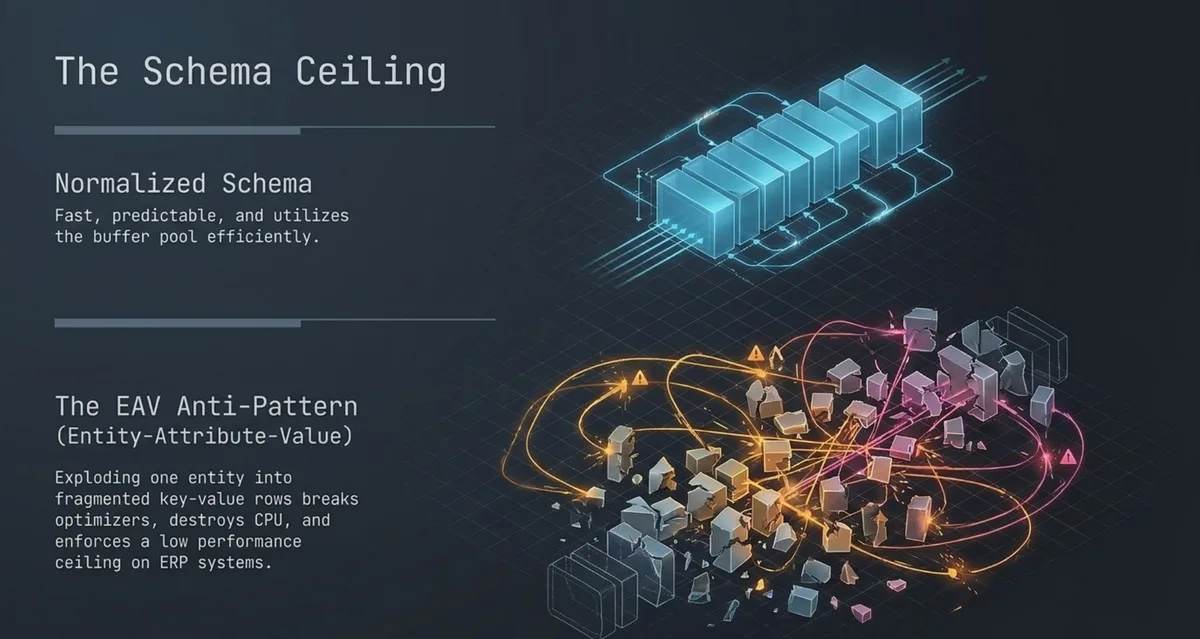
Нормалізація прибирає аномалії оновлення. Контрольована денормалізація купує дешеве читання ціною узгодженості під час запису. Вузькі типи й відмова від «про всяк випадок nvarchar(max)» зменшують рядки та підвищують щільність сторінок. Сурогатні ключі зручні для з'єднань. Природні іноді кращі для партиціонування за змістом, якщо стабільні. Зовнішні ключі на мільярдах рядків коштують перевірок під час запису, тож усвідомлюйте ціну. Широка «картка на сто колонок» б'є по буферному пулу, а вертикальне розділення холодних атрибутів зменшує гарячий рядок. Архів історії й матеріалізовані агрегати часто дешевші за нескінченне нарощування індексів на OLTP.
EAV (сутність–атрибут–значення) роздувається до мільярдів рядків, бо кожне поле картки є окремим записом. Фільтр «колір = X і вага > Y» перетворюється на кілька з'єднань або групувань по одній таблиці значень. Індекс виду (entity_id, attribute_id, value) допомагає точковому читанню атрибута, але погано закриває аналітику по багатьох атрибутах одразу. Типізовані таблиці значень (окремо числа, рядки, дати) поліпшують порівняння й статистику. Часто вживані атрибути виносять у звичайні колонки або у вузьку таблицю «гарячих полів». Кеш картки, попередні агрегати й поступова міграція без одномоментного «великого вибуху» є робочими шляхами. Одномоментна переробка ядра ERP зазвичай дорожча за рік деградації. Деталі механіки та меж застосування є в розборі EAV, а рамка платформи в проєктуванні сучасної ERP.
Партиціонування й таблиці на мільярдах рядків
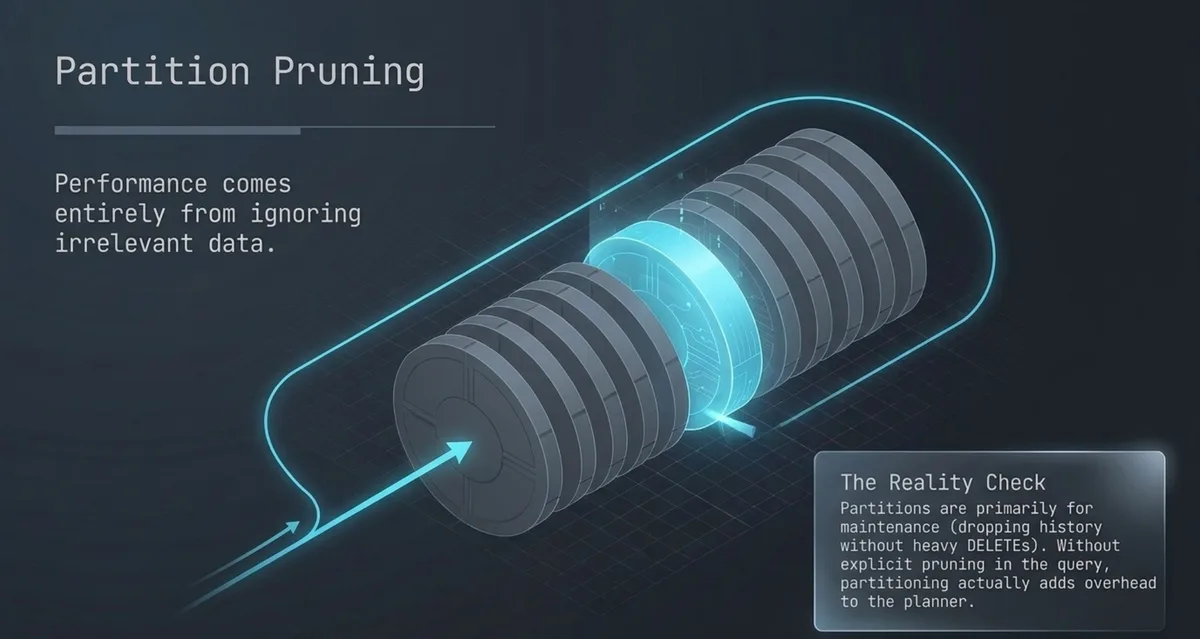
Горизонтальне розбиття ріже рядки (часто за часом або діапазоном ключа), вертикальне ріже стовпці. Списки й хеш використовують, коли діапазон за часом не підходить. Відсікання партицій (partition pruning) спрацьовує, коли предикат явно обмежує ключ партиції. Функція на ключі або параметр, «невидимий» для відсікання, знову читає все. Локальні й глобальні індекси влаштовані по-різному в SQL Server, PostgreSQL і MySQL, тож звіряйтеся з документацією рушія, а не із загальним слайдом. Партиції, що старіють, від'єднують і архівують без важкого DELETE рядок за рядком. Партиціонування прискорює супровід і деякі діапазонні запити. Воно не лікує погану селективність усередині партиції й додає накладних витрат планувальнику. Перебудова моноліту на партиції робиться за схемою «розширити — звузити» : нова структура поруч, довантаження історії пакетами, подвійний запис або CDC, перемикання читання, потім запису.
Масові операції, журнал і обслуговування
Масовий INSERT і пакети фіксованого розміру передбачуваніші за один INSERT на мільйон рядків в одній транзакції. Те саме для UPDATE/DELETE: короткі транзакції, контроль зростання журналу та блокувань. У PostgreSQL стежте за autovacuum і роздуттям (bloat) на гарячих таблицях. «Вакуум не встигає» проявляється роздутими таблицями й застарілими картами видимості. У SQL Server підтримуйте статистику й розумно перебудовуйте індекси за фактом фрагментації та навантаження, а не за календарем для галочки. У MySQL стежте за актуальністю статистики та обирайте стратегії OPTIMIZE і онлайн-зміни схеми залежно від версії. Політика зберігання: видаляйте або від'єднуйте застаріле за політикою продукту. Онлайн-зміна схеми знижує простій, але все одно навантажує I/O та реплікацію, тож плануйте вікно й відкат.
Транзакції, блокування й конкуренція
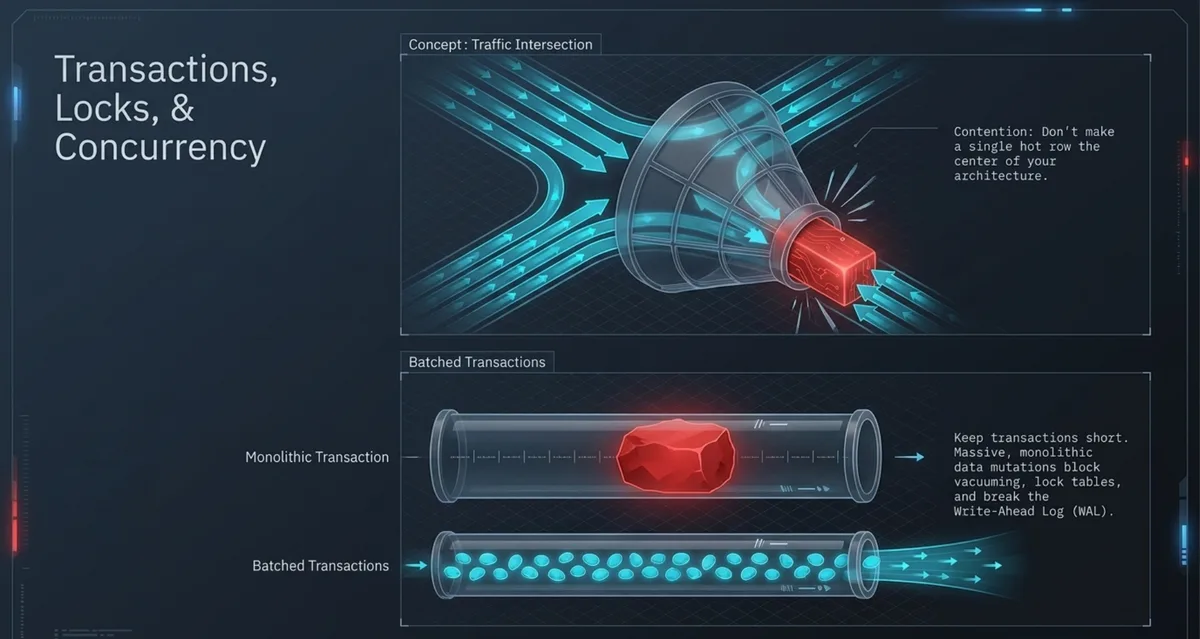
Рівні ізоляції та MVCC по-різному платять за узгодженість: хтось блокує читачів, хтось роздуває версії рядків. Довга транзакція тримає замки й заважає vacuum / очищенню. Дедлоки часто лікуються стабільним порядком захоплення ресурсів, а не «повтором навмання» без ліміту. Оптимістична конкуренція добре працює, коли конфлікти рідкісні, а песимістична, коли зіткнення постійні. Гарячий рядок лічильника або «одна черга в таблиці» впирається в сторінку: іноді допомагає пакетна видача номерів або черга поза рядком. Розділення читання й запису (репліка, CQRS) знижує конфлікт, якщо бізнес допускає затримку читання. Якщо запит поодинці швидкий, а під навантаженням ні, дивіться на очікування й блокування, а не лише на CPU плану.
Пам'ять, диски й конфігурація сервера
Буферний пул / shared_buffers мають закривати гарячий робочий набір. Інакше ви лікуєте SQL, а страждаєте від фізичного читання. NVMe добре знімає випадковий I/O, але не виправляє повне сканування історії щоразу. TempDB і тимчасові файли є дзеркалом важких сортувань і хешів. Паралелізм запитів прискорює одних і душить інших за перевантаження CPU. Пул з'єднань без стелі перетворює базу на чергу, а надто вузький пул на відмови застосунку. Checkpoint, WAL і журнали налаштовують під профіль запису, а не «як у блозі для іншої СУБД». NUMA важлива на великих багатосокетних машинах, коли пам'ять і процесори «не поруч». Правило: не копіюйте цифри налаштувань між PostgreSQL, SQL Server і MySQL та не піднімайте ліміти пам'яті навмання, бо це може збільшити тиск і дати регрес.
Відрізнити нестачу ресурсів від поганого SQL просто, коли міряєте. Високий CPU за малої кількості логічних читань натякає на обчислення й погані плани. Величезні читання за простою CPU вказують на I/O та селективність. Очікування блокувань вказують на транзакції.
Кешування та попередні обчислення
Кеш у застосунку та Redis рятують повторні читання гарячих карток і довідників. Кеш результату запиту потребує явної політики інвалідації. Інакше ви виправляєте швидкість ціною тихих розсинхронів. Матеріалізовані подання й таблиці агрегатів переносять вартість із моменту читання звіту на момент оновлення. CQRS розділяє модель запису й модель читання, коли звіти пожирають OLTP. Мета одна: не рахувати той самий важкий звіт із нуля на кожен клік керівника.
Масштабування архітектури
Вертикальне масштабування виправдане, поки вузьке місце це CPU/пам'ять одного здорового контуру й ліцензії дозволяють. Репліки читання розвантажують звіти, якщо допустима затримка. Шардування за ключем розподіляє дані й біль супроводу. Без стабільного ключа доступу й без готовності до запитів між шардами ви купите простій деінде. Федерація за доменами часто розумніша за «один шард на все». Змішувати OLTP і OLAP на одному інстансі дорого: винесіть аналітику, живіть її CDC або періодичними вивантаженнями. Розподілена архітектура завчасно додає мережеві збої, узгодженість і операційну складність. Переходьте, коли виміри показують вичерпання вертикалі та локальних технік.
Ланцюжок від браузера до сховища в сучасному вебі описано в огляді шляху запиту. Тут фокус на тому, що відбувається всередині СУБД і поруч із нею.
Що важливо в різних СУБД і рушіях
| Технологія | На чому зробити акцент |
|---|---|
| PostgreSQL | MVCC, autovacuum, BRIN, декларативні партиції, pg_stat_statements |
| SQL Server | Query Store, плани, columnstore, підстановка параметрів, TempDB |
MySQL / InnoDB |
кластер за PK, буферний пул, EXPLAIN ANALYZE, онлайн-DDL |
ClickHouse |
колонки, ключ сортування, партиції, агрегати для аналітики |
MongoDB |
індекси документа, форма документа, шард-ключ, вартість агрегацій |
Переможця серед рушіїв немає: є збіг механізму з характером навантаження. Колонкове сховище погано замінює вузький OLTP. Документна модель погано замінює жорсткі регламентні з'єднання ERP, принаймні без ціни.
Практичні кейси
Запит на 40 секунд
Сценарій: звіт «відкриті позиції» раптом пішов із двох секунд на сорок. План показує Nested Loop і фактичні рядки в мільйонах за оцінки в тисячі. Оновлення статистики та переписування фільтра на діапазон дат повертають пошук за індексом. Логічні читання падають на порядок, CPU падає разом із ними. Урок: спершу кардинальність, потім новий індекс «про всяк випадок».
Таблиця на 2 млрд рядків
Оцінка: фільтри за часом становлять 90% навантаження, видалення історії блокують таблицю. Партиції за місяцем, індекс усередині партиції під гарячий фільтр, від'єднання старих місяців замість DELETE. Запити за поточний квартал перестають чіпати холодне.
ERP з EAV
Картка з двадцятьма атрибутами збирається десятьма з'єднаннями. Винесення п'яти найчастіших атрибутів у вузьку таблицю та кеш картки на читання знімають пік. Повна міграція з EAV відкладається й робиться за схемою «розширити — звузити». Без цього індекси на value дають локальні перемоги та глобальний податок на запис.
Після індексу стало гірше
Додали складений індекс під рідкісний звіт. OLTP-вставка в ту саму таблицю подовшала, змінився план частого UPDATE, зросли блокування. Індекс залишили на репліці звітності / копії на columnstore, з OLTP зняли. Локально правильне рішення без ціни запису ламає систему.
Міграція й реорганізація без зупинки
Схема «розширити — звузити»: додайте нове поруч зі старим, пишіть в обидва або наздоганяйте CDC, читайте поступово з нового, приберіть старе. Індекси створюйте онлайн-засобами рушія у вікні з контролем I/O. Довантаження історії робіть пакетами з тротлінгом. Перевіряйте повноту звіркою контрольних сум і вибірок, а не «очима». План відкату готуйте до перемикання запису. На продуктивній системі важлива не швидкість викладки, а швидкість, з якою ви можете зупинитися.
Типові помилки та чек-лист
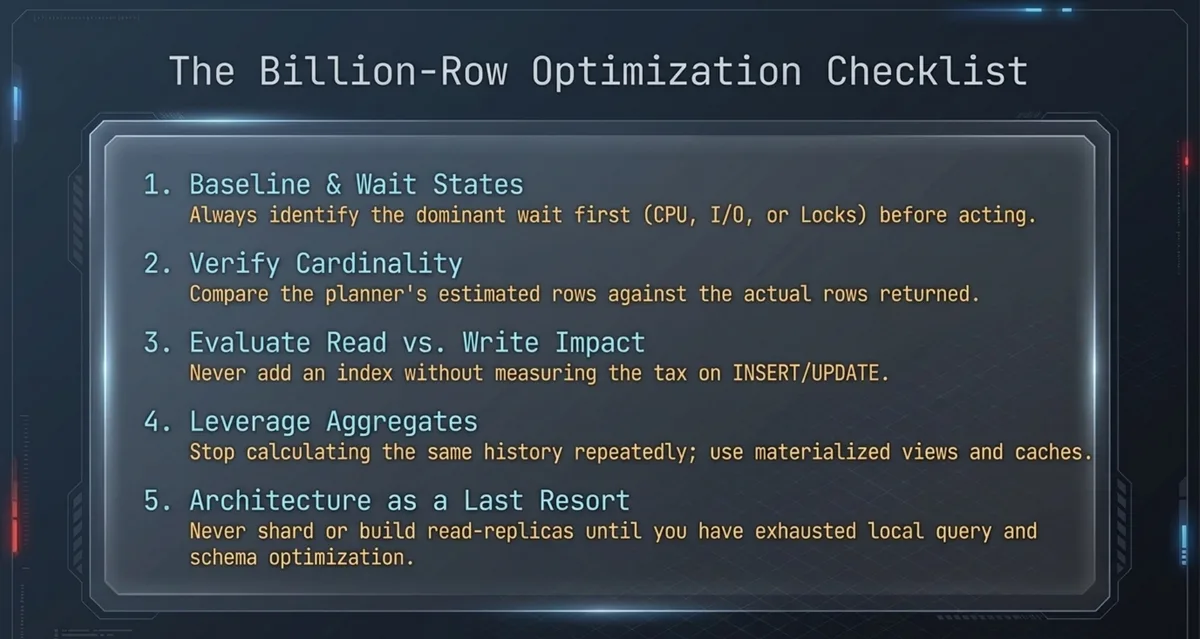
Часті промахи: індекси без плану; віра, що партиції прискорять будь-який SELECT; пам'ять «із запасом» без профілю очікувань; переписування SQL без відтворюваного тесту; видалення «рідкісних» індексів, які тримають місячний закривальний звіт; одна транзакція на мільйони рядків; шарди до прибирання локального хаосу; бенчмарк на іграшковому обсязі; ігнорування вартості запису.
Чек-лист одного проходу:
- Зафіксувати базові метрики й проблемні запити.
- Назвати головне очікування: CPU, I/O, блокування, пам'ять.
- Зняти плани й звірити оцінки кардинальності.
- Перевірити статистику, індекси, селективність.
- Оцінити вплив на читання й запис.
- Перевірити поведінку під конкуренцією.
- Розглянути партиції й архів.
- Розглянути кеш і агрегати.
- Лише потім архітектурне винесення й шарди.
- Повторити тест і записати результат.
Матриця застосовності методів
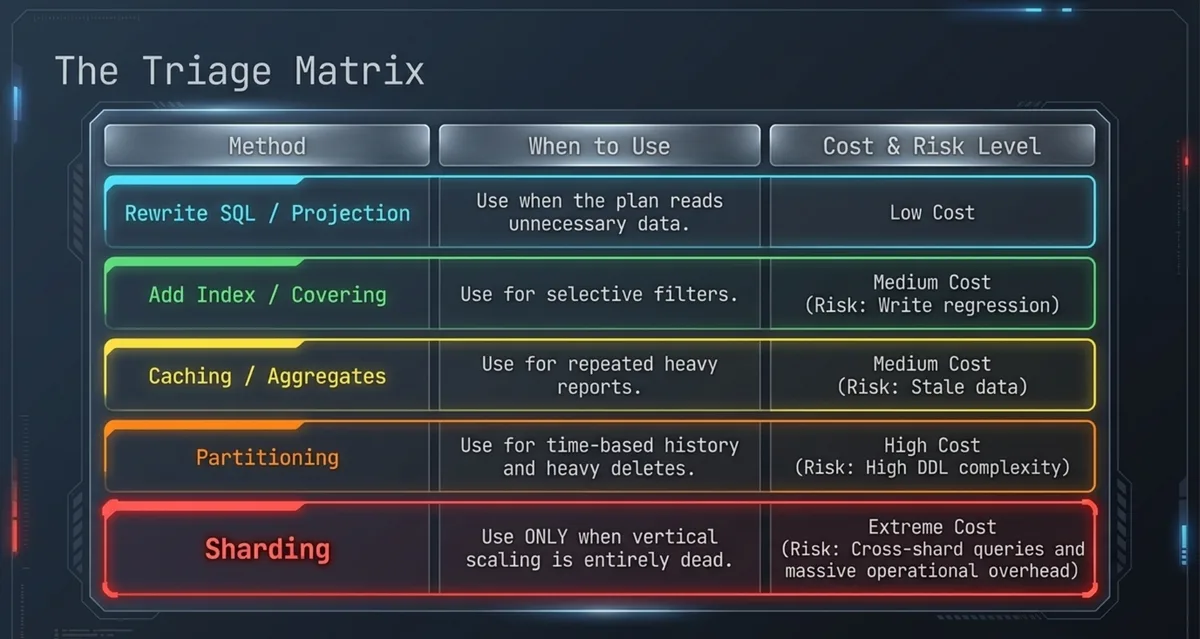
| Метод | Коли допомагає | Обмеження | Вартість упровадження | Ризик для проду |
|---|---|---|---|---|
| Переписати SQL / проєкцію | План читає зайве, є явний антипатерн | Не лікує модель EAV і архів | Низька | Низький за тесту на копії |
| Індекс / покриття | Селективний фільтр, повторюваний шлях | Податок на запис, дублі | Низька–середня | Середній (регрес запису) |
| Статистика / підстановка параметрів | Оцінка рядків бреше, нестабільний план | Не заміна схемі | Низька | Низький |
| Партиції + зберігання історії | Історія за часом, важкий DELETE |
Потрібне відсікання, складність DDL | Висока | Високий без поетапності |
| Кеш / агрегати | Повторні звіти й картки | Інвалідація, свіжість | Середня | Середній (застарілі дані) |
| Репліка / CQRS / склад | Звіти душать OLTP | Лаг, два контури | Висока | Середній–високий |
| Шард | Вертикаль вичерпана, є ключ доступу | Запити між шардами, операції | Дуже висока | Високий |
Читайте матрицю згори вниз: поки рядок вище не вичерпаний за вимірами, стрибати вниз зарано. Виняток: коли вже доведено, що звіти систематично б'ють по запису. Тоді винесення читання можна планувати паралельно з локальним тюнінгом, а не замість нього.
Часті питання
З якого розміру таблиці вже потрібна «серйозна» оптимізація?
Коротка відповідь: з моменту, коли p95 або супровід перестають вкладатися в бюджет, а не з круглої цифри рядків.
Десять мільйонів рядків із поганим планом болять сильніше за охайний мільярд. Дивіться на робочий набір, селективність і конкуренцію.
Індекс не використовується: додавати ще один?
Коротка відповідь: ні, спершу запитайте план і предикат.
Часто заважають перетворення типів, порядок стовпців, низька селективність або застаріла статистика. Другий індекс без причини подвоює податок на запис.
Партиціонування прискорить усі запити?
Коротка відповідь: ні.
Прискорюються ті, що відсікають партиції, та операції обслуговування. Запит без предиката за ключем партиції може стати повільнішим.
Коли виносити звіти з OLTP?
Коротка відповідь: коли важкі скани історії регулярно конкурують із записом і не лікуються агрегатами на місці.
Репліка або склад із CDC дають запас, якщо допустима затримка даних звіту.
EAV можна залишити, якщо «добре проіндексувати»?
Коротка відповідь: для ядра обліку зазвичай ні.
Індекси знімають частину точкових читань, але не скасовують з'єднання, типізацію та звітність. Периферійні рідкісні атрибути це інша розмова.
Чи варто копіювати налаштування shared_buffers / max server memory з іншого проєкту?
Коротка відповідь: ні.
Профіль даних, частка запису й супутні сервіси на машині інші. Копіювання цифр без робочого набору є частим джерелом регресу.
Що почитати далі
Суміжні матеріали на сайті:
Висновок
У великої бази немає однієї кнопки «стало швидко». Є цикл: виміряти, знайти клас очікування, змінити запит, індекс, схему чи контур даних, перевірити читання й запис під навантаженням, закріпити моніторингом. Іноді вистачає індексу та чесної статистики. Іноді потрібні архів і партиції. Іноді треба винести звітність і перестати будувати ядро на EAV. Обирайте за вимірами, а не за модою на технології. Цього тижня достатньо одного кроку: взяти найповільніший запит із топу, зняти план із буферами або фактичний план і записати, чого він насправді чекає.
Коментарі