

Содержание
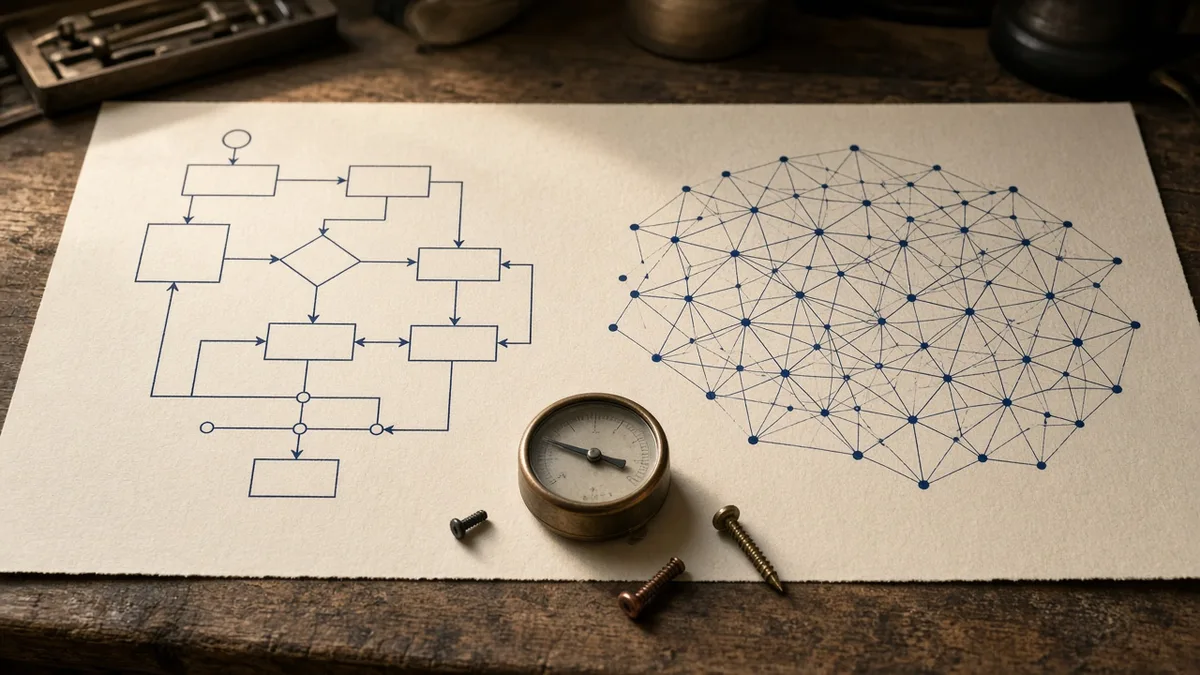
На стене мастерской висит лист с процедурой. Чтобы проверить, простое ли число, делите его на кандидатов вплоть до квадратного корня. Кто умеет читать лист, получит тот же ответ на том же числе. Рядом рабочий стол. На нём рамка, стопка листов с рукописными цифрами и калибр. Рамку можно подкручивать винтами. Калибр показывает, насколько текущая настройка промахивается мимо подписи на листе. Винты крутят, пока стрелка не уйдёт вниз.
Две задачи ставят рядом чаще, чем кажется. Написать функцию, которая говорит, простое ли число. Собрать систему, которая узнаёт рукописную цифру, хотя никто не перечислил все способы написать семёрку. В обоих случаях на выходе вычислительная система. Различается способ, которым у неё появляется поведение.
В первом случае поведение записано шагами. Во втором вы задаёте рамку возможных вычислений, примеры, критерий ошибки и процедуру, которая подбирает числовые параметры. Обучение при этом не отменяет программирование и не производит отдельный разум. Оно меняет объект работы: рядом с текстом программы появляется процесс, который формирует параметры и вместе с ними способности системы.
Лист на стене и стол с калибром ниже будут означать одно и то же. Лист держит явно заданный алгоритм. Стол держит архитектуру, данные и критерий, по которому подбираются параметры. Положение винтов держит сохранённое состояние обученной модели.
Ключевые выводы
Обученная модель остаётся вычислительной системой внутри программы. Её поведение складывается из архитектуры, данных, критерия ошибки и подобранных параметров. Исходный код при этом часто не меняется.
Фраза «программа следует правилам, модель учится» слишком грубая. Программа может содержать обучаемый кусок. Модель исполняется программным кодом. Сравнивать стоит два способа собрать поведение. Взаимоисключающими видами объектов они не становятся.
Обобщение проверяют на новых примерах. Точность на отложенной выборке говорит, как система вела себя на этих данных. Доказательством правильности на каждый будущий случай она не становится.
Веса не читаются как энциклопедия и не заменяют цитируемый документ. Параметры участвуют в преобразовании входа. Конкретный факт из них достаётся ненадёжно. Там, где нужны версия стандарта и ссылка на пункт, рядом с моделью стоят поиск по источникам и обычные проверки в коде.
Разработчик никуда не девается. Он выбирает задачу и границу, после которой результат нельзя выпускать. Данные, архитектура и метрика входят в ту же работу. Для задач с известным математическим решением явный алгоритм обычно честнее, дешевле и спокойнее модели.
Простое число пишут на листе, рукописную цифру подгоняют на столе
Простое число больше единицы и не делится ни на что, кроме единицы и себя. Это определение уже содержит алгоритм. Для небольшого n достаточно проверить делители от двойки до корня из n.
def is_prime(n: int) -> bool:
    if n < 2:
        return False
    d = 2
    while d * d <= n:
        if n % d == 0:
            return False
        d += 1
    return True
При одинаковых входных данных и том же окружении функция ведёт себя предсказуемо. Ошибки здесь обычные для программы: неверное условие, целочисленное переполнение, забытый случай n < 2. Их ищут тестом на известных простых и составных числах. Для этой задачи тест может быть исчерпывающим на нужном диапазоне, потому что правило полно.
Рукописная цифра устроена иначе. Семёрка бывает с перекладиной и без, жирная и тонкая, наклонная, с пятном от ручки. Контур, изгиб и пропорция быстро плодят исключения. Набор правил «если вертикальный штрих и верхняя полка, то это единица или семёрка» ломается на следующем почерке. Лист на стене разрастается, а каждый новый автор почерка приносит случай, которого на листе не было.
На столе работают иначе. Берут изображение и правильную метку. Модель по текущим параметрам выдаёт предположение. Считают, насколько оно расходится с меткой. Параметры сдвигают так, чтобы расхождение на этой порции примеров уменьшилось. Потом проверяют изображения, которых в обучении не было. Классический учебный набор рукописных цифр устроен именно так: картинка и цифра-ответ. Списка всех допустимых росчерков там нет.
Один шаг удобно увидеть на конкретной семёрке. Картинка попадает в сеть. На выходе десять чисел, по одному на каждую цифру. Допустим, на семёрку пришлось мало, а на единицу много: модель сейчас читает палочку и игнорирует перекладину. Функция потерь, часто это перекрёстная энтропия, даёт большой штраф, потому что правильная метка получила маленькую долю. Обратный проход показывает, какие параметры сильнее всего тянули ответ к единице. Шаг оптимизации чуть сдвигает именно их. Следующая похожая семёрка уже имеет шанс получить большую долю. Это всё ещё оптимизация штрафа на примерах. Знание «как люди пишут семёрку» в файл само не записывается отдельной строкой.
Обобщение здесь главное свойство, и его легко переоценить. Новые примеры могут отличаться от учебных. Хороший результат на отложенной выборке означает, что на этих листах система чаще попадает в метку. Он не доказывает, что следующая семёрка, написанная на мокрой бумаге другим человеком, тоже будет прочитана. Вводный курс Google по машинному обучению прямо разделяет ошибку на учебных данных и ошибку на данных, которые в подбор параметров не входили. Второе и есть практическая проверка обобщения. Сертификатом универсальной правильности она не становится.
Человек из этой работы не выпадает. Он выбирает задачу и архитектуру. Примеры, метрика и разбор ошибок остаются на нём. С листа, где перечислены все случаи, работа переезжает к проектированию процесса, который эти случаи должен переварить.
Одинаковый код, разное поведение
Программой в узком смысле удобно называть текст, где логика задана явно. Инструкции, условия, состояния, обработка ошибок. Разработчик решает, что система сделает на каждом предусмотренном входе. При фиксированных данных и окружении результат часто повторяется. Исключения есть и у программ: эвристика, случайность, конфигурация, которая меняется без новой сборки, код, который переписывает собственное состояние. Предсказуемость часто сопровождает явный алгоритм. Законом природы она не становится.
Модель в том смысле, о котором здесь речь, это обученная вычислительная структура. У неё четыре рабочих части, и их нельзя склеивать в одно слово.
Архитектура задаёт, какие операции система вообще умеет выполнять. Сколько слоёв, какие связи, какой размер входа, какая форма ответа. Пустая рамка на столе ещё не узнаёт цифры. Она только ограничивает, какого рода вычисления внутри неё возможны.
Параметры, их чаще называют весами, образуют числовое состояние. Они влияют на то, как вход превращается в выход. Одинаковая рамка с разными положениями винтов даёт разные ответы. Файл весов хранит это состояние. Сам по себе файл ничего не исполняет: без кода архитектуры, формата входа и процедуры вывода это набор чисел.
Данные и функция потерь отвечают на вопрос, чему система подстраивается и по какому критерию. Для цифры критерий обычно штрафует неверную метку. Для другой задачи критерий будет другим. Алгоритм оптимизации говорит, как именно двигать параметры, чтобы штраф на учебных примерах уменьшался. Для слоистых сетей градиент по параметрам считают обратным проходом. Имя процедуры здесь важнее метафоры. Идёт оптимизация выбранного критерия. Знания отдельной строкой от этого не появляются.
Отдельно стоит работающее приложение. В нём модель занимает один узел. Вокруг очередь запросов, проверка входа, журналы и запасной путь, если модель молчит или отвечает вне допустимого диапазона. Путать файл весов с этим приложением всё равно что принять чертёж рамки за станок, который уже стоит в цехе.
Поэтому сравнение «программа следует правилам, модель учится» рассыпается на первом же гибриде. В коде сидит обучаемый блок. Модель вызывается из обычной функции. Рядом база, набор правил и инструмент, который модель может попросить выполнить. В разборе уровней адаптации языковых моделей это видно на лестнице: предобучение меняет параметры, поиск по документам подставляет источник на время ответа, а вызов внешнего интерфейса вообще живёт в программе вокруг модели. Сравнивать имеет смысл способы собрать поведение. Объекты в промышленной системе почти всегда сидят в одном стеке.
Обучение крутит винты, а не переписывает лист
После обучения исходный текст часто тот же. Меняется параметрическое состояние. Та же архитектура на тех же входных данных начинает отвечать иначе, потому что числа в преобразовании другие. Это состояние можно сохранить, загрузить и гонять снова. Повторный запуск с тем же файлом и тем же кодом должен дать тот же ответ на том же входе, если в процедуре вывода нет случайности. Если ответ поехал, ищут расхождение версии кода и весов. Рядом смотрят предобработку и оборудование. Настроение модели тут ни при чём.
Три карточки помогают не смешивать уровни. Первая карточка, архитектура: описание рамки и правил вычисления, обычно код. Вторая, веса: снимок настроек после обучения. Третья, работающий экземпляр: этот снимок исполняется на конкретной машине, с конкретным форматом входа и конкретной процедурой вывода. Документация PyTorch проводит ту же границу между определением модуля, его параметрами и вызовом модуля на данных. Пока нет третьей карточки, слово «модель» ещё не означает систему, которая принимает запросы.
Одинаковая архитектура с разными весами даёт разные способности. Одна настройка читает цифры. Другая, в той же рамке, но после других данных и другого критерия, может делать соседнюю задачу или не делать никакой. Отсюда практическое следствие для выпуска. Версия поведения складывается из кода архитектуры, файла параметров и подготовки входа. Номера коммита для этого мало.
Подготовка входа ломает пару тише, чем люди ждут. При обучении картинку привели к одному размеру, вычли среднее и положили каналы в одном порядке. При вызове кто-то забыл вычитание или переставил каналы. Архитектура та же, файл весов тот же, ответы уже чужие. Искать «порчу модели» в этом месте бесполезно. Сверяют цепочку до первого числа, которое попадает в сеть. То же с текстом языковой модели: другой разбор на куски и другой специальный знак в начале запроса меняют вход, хотя файл параметров не трогали.
Лист на стене при этом никуда не делся. Код обучения, цикл по примерам, сохранение файла и загрузка перед запросом остаются программой. Обучение не заменяет лист. Оно дописывает к листу протокол, по которому стол подбирает винты.
Цикл инженера сдвигается с правки текста на правку процесса
Классический цикл на листе короткий и знакомый. Собрать требования. Спроектировать алгоритм. Реализовать. Проверить известные случаи. Исправить текст, если случай разошёлся с правилом. Для простого числа этот цикл честный: вы меняете условие, и поведение меняется ровно там, где вы его записали.
Цикл на столе длиннее, и правка редко начинается с той строки, которая «ошиблась». Сначала формулируют задачу и метрику. Потом готовят данные и отделяют кусок, на котором параметры подбирать нельзя. Выбирают архитектуру и функцию потерь. Считают предсказание, ошибку и шаг обновления параметров. Смотрят отложенную выборку. В конце проверяют независимый набор, который не участвовал в решениях по ходу обучения. Если на учебном наборе стрелка калибра ушла вниз, а на новых листах поднялась, это переобучение: настройка запомнила учебные листы вместо закономерности, которая переносится.
Инженер здесь задаёт ограничения, критерий качества и механизм подбора. Алгоритм ищет параметры внутри этих рамок. В найденной настройке могут сидеть закономерности, которые человек не выписывал по одной. Это не значит, что результат возник без проекта. Рамка, выборка, штраф за ошибку и правило остановки остаются решениями человека. Удачная настройка не отменяет эти решения. Она их исполняет.
Что при этом приобретают и что теряют, лучше сказать прямо. Приобретают задачи, где ручной перечень правил разваливается. Почерк и шумная картинка. Рядом речь и черновик формулировки по корпусу текстов. Теряют прямой обзор каждого внутреннего шага и привычную уверенность, что ошибочный ответ можно ткнуть пальцем в одну строку условия. Взамен появляются другие обязанности. Данные надо собирать и проверять. Ошибки надо смотреть распределением, а не одним контрпримером. Поведение надо воспроизводить: те же данные, тот же код, тот же порядок, если результат должен повториться. После выпуска надо замечать, что вход уехал относительно учебной выборки. Это и есть дрейф: мир в запросах стал другим, а винты остались на старой настройке.
Метрика, которой вы верите на столе, отдельная работа, не хвост обучения. Как выбирать показатели для классификации, зрения, распознавания текста и языковых моделей, разобрано в материале про метрики качества нейросетей. Без этой развилки цикл на столе оптимизирует не ту стрелку.
Повторить настройку тоже надо уметь, иначе слова «та же модель» и то, что стоит в цехе, расходятся. Хранят снимок данных и код обучения. Рядом лежит файл параметров и описание того, как вход готовили к сети. Если хотя бы одно из этого поехало, стрелка калибра на новых листах уже про другую систему. Для простого числа такого комплекта нет. Хватает текста функции и теста на диапазоне. Для рукописной цифры комплект и есть изделие.
Сравнение, которое не стоит принимать за стену
Таблица ниже описывает типичные случаи. Законом её считать не стоит. Эвристическая программа, вероятностный алгоритм, правила с обучаемым куском и сеть внутри жёсткого конвейера сидят между колонками. Читайте строки как ориентир, куда смотреть сначала.
| Критерий | Явный алгоритм | Обученная модель |
|---|---|---|
| Откуда берётся поведение | В основном из текста и правил | Из архитектуры, данных, процедуры обучения и параметров |
| Как меняют поведение | Правят код, конфигурацию или вход | Меняют параметры, архитектуру, контекст или обвязку |
| Новые случаи | Идёт по записанному алгоритму | Опирается на найденные закономерности, если они переносятся |
| Как проверяют | Тесты и, где возможно, доказательство ограниченного свойства | Статистическая оценка и проверка сценариев |
| Типичный сбой | Ошибка реализации, неверное условие, неверная предпосылка | Плохие данные, перекос выборки, слабое обобщение, неверный ответ |
| Зависимость от данных | Бывает малой | Часто решает исход |
| Как выпускают новую версию | Новый текст или конфигурация | Новый файл параметров, дообучение или другая архитектура |
| Насколько видно устройство | Зависит от того, как написан текст | Часто трудно: вклад размазан по параметрам |
После таблицы полезно вернуться к простому числу и к цифре. Проверка простоты хорошо ложится в левую колонку: источник логики в определении, новые числа обрабатываются тем же правилом, ошибку можно локализовать. Чтение почерка хорошо ложится в правую: источник в примерах и подборе, новый почерк не гарантирован, ошибку видно на выборке. В одной строке её не найти. Промышленная система чаще занимает обе колонки сразу. Модель предлагает чтение цифры, а код рядом запрещает значение вне допустимого диапазона прибора.
Четыре полки, и ни одна из них не сознание
Слово «сущность» в разговоре о моделях прыгает между смыслами. Иногда имеют в виду объект, который можно назвать, сохранить и отличить от другого объекта. Иногда имеют в виду систему, которая выполняет класс задач. Иногда имеют в виду агента, который действует в среде. Иногда имеют в виду существо с субъективным опытом. Переход с полки на полку не происходит сам. Сохранённый файл не становится агентом от того, что файл большой. Агент не становится носителем опыта от того, что у него есть цикл действий.
У модели в инженерном разговоре четыре полки, и их лучше держать раздельно.
На первой полке описание: архитектура, код обучения, выбранный критерий. Это ещё рецепт, не экземпляр.
На второй полке лежит сохранённое состояние: параметры после обучения. Их можно положить в хранилище, посчитать контрольную сумму, откатить.
На третьей полке работающая модель. Параметры исполняются на оборудовании и обрабатывают запросы. Здесь появляются задержка и стоимость вызова. Рядом отказ оборудования и расхождение предобработки с тем, что было при обучении.
На четвёртой полке система или агент. Модель соединена с памятью и инструментами. Рядом план шагов и каналы, через которые система видит мир и действует. Пока этого контура нет, модель отвечает на запрос и останавливается. Агент устроен как петля. Он смотрит на результат, выбирает действие и получает новый результат. Автономность такой петли задают полномочия и запреты всей системы. Характер файла весов тут ни при чём. Как эту петлю собирают в корпоративном контуре, разобрано в статье про агентов.
Функциональная самостоятельность описывается скупо. Система принимает вход. У неё есть внутреннее состояние. Она выбирает вариант ответа или действия из нескольких. Ей доступны инструменты, и она может менять внешнее состояние. Есть обратная связь и оценка результата. Такой объект что-то делает без пошаговой указки на каждый клик. Желания и субъективный опыт из этого списка не следуют. Путать полки здесь дорого. Связный ответ не означает желание. Текст без источника нельзя класть в акт.
Веса не читаются как справочник
Информацию держат по-разному, и способ хранения задаёт, что с ней можно сделать.
Документ хранит явные утверждения. Пункт стандарта можно открыть, процитировать и сверить с номером версии. База хранит структурированные записи: единица измерения, диапазон, дата. Код задаёт операции и запреты: если давление вне диапазона, расчёт не продолжается. Параметры модели участвуют в преобразовании входа. Закономерность в них может быть размазана по многим числам. Одно понятие не обязано совпадать с одним весом или одним слоем.
Поэтому веса нельзя читать как энциклопедию. Параметры влияют друг на друга. Достать из них конкретный факт трудно и ненадёжно. Модель может повторить знакомый шаблон, смешать сведения и уверенно ошибиться. Исследования интерпретируемости показывают отдельные понятные куски в некоторых сетях и одновременно упираются в то, что распределённое представление не равно карточке в каталоге. Отсюда практический запрет. Нельзя утверждать, что в файле весов лежит точная копия учебных документов. Даже если модель пересказывает фрагмент, это не след «страница 14, абзац 2», пока вы сами не достали страницу из источника.
Усвоенная закономерность и проверенный факт расходятся. В источнике лежит утверждение. В параметрах может осесть статистический след этого утверждения и следы соседних текстов. На выходе модель порождает формулировку. Проверенным фактом формулировка становится после сверки. В момент генерации сверки ещё нет.
Для промышленной безопасности это видно на одном запросе. Допустим, система помогает читать технические нормы. Дообучение на предметных текстах может улучшить словарь и манеру ответа. Оно не заменяет пункт действующей версии документа: нормы меняются, а файл параметров обновляется отдельным, дорогим шагом. Поиск по источникам, устроенный как RAG, на время ответа подставляет фрагмент и ссылку. Обычный код проверяет единицы, диапазоны и обязательные условия. Эксперт подписывает вывод, если ошибка стоит дорого. Опора только на «знания в весах» здесь ломается ровно там, где нужны цитата, версия и прослеживаемость.
Когда дообучение уместно, а когда факты надо оставлять снаружи модели, разобрано в заметке о дообучении. Как собрать поиск по документам так, чтобы фрагмент и оценка качества были частью системы, показано в инженерном разборе RAG.
Когда лист на стене честнее стола
Классификатор простых чисел можно обучить. На примерах он часто попадёт в ответ. Чётные числа больше двойки он выучит быстро: признак грубый и в выборке частый. На нечётном составном числе, которого в учебных листах не было, он имеет право ошибиться, потому что определения у него нет. Есть только следы выборки. Функция с делителями до корня ошибается только если сломан текст. Для задачи с известным математическим решением стол с калибром выходит дорогим и менее надёжным инструментом. Лист короче, дешевле и его проще проверить.
Другая крайность выглядит как рукописный замер. В журнале лаборатории человек пишет «12,4», и система должна это прочитать. Правила про штрихи и петли держатся, пока почерк знакомый. Запятая, похожая на точку, смазанная четвёрка, цифра, заехавшая на линейку, раздувают лист исключений. Здесь уместен распознаватель, обученный на таких изображениях. Ему нужны данные именно этого почерка и этого бланка, метрика ошибки символа и отдельный учёт опасной ошибки: прочитать не то давление хуже, чем отказаться и отдать лист человеку. С чего начинается такая лаборатория для свёрточных сетей и распознавания строк, показано в первом уроке серии про CNN и CRNN.
Третий случай собирает оба инструмента. Ассистент по техническим нормам не сводится к одной модели и не сводится к одному поиску. Модель помогает сформулировать ответ человеческим языком предметной области. Поиск приносит фрагмент нужной версии. Код проверяет, что единицы сходятся и число внутри диапазона. Человек принимает решение, если от него зависит безопасность. Модель в этой сборке остаётся компонентом архитектуры. Архитектуру она не заменяет.
Отсюда и список ограничений, без которого разговор о столе с калибром превращается в рекламу. Выборка может быть непредставительной. Разметка может быть ошибочной. Настройка может запомнить учебные листы и развалиться на новых. Внутреннее устройство бывает трудно читать. Обучение и вызов стоят денег и времени. Новая версия параметров может тихо сменить поведение при том же интерфейсе. Неожиданный вход выбивает ответ, которого не было в сценариях проверки. Генеративные модели выдумывают правдоподобный текст. В критичных областях нужны наблюдение, повторные проверки и человек на решении. Если у задачи есть точное формальное правило, его и надо писать на листе.
Разработчик задаёт условия, в которых способность появляется
Сложные свойства не всегда выписывают поэлементно. Иногда инженер задаёт структуру, ограничения и процесс, а нужное поведение получается как результат этого процесса. У машинного обучения эта идея общая с другими инженерными областями и на этом сходство кончается. Обучение остаётся вычислительной процедурой с выбранным критерием. Это не биологическая эволюция и не самопроизвольное появление разума. Аналогия помогает увидеть сдвиг работы. Она не доказывает лишнего.
Удобно держать в голове три уровня, не выдавая их за историю отрасли. На первом разработчик пишет алгоритм. На втором он собирает процесс, в котором параметры подбираются по данным. На третьем модель работает вместе с памятью, инструментами, кодом и обратной связью и закрывает задачу в несколько шагов. Уровни складываются. Третий не отменяет первый: проверки диапазона по-прежнему пишет человек в обычном коде.
Роль при этом меняется в конкретных действиях. Вместо перечня всех почерков выбирают представительные листы. Вместо ручной эвристики на каждый изгиб проектируют штраф и способ его измерять. Вместо проверки одной ветки условия смотрят, на каких группах примеров ошибка растёт. Вместо выпуска только текста ведут версии данных, параметров и всего контура, включая предобработку. Главный навык в этой работе в том, чтобы поставить задачу так, чтобы было видно, какие данные её вообще могут нести. Дальше выбирают метод и смотрят, где система отказывает, прежде чем встраивать её в контур, который можно остановить.
Дальше по цеху уже видно несколько направлений, и ни одно не обещает систему, которая сама себе ставит цель. Гибриды кода, моделей и баз знаний становятся обычной сборкой. Оценку и дообучение автоматизируют там, где метрика уже согласована с человеком. Агенты вызывают инструменты в пределах выданных прав. Контур может подстраиваться под обратную связь, если обратная связь размечена и ограничена. Версия модели становится таким же артефактом выпуска, как версия кода. Автоматизация обучения и наличие собственной цели расходятся. Первое уже инженерная практика. Второе из неё не следует.
Как меняется ежедневная работа программиста, когда производство текста дешевеет, разобрано в заметке о программисте в эпоху ИИ. Как вокруг модели собирают платформу шире одного чата, показано в материале о корпоративной платформе. Как измерять такой контур так, чтобы цифре можно было верить, разобрано в материале об оценке корпоративного ИИ.
Частые вопросы
Чем обученная модель отличается от программы?
Программа в узком смысле задаёт поведение текстом правил. Обученная модель задаёт поведение архитектурой плюс параметрами, подобранными по данным и критерию ошибки. В промышленной системе модель почти всегда исполняется внутри программы. Различие в способе получить поведение. Из двух вещей ни одна не выпадает из программирования.
Что такое обученная модель, если коротко?
Это архитектура, у которой параметры уже подстроены под примеры и выбранный штраф за ошибку, плюс договорённость о формате входа и процедуре вывода. Файл весов без кода архитектуры хранит состояние. Работающей системой он не становится.
Где хранятся знания нейросети?
Явные утверждения остаются в документах и базах. Код хранит запреты и вычисления. В параметрах может осесть распределённый след закономерностей из учебных данных. Этот след нельзя открыть как страницу справочника и процитировать как источник.
Что такое веса?
Числовые параметры, которые влияют на преобразование входа в выход. Обучение их меняет. Одинаковая архитектура с другими весами может решать задачу иначе или не решать её. Веса сохраняют в файл и загружают перед вызовом.
Модель и алгоритм — это одно и то же?
Алгоритм обучения остаётся программой, которая обновляет параметры. Обученная модель получается, когда эту программу прогнали на данных. Алгоритм вывода применяет уже найденные параметры к новому входу. Слова стоят рядом и обозначают разные вещи.
Как нейросеть обучается на данных?
На примере считают ответ при текущих параметрах, сравнивают его с меткой через функцию потерь и сдвигают параметры, чтобы штраф уменьшился. Для слоистых сетей направление сдвига даёт обратный проход. Потом смотрят примеры, которые в этот сдвиг не входили.
Когда обычный алгоритм лучше модели?
Когда правило известно, полно и его можно проверить. Простота числа, единицы измерения, диапазон, обязательное поле, точная формула. Модель здесь дороже, хуже объясняется и имеет право ошибиться там, где текст правила не ошибся бы.
Модель — это уже агент?
Нет. Модель может выдать ответ на один запрос и остановиться. Агент остаётся системой с петлёй шагов, памятью и инструментами. Ей разрешено менять внешнее состояние. Агентом модель становится только в составе такой системы, и то в пределах выданных прав.
Что почитать дальше
Рядом на сайте уже есть материалы, которые продолжают отдельные полки этой статьи.
- Как обучают языковые модели: параметры, поиск по документам, инструменты
- Когда дообучение действительно нужно
- Промышленный поиск по документам
- Метрики качества нейросетей
- Лаборатория CNN и CRNN: с чего начинается распознавание
- Почему корпоративному ИИ нужны агенты
- Как оценивать корпоративный ИИ
Короткие внешние опоры, на которые стоит сверять термины: вводный курс Google по машинному обучению (функция потерь, градиентный спуск, обобщение) и документация PyTorch по модулям и параметрам.
Заключение
Программа и модель собираются в одну систему. Программа может описывать, как обучать. Модель получается, когда этот протокол прогнали на данных и сохранили параметры. В рабочем контуре они почти всегда лежат вместе: лист процедуры, рамка, винты, калибр и человек, который решает, можно ли ставить эту настройку в цех.
Раньше мы в основном писали машине, как решать задачу. Теперь можем спроектировать процесс, который вытаскивает способ решения из примеров. Следующая инженерная работа в том, чтобы сделать такие системы проверяемыми, управляемыми и достаточно спокойными для конкретного участка.
Комментарии