

Зміст
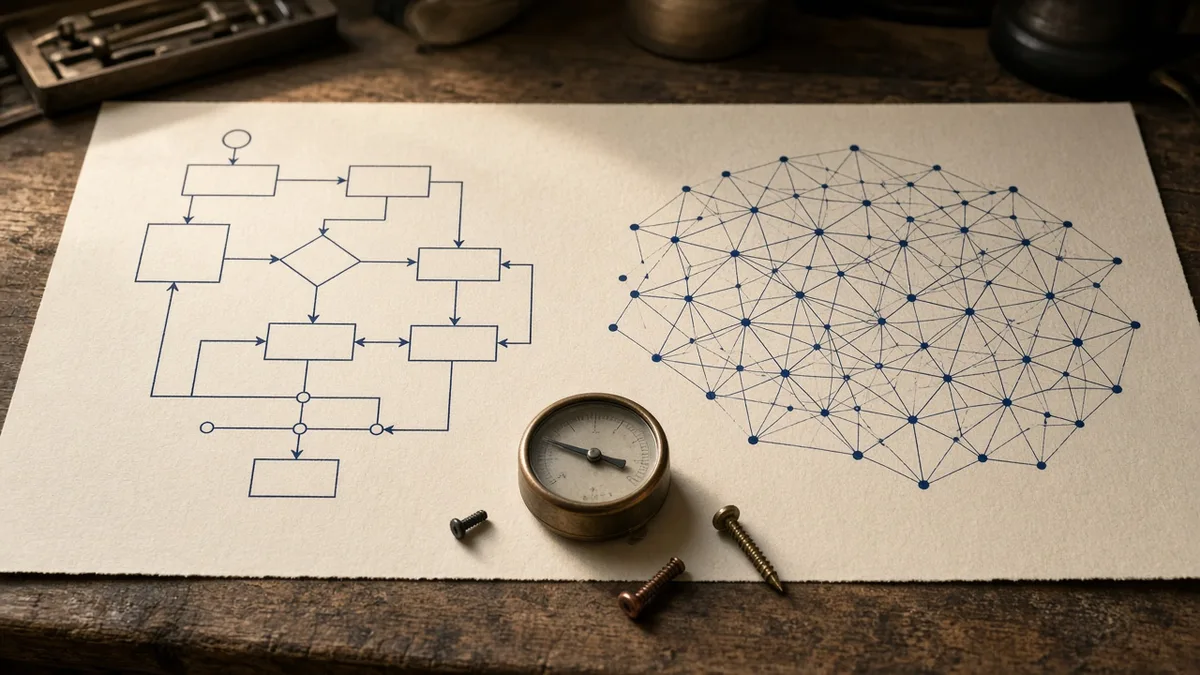
На стіні майстерні висить аркуш із процедурою. Щоб перевірити, чи число просте, діліть його на кандидатів аж до квадратного кореня. Хто вміє читати аркуш, отримає ту саму відповідь на тому самому числі. Поруч робочий стіл. На ньому рама, стос аркушів із рукописними цифрами і калібр. Раму підкручують гвинтами. Калібр показує, наскільки поточне налаштування промахується повз підпис на аркуші. Гвинти крутять, доки стрілка не піде вниз.
Дві задачі ставлять поряд частіше, ніж варто. Написати функцію, яка каже, чи число просте. Зібрати систему, яка впізнає рукописну цифру, хоча ніхто не перелічив усі способи написати сімку. В обох випадках на виході обчислювальна система. Відрізняється шлях, яким у неї з'являється поведінка.
У першому випадку поведінку записано кроками. У другому ви задаєте раму можливих обчислень, приклади, критерій помилки і процедуру, яка підбирає числові параметри. Навчання при цьому не скасовує програмування і не породжує окремий розум. Воно змінює предмет роботи. Поруч із текстом програми з'являється процес, який формує параметри, а разом із ними і здатності системи.
Аркуш на стіні і стіл із калібром далі означатимуть одне й те саме. Аркуш тримає явно заданий алгоритм. Стіл тримає архітектуру, дані і критерій, за яким підбирають параметри. Положення гвинтів тримає збережений стан навченої моделі.
Ключові висновки
Навчена модель лишається обчислювальною системою всередині програми. Її поведінка складається з архітектури, даних, критерію помилки і підібраних параметрів. Вихідний текст при цьому часто не змінюється.
Фраза «програма йде за правилами, модель учиться» надто груба. Програма може містити шматок, який навчають. Модель виконується програмним кодом. Порівнювати варто два способи зібрати поведінку. Взаємовиключними видами об'єктів вони не стають.
Узагальнення перевіряють на нових прикладах. Точність на відкладеній вибірці каже, як система поводилася на цих даних. Доказом правильності на кожен майбутній випадок вона не стає.
Ваги не читаються як енциклопедія і не замінюють документ, який можна цитувати. Параметри беруть участь у перетворенні входу. Конкретний факт із них дістається ненадійно. Там, де потрібні версія стандарту і номер пункту, поруч із моделлю стоять пошук за джерелами і звичайні перевірки в коді.
Розробник нікуди не зникає. Він обирає задачу і межу, за якою результат не можна випускати. Дані, архітектура і метрика входять у ту саму роботу. Для задач із відомим математичним розв'язком явний алгоритм зазвичай чесніший, дешевший і спокійніший за модель.
Просте число пишуть на аркуші, рукописну цифру підганяють на столі
Просте число більше за одиницю і не ділиться ні на що, крім одиниці і себе. Це означення вже містить алгоритм. Для невеликого n досить перевірити дільники від двійки до кореня з n.
def is_prime(n: int) -> bool:
    if n < 2:
        return False
    d = 2
    while d * d <= n:
        if n % d == 0:
            return False
        d += 1
    return True
За однакових вхідних даних і того самого оточення функція поводиться передбачувано. Помилки тут звичайні для програми: хибна умова, переповнення цілого, забутий випадок n < 2. Їх шукають тестом на відомих простих і складених числах. Для цієї задачі тест може бути вичерпним на потрібному діапазоні, бо правило повне.
Рукописна цифра влаштована інакше. Сімка буває з поперечкою і без, товста і тонка, похила, із плямою від ручки. Контур, вигин і пропорція швидко плодять винятки. Набір правил «якщо вертикальний штрих і верхня полиця, то це одиниця або сімка» ламається на наступному почерку. Аркуш на стіні розростається, а кожен новий автор почерку приносить випадок, якого на аркуші не було.
На столі працюють інакше. Беруть зображення і правильну мітку. Модель за поточними параметрами видає припущення. Рахують, наскільки воно розходиться з міткою. Параметри зсувають так, щоб розходження на цій порції прикладів зменшилося. Потім перевіряють зображення, яких у навчанні не було. Класичний навчальний набір рукописних цифр влаштований саме так: картинка і цифра-відповідь. Списку всіх допустимих розчерків там немає.
Один крок зручно побачити на конкретній сімці. Картинка потрапляє в мережу. На виході десять чисел, по одному на кожну цифру. Припустімо, на сімку припало мало, а на одиницю багато: модель зараз читає паличку і ігнорує поперечку. Функція втрат, часто це перехресна ентропія, дає великий штраф, бо правильна мітка отримала малу частку. Зворотний прохід показує, які параметри найдужче тягнули відповідь до одиниці. Крок оптимізації трохи зсуває саме їх. Наступна схожа сімка вже має шанс отримати більшу частку. Це все ще оптимізація штрафу на прикладах. Знання «як люди пишуть сімку» у файл само не записується окремим рядком.
Узагальнення тут головна властивість, і його легко переоцінити. Нові приклади можуть відрізнятися від навчальних. Добрий результат на відкладеній вибірці означає, що на цих аркушах система частіше влучає в мітку. Він не доводить, що наступну сімку, написану на мокрому папері іншою людиною, теж прочитають. Вступний курс Google із машинного навчання прямо розділяє помилку на навчальних даних і помилку на даних, які в підбір параметрів не входили. Друге і є практична перевірка узагальнення. Сертифікатом універсальної правильності вона не стає.
Людина з цієї роботи не випадає. Вона обирає задачу й архітектуру. Приклади, метрика і розбір помилок лишаються на ній. З аркуша, де перелічені всі випадки, робота переїжджає до проєктування процесу, який ці випадки має перетравити.
Той самий код, різна поведінка
Програмою у вузькому сенсі зручно називати текст, де логіку задано явно. Інструкції, умови, стани, обробка помилок. Розробник вирішує, що система зробить на кожному передбаченому вході. За фіксованих даних і оточення результат часто повторюється. Винятки трапляються і в програмах: евристика, випадковість, конфігурація, яка змінюється без нової збірки, код, який переписує власний стан. Передбачуваність часто супроводжує явний алгоритм. Законом природи вона не стає.
Модель у тому сенсі, про який тут ідеться, це навчена обчислювальна структура. У неї чотири робочі частини, і їх не варто склеювати в одне слово.
Архітектура задає, які операції система взагалі вміє виконувати. Скільки шарів, які зв'язки, який розмір входу, яка форма відповіді. Порожня рама на столі ще не впізнає цифри. Вона лише обмежує, якого роду обчислення всередині неї можливі.
Параметри, їх частіше називають вагами, утворюють числовий стан. Вони впливають на те, як вхід перетворюється на вихід. Однакова рама з різним положенням гвинтів дає різні відповіді. Файл ваг зберігає цей стан. Сам по собі файл нічого не виконує. Без коду архітектури, формату входу і процедури виводу це набір чисел.
Дані і функція втрат відповідають на питання, до чого система підлаштовується і за яким критерієм. Для цифри критерій зазвичай штрафує хибну мітку. Для іншої задачі критерій буде іншим. Алгоритм оптимізації каже, як саме рухати параметри, щоб штраф на навчальних прикладах зменшувався. Для шаруватих мереж градієнт за параметрами рахують зворотним проходом. Назва процедури тут важливіша за метафору. Іде оптимізація обраного критерію. Знання окремим рядком від цього не з'являються.
Окремо стоїть робочий застосунок. У ньому модель займає один вузол. Навколо чергу запитів, перевірка входу, журнали і запасний шлях, якщо модель мовчить або відповідає поза допустимим діапазоном. Плутати файл ваг із цим застосунком все одно що прийняти креслення рами за верстат, який уже стоїть у цеху.
Тому порівняння «програма йде за правилами, модель учиться» розсипається на першому ж гібриді. У коді сидить блок, який навчають. Модель викликають зі звичайної функції. Поруч база, набір правил і інструмент, який модель може попросити виконати. У розборі рівнів адаптації мовних моделей це видно на драбині. Попереднє навчання змінює параметри, пошук за документами підставляє джерело на час відповіді, а виклик зовнішнього інтерфейсу взагалі живе в програмі навколо моделі. Порівнювати має сенс способи зібрати поведінку. Об'єкти в промисловій системі майже завжди сидять в одному стеку.
Навчання крутить гвинти і не переписує аркуш
Після навчання вихідний текст часто той самий. Змінюється параметричний стан. Та сама архітектура на тих самих вхідних даних починає відповідати інакше, бо числа в перетворенні інші. Цей стан можна зберегти, завантажити і ганяти знову. Повторний запуск із тим самим файлом і тим самим кодом має дати ту саму відповідь на тому самому вході, якщо в процедурі виводу немає випадковості. Якщо відповідь поїхала, шукають розходження версії коду і ваг. Поруч дивляться попередню обробку й обладнання. Настрій моделі тут ні до чого.
Три картки допомагають не змішувати рівні. Перша картка, архітектура: опис рами і правил обчислення, зазвичай код. Друга, ваги: знімок налаштувань після навчання. Третя, робочий екземпляр: цей знімок виконується на конкретній машині, з конкретним форматом входу і конкретною процедурою виводу. Документація PyTorch проводить ту саму межу між означенням модуля, його параметрами і викликом модуля на даних. Доки немає третьої картки, слово «модель» ще не означає систему, яка приймає запити.
Однакова архітектура з різними вагами дає різні здатності. Одне налаштування читає цифри. Інше, у тій самій рамі, але після інших даних і іншого критерію, може робити сусідню задачу або не робити жодної. Звідси практичний наслідок для випуску. Версія поведінки складається з коду архітектури, файлу параметрів і підготовки входу. Номера коміту для цього мало.
Підготовка входу ламає пару тихіше, ніж люди чекають. Під час навчання картинку привели до одного розміру, відняли середнє і поклали канали в одному порядку. Під час виклику хтось забув віднімання або переставив канали. Архітектура та сама, файл ваг той самий, відповіді вже чужі. Шукати «псування моделі» в цьому місці марно. Звіряють ланцюжок до першого числа, яке потрапляє в мережу. Те саме з текстом мовної моделі: інший розбір на шматки й інший спеціальний знак на початку запиту змінюють вхід, хоча файл параметрів не чіпали.
Аркуш на стіні при цьому нікуди не дівся. Код навчання, цикл за прикладами, збереження файлу і завантаження перед запитом лишаються програмою. Навчання не замінює аркуш. Воно дописує до аркуша протокол, за яким стіл підбирає гвинти.
Цикл інженера зсувається з правки тексту на правку процесу
Класичний цикл на аркуші короткий і знайомий. Зібрати вимоги. Спроєктувати алгоритм. Реалізувати. Перевірити відомі випадки. Виправити текст, якщо випадок розійшовся з правилом. Для простого числа цей цикл чесний: ви змінюєте умову, і поведінка змінюється рівно там, де ви її записали.
Цикл на столі довший, і правка рідко починається з того рядка, який «помиливсь». Спершу формулюють задачу і метрику. Потім готують дані і відділяють шматок, на якому параметри підбирати не можна. Обирають архітектуру і функцію втрат. Рахують передбачення, помилку і крок оновлення параметрів. Дивляться відкладену вибірку. Наприкінці перевіряють незалежний набір, який не брав участі в рішеннях під час навчання. Якщо на навчальному наборі стрілка калібра пішла вниз, а на нових аркушах піднялася, це перенавчання. Налаштування запам'ятало навчальні аркуші замість закономірності, яка переноситься.
Інженер тут задає обмеження, критерій якості і механізм підбору. Алгоритм шукає параметри всередині цих рамок. У знайденому налаштуванні можуть сидіти закономірності, яких людина не виписувала по одній. Це не означає, що результат виник без проєкту. Рама, вибірка, штраф за помилку і правило зупинки лишаються рішеннями людини. Вдале налаштування не скасовує ці рішення. Воно їх виконує.
Що при цьому здобувають і що втрачають, краще сказати прямо. Здобувають задачі, де ручний перелік правил розвалюється. Почерк і шумна картинка. Поруч мовлення і чорновик формулювання за корпусом текстів. Втрачають прямий огляд кожного внутрішнього кроку і звичну впевненість, що хибну відповідь можна ткнути пальцем в один рядок умови. Натомість з'являються інші обов'язки. Дані треба збирати і перевіряти. Помилки треба дивитися розподілом, а не одним контрприкладом. Поведінку треба відтворювати: ті самі дані, той самий код, той самий порядок, якщо результат має повторитися. Після випуску треба помічати, що вхід поїхав відносно навчальної вибірки. Це і є зсув даних. Світ у запитах став іншим, а гвинти лишилися на старому налаштуванні.
Метрика, якій ви вірите на столі, окрема робота, не хвіст навчання. Як обирати показники для класифікації, зору, розпізнавання тексту і мовних моделей, розібрано в матеріалі про метрики якості нейромереж. Без цього розгалуження цикл на столі оптимізує не ту стрілку.
Повторити налаштування теж треба вміти, інакше слова «та сама модель» і те, що стоїть у цеху, розходяться. Зберігають знімок даних і код навчання. Поруч лежить файл параметрів і опис того, як вхід готували до мережі. Якщо хоча б одне з цього поїхало, стрілка калібра на нових аркушах уже про іншу систему. Для простого числа такого комплекту немає. Вистачає тексту функції і тесту на діапазоні. Для рукописної цифри комплект і є виріб.
Порівняння, яке не варто вважати стіною
Таблиця нижче описує типові випадки. Законом її вважати не варто. Евристична програма, імовірнісний алгоритм, правила зі шматком, який навчають і мережа всередині жорсткого конвеєра сидять між колонками. Читайте рядки як орієнтир, куди дивитися спершу.
| Критерій | Явний алгоритм | Навчена модель |
|---|---|---|
| Звідки береться поведінка | Здебільшого з тексту і правил | З архітектури, даних, процедури навчання і параметрів |
| Як змінюють поведінку | Правлять код, конфігурацію або вхід | Змінюють параметри, архітектуру, контекст або обв'язку |
| Нові випадки | Іде за записаним алгоритмом | Спирається на знайдені закономірності, якщо вони переносяться |
| Як перевіряють | Тести і, де можливо, доведення обмеженої властивості | Статистична оцінка і перевірка сценаріїв |
| Типовий збій | Помилка реалізації, хибна умова, хибна передумова | Погані дані, перекіс вибірки, слабке узагальнення, хибна відповідь |
| Залежність від даних | Буває малою | Часто вирішує підсумок |
| Як випускають нову версію | Новий текст або конфігурація | Новий файл параметрів, донавчання або інша архітектура |
| Наскільки видно будову | Залежить від того, як написано текст | Часто важко: внесок розмазано за параметрами |
Після таблиці корисно повернутися до простого числа і до цифри. Перевірка простоти добре лягає в ліву колонку: джерело логіки в означенні, нові числа обробляються тим самим правилом, помилку можна локалізувати. Читання почерку добре лягає в праву: джерело в прикладах і підборі, новий почерк не гарантований, помилку видно на вибірці. В одному рядку її не знайти. Промислова система частіше займає обидві колонки одразу. Модель пропонує читання цифри, а код поруч забороняє значення поза допустимим діапазоном приладу.
Чотири полиці, і жодна з них не свідомість
Слово «сутність» у розмові про моделі стрибає між сенсами. Іноді мають на увазі об'єкт, який можна назвати, зберегти і відрізнити від іншого об'єкта. Іноді мають на увазі систему, яка виконує клас задач. Іноді мають на увазі агента, який діє в середовищі. Іноді мають на увазі істоту з суб'єктивним досвідом. Перехід із полиці на полицю не відбувається сам. Збережений файл не стає агентом від того, що файл великий. Агент не стає носієм досвіду від того, що в нього є цикл дій.
У моделі в інженерній розмові чотири полиці, і їх краще тримати окремо.
На першій полиці опис: архітектура, код навчання, обраний критерій. Це ще рецепт, не екземпляр.
На другій полиці лежить збережений стан: параметри після навчання. Їх можна покласти в сховище, порахувати контрольну суму, відкотити.
На третій полиці робоча модель. Параметри виконуються на обладнанні й обробляють запити. Тут з'являються затримка і вартість виклику. Поруч відмова обладнання і розходження попередньої обробки з тим, що було під час навчання.
На четвертій полиці система або агент. Модель з'єднана з пам'яттю й інструментами. Поруч план кроків і канали, через які система бачить світ і діє. Доки цього контуру немає, модель відповідає на запит і зупиняється. Агент влаштований як петля. Він дивиться на результат, обирає дію і отримує новий результат. Автономність такої петлі задають повноваження і заборони всієї системи. Характер файлу ваг тут ні до чого. Як цю петлю збирають у корпоративному контурі, розібрано в статті про агентів.
Функціональну самостійність описують скупо. Система приймає вхід. У неї є внутрішній стан. Вона обирає варіант відповіді або дії з кількох. Їй доступні інструменти, і вона може змінювати зовнішній стан. Є зворотний зв'язок і оцінка результату. Такий об'єкт щось робить без покрокової вказівки на кожен клік. Бажання і суб'єктивний досвід із цього списку не випливають. Плутати полиці тут дорого. Зв'язна відповідь не означає бажання. Текст без джерела не можна класти в акт.
Ваги не читаються як довідник
Інформацію тримають по-різному, і спосіб зберігання задає, що з нею можна зробити.
Документ зберігає явні твердження. Пункт стандарту можна відкрити, процитувати і звірити з номером версії. База зберігає структуровані записи: одиниця виміру, діапазон, дата. Код задає операції і заборони. Якщо тиск поза діапазоном, розрахунок не триває. Параметри моделі беруть участь у перетворенні входу. Закономірність у них може бути розмазана за багатьма числами. Одне поняття не мусить збігатися з однією вагою або одним шаром.
Тому ваги не можна читати як енциклопедію. Параметри впливають один на одного. Дістати з них конкретний факт важко і ненадійно. Модель може повторити знайомий шаблон, змішати відомості і впевнено помилитися. Дослідження інтерпретованості показують окремі зрозумілі шматки в деяких мережах і водночас упираються в те, що розподілене подання не дорівнює картці в каталозі. Звідси практична заборона. Не можна стверджувати, що у файлі ваг лежить точна копія навчальних документів. Навіть якщо модель переказує фрагмент, це не слід «сторінка 14, абзац 2», доки ви самі не дістали сторінку з джерела.
Засвоєна закономірність і перевірений факт розходяться. У джерелі лежить твердження. У параметрах може осісти статистичний слід цього твердження і сліди сусідніх текстів. На виході модель породжує формулювання. Перевіреним фактом формулювання стає після звірки. У момент генерації звірки ще немає.
Для промислової безпеки це видно на одному запиті. Припустімо, система допомагає читати технічні норми. Донавчання на предметних текстах може поліпшити словник і манеру відповіді. Воно не замінює пункт чинної версії документа: норми змінюються, а файл параметрів оновлюється окремим, дорогим кроком. Пошук за джерелами, влаштований як RAG, на час відповіді підставляє фрагмент і посилання. Звичайний код перевіряє одиниці, діапазони й обов'язкові умови. Фахівець підписує висновок, якщо помилка коштує дорого. Опора лише на «знання у вагах» тут ламається рівно там, де потрібні цитата, версія і простежуваність.
Коли донавчання доречне, а коли факти треба лишати зовні моделі, розібрано в нотатці про донавчання. Як зібрати пошук за документами так, щоб фрагмент і оцінка якості були частиною системи, показано в інженерному розборі RAG.
Коли аркуш на стіні чесніший за стіл
Класифікатор простих чисел можна навчити. На прикладах він часто влучить у відповідь. Парні числа, більші за двійку, він вивчить швидко: ознака груба і у вибірці часта. На непарному складеному числі, якого в навчальних аркушах не було, він має право помилитися, бо означення в нього немає. Є лише сліди вибірки. Функція з дільниками до кореня помиляється лише якщо зламано текст. Для задачі з відомим математичним розв'язком стіл із калібром виходить дорогим і менш надійним інструментом. Аркуш коротший, дешевший, і його простіше перевірити.
Інша крайність виглядає як рукописний вимір. У журналі лабораторії людина пише «12,4», і система має це прочитати. Правила про штрихи і петлі тримаються, доки почерк знайомий. Кома, схожа на крапку, змазана четвірка, цифра, що заїхала на лінійку, роздувають аркуш винятків. Тут доречний розпізнавач, навчений на таких зображеннях. Йому потрібні дані саме цього почерку і цього бланка, метрика помилки символа й окремий облік небезпечної помилки. Прочитати не той тиск гірше, ніж відмовитися і віддати аркуш людині. З чого починається така лабораторія для згорткових мереж і розпізнавання рядків, показано в першому уроці серії про CNN і CRNN.
Третій випадок збирає обидва інструменти. Асистент із технічних норм не зводиться до однієї моделі і не зводиться до одного пошуку. Модель допомагає сформулювати відповідь людською мовою предметної області. Пошук приносить фрагмент потрібної версії. Код перевіряє, що одиниці сходяться і число всередині діапазону. Людина ухвалює рішення, якщо від нього залежить безпека. Модель у цій збірці лишається компонентом архітектури. Архітектуру вона не замінює.
Звідси і список обмежень, без якого розмова про стіл із калібром перетворюється на рекламу. Вибірка може не відображати світ, який ви побачите. Розмітка може бути хибною. Налаштування може запам'ятати навчальні аркуші і розвалитися на нових. Внутрішню будову буває важко читати. Навчання і виклик коштують грошей і часу. Нова версія параметрів може тихо змінити поведінку за того самого інтерфейсу. Несподіваний вхід вибиває відповідь, якої не було в сценаріях перевірки. Генеративні моделі вигадують правдоподібний текст. У критичних ділянках потрібні спостереження, повторні перевірки і людина на рішенні. Якщо в задачі є точне формальне правило, його і треба писати на аркуші.
Розробник задає умови, за яких здатність з'являється
Складні властивості не завжди виписують поелементно. Іноді інженер задає структуру, обмеження і процес, а потрібна поведінка виходить як результат цього процесу. У машинного навчання ця ідея спільна з іншими інженерними ділянками, і на цьому схожість закінчується. Навчання лишається обчислювальною процедурою з обраним критерієм. Це не біологічна еволюція і не самовільна поява розуму. Аналогія допомагає побачити зсув роботи. Зайвого вона не доводить.
Зручно тримати в голові три рівні, не видаючи їх за історію галузі. На першому розробник пише алгоритм. На другому він збирає процес, у якому параметри підбираються за даними. На третьому модель працює разом із пам'яттю, інструментами, кодом і зворотним зв'язком і закриває задачу за кілька кроків. Рівні складаються. Третій не скасовує перший: перевірки діапазону як і раніше пише людина у звичайному коді.
Роль при цьому змінюється в конкретних діях. Замість переліку всіх почерків обирають показові аркуші. Замість ручної евристики на кожен вигин проєктують штраф і спосіб його міряти. Замість перевірки однієї гілки умови дивляться, на яких групах прикладів помилка зростає. Замість випуску лише тексту ведуть версії даних, параметрів і всього контуру, включно з попередньою обробкою. Головна навичка в цій роботі в тому, щоб поставити задачу так, щоб було видно, які дані її взагалі можуть нести. Далі обирають метод і дивляться, де система відмовляє, перш ніж вбудовувати її в контур, який можна зупинити.
Далі по цеху вже видно кілька напрямів, і жоден не обіцяє систему, яка сама собі ставить мету. Гібриди коду, моделей і баз знань стають звичайною збіркою. Оцінку і донавчання автоматизують там, де метрика вже узгоджена з людиною. Агенти викликають інструменти в межах виданих прав. Контур може підлаштовуватися під зворотний зв'язок, якщо цей зв'язок розмічений і обмежений. Версія моделі стає таким самим артефактом випуску, як версія коду. Автоматизація навчання і наявність власної мети розходяться. Перше вже інженерна практика. Друге з неї не випливає.
Як змінюється щоденна робота програміста, коли виробництво тексту дешевшає, розібрано в нотатці про програміста в добу ШІ. Як навколо моделі збирають платформу ширше за один чат, показано в матеріалі про корпоративну платформу. Як міряти такий контур так, щоб цифрі можна було вірити, розібрано в матеріалі про оцінку корпоративного ШІ.
Часті питання
Чим навчена модель відрізняється від програми?
Програма у вузькому сенсі задає поведінку текстом правил. Навчена модель задає поведінку архітектурою плюс параметрами, підібраними за даними і критерієм помилки. У промисловій системі модель майже завжди виконується всередині програми. Відмінність у способі отримати поведінку. З двох речей жодна не випадає з програмування.
Що таке навчена модель, якщо коротко?
Це архітектура, у якої параметри вже підлаштовані під приклади і обраний штраф за помилку, плюс домовленість про формат входу і процедуру виводу. Файл ваг без коду архітектури зберігає стан. Робочою системою він не стає.
Де зберігаються знання нейромережі?
Явні твердження лишаються в документах і базах. Код зберігає заборони й обчислення. У параметрах може осісти розподілений слід закономірностей із навчальних даних. Цей слід не можна відкрити як сторінку довідника і процитувати як джерело.
Що таке ваги?
Числові параметри, які впливають на перетворення входу на вихід. Навчання їх змінює. Однакова архітектура з іншими вагами може розв'язувати задачу інакше або не розв'язувати її. Ваги зберігають у файл і завантажують перед викликом.
Модель і алгоритм — це одне й те саме?
Алгоритм навчання лишається програмою, яка оновлює параметри. Навчена модель виходить, коли цю програму прогнали на даних. Алгоритм виводу застосовує вже знайдені параметри до нового входу. Слова стоять поруч і позначають різні речі.
Як нейромережа навчається на даних?
На прикладі рахують відповідь за поточними параметрами, порівнюють її з міткою через функцію втрат і зсувають параметри, щоб штраф зменшився. Для шаруватих мереж напрям зсуву дає зворотний прохід. Потім дивляться приклади, які в цей зсув не входили.
Коли звичайний алгоритм кращий за модель?
Коли правило відоме, повне і його можна перевірити. Простота числа, одиниці виміру, діапазон, обов'язкове поле, точна формула. Модель тут дорожча, гірше пояснюється і має право помилитися там, де текст правила не помилився б.
Модель — це вже агент?
Ні. Модель може видати відповідь на один запит і зупинитися. Агент лишається системою з петлею кроків, пам'яттю й інструментами. Їй дозволено змінювати зовнішній стан. Агентом модель стає лише в складі такої системи, і то в межах виданих прав.
Що почитати далі
Поруч на сайті вже є матеріали, які продовжують окремі полиці цієї статті.
- Як навчають мовні моделі: параметри, пошук за документами, інструменти
- Коли донавчання справді потрібне
- Промисловий пошук за документами
- Метрики якості нейромереж
- Лабораторія CNN і CRNN: з чого починається розпізнавання
- Чому корпоративному ШІ потрібні агенти
- Як оцінювати корпоративний ШІ
Короткі зовнішні опори, з якими варто звіряти терміни: вступний курс Google із машинного навчання (функція втрат, градієнтний спуск, узагальнення) і документація PyTorch про модулі та параметри.
Висновок
Програма і модель збираються в одну систему. Програма може описувати, як навчати. Модель виходить, коли цей протокол прогнали на даних і зберегли параметри. У робочому контурі вони майже завжди лежать разом: аркуш процедури, рама, гвинти, калібр і людина, яка вирішує, чи можна ставити це налаштування в цех.
Раніше ми здебільшого писали машині, як розв'язувати задачу. Тепер можемо спроєктувати процес, який витягує спосіб розв'язання з прикладів. Наступна інженерна робота в тому, щоб зробити такі системи перевірюваними, керованими і досить спокійними для конкретної ділянки.
Коментарі